AI Tech - 2026-05-28
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

LocateAnything: Fast and High-Quality Vision-Language Grounding with Parallel Box Decoding
기존 비전-언어 모델은 객체의 위치를 나타내는 박스를 순차적으로 생성하여 속도가 느렸습니다. ‘LocateAnything’은 박스의 좌표를 병렬로 한 번에 디코딩하는 새로운 방식을 제안하여, 기존 모델보다 훨씬 빠르고 정확하게 객체의 위치를 찾아내는 성능을 보여줍니다.

EvalVerse: Pipeline-Aware and Expert-Calibrated Benchmarking for Professional Cinematic Video Generation
최신 영상 생성 AI 모델의 성능 평가는 단순히 프롬프트 지시를 잘 따랐는지에만 초점이 맞춰져 있어, 영화적 품질이나 미학적 완성도를 측정하기 어려웠습니다. ‘EvalVerse’는 전문가의 평가 기준을 반영하여 연기, 미학 등 전문적인 영화 영상 품질을 종합적으로 측정할 수 있는 새로운 벤치마크 파이프라인을 제시합니다.

SpatialBench: Is Your Spatial Foundation Model an All-Round Player?
공간 정보를 처리하는 파운데이션 모델이 특정 데이터셋에서는 뛰어난 성능을 보이지만, 다양한 실제 환경에서도 강건하게 작동하는지는 불분명했습니다. ‘SpatialBench’는 다양한 과제, 시점, 환경 변화 속에서 모델의 일반화 성능을 종합적으로 평가하여, 모델이 다재다능한 ‘올라운드 플레이어’인지 검증하는 새로운 벤치마크입니다.

MobileGym: A Verifiable and Highly Parallel Simulation Platform for Mobile GUI Agent Research
모바일 GUI 환경에서 AI 에이전트를 연구하는 것은 결과 검증이 어렵고 대규모 병렬 시뮬레이션이 힘들다는 한계가 있었습니다. ‘MobileGym’은 브라우저에서 실행되는 경량 시뮬레이션 플랫폼으로, 구조화된 JSON 상태를 통해 결과를 명확히 검증하고 대규모 병렬 학습을 지원하여 모바일 에이전트 연구의 확장성을 크게 높입니다.

Geometry-Aware Representation Denoising for Robust Multi-view 3D Reconstruction
여러 장의 사진으로 3D 모델을 복원하는 기술은 깨끗한 이미지에서는 잘 작동하지만, 노이즈나 흐림 등 저하된 실제 이미지에서는 성능이 크게 떨어지는 문제가 있었습니다. 이 연구는 기하학적 정보에 특화된 노이즈 제거 기술을 제안하여, 품질이 낮은 입력 이미지에서도 강건하게 3D 모델을 복원할 수 있는 새로운 방법을 제시합니다.
Hugging Face Blog
LocateAnything: Fast and High-Quality Vision-Language Grounding with Parallel Box Decoding
기존 비전-언어 모델은 객체 위치를 찾을 때 좌표를 순차적으로 생성하여 추론 속도가 느린 단점이 있었습니다. ‘LocateAnything’은 병렬 박스 디코딩(Parallel Box Decoding)이라는 새로운 방식을 도입하여 좌표를 동시에 생성함으로써, 더 빠르고 높은 품질의 시각적 그라운딩 및 탐지를 가능하게 합니다.
SpatialBench: Is Your Spatial Foundation Model an All-Round Player?
‘SpatialBench’는 공간 지능 파운데이션 모델이 특정 데이터셋을 넘어 다양한 관점, 장면, 하드웨어 제약 등에서 얼마나 범용적으로 성능을 발휘하는지 종합적으로 평가하기 위해 제안된 벤치마크입니다. 이를 통해 모델이 다재다능한 ‘올라운드 플레이어’인지 실질적인 일반화 능력을 검증할 수 있습니다.
MUSE-Autoskill: Self-Evolving Agents via Skill Creation, Memory, Management, and Evaluation
기존 LLM 에이전트의 스킬은 고정되어 있어 장기적인 개선이 어려웠지만, ‘MUSE-Autoskill’은 에이전트가 스스로 스킬을 생성, 재사용, 개선하는 새로운 프레임워크입니다. 이 모델은 스킬의 생성부터 관리, 평가까지 통합된 생명주기를 통해 에이전트가 지속적으로 문제 해결 능력을 발전시키도록 돕습니다.
GitHub Trending
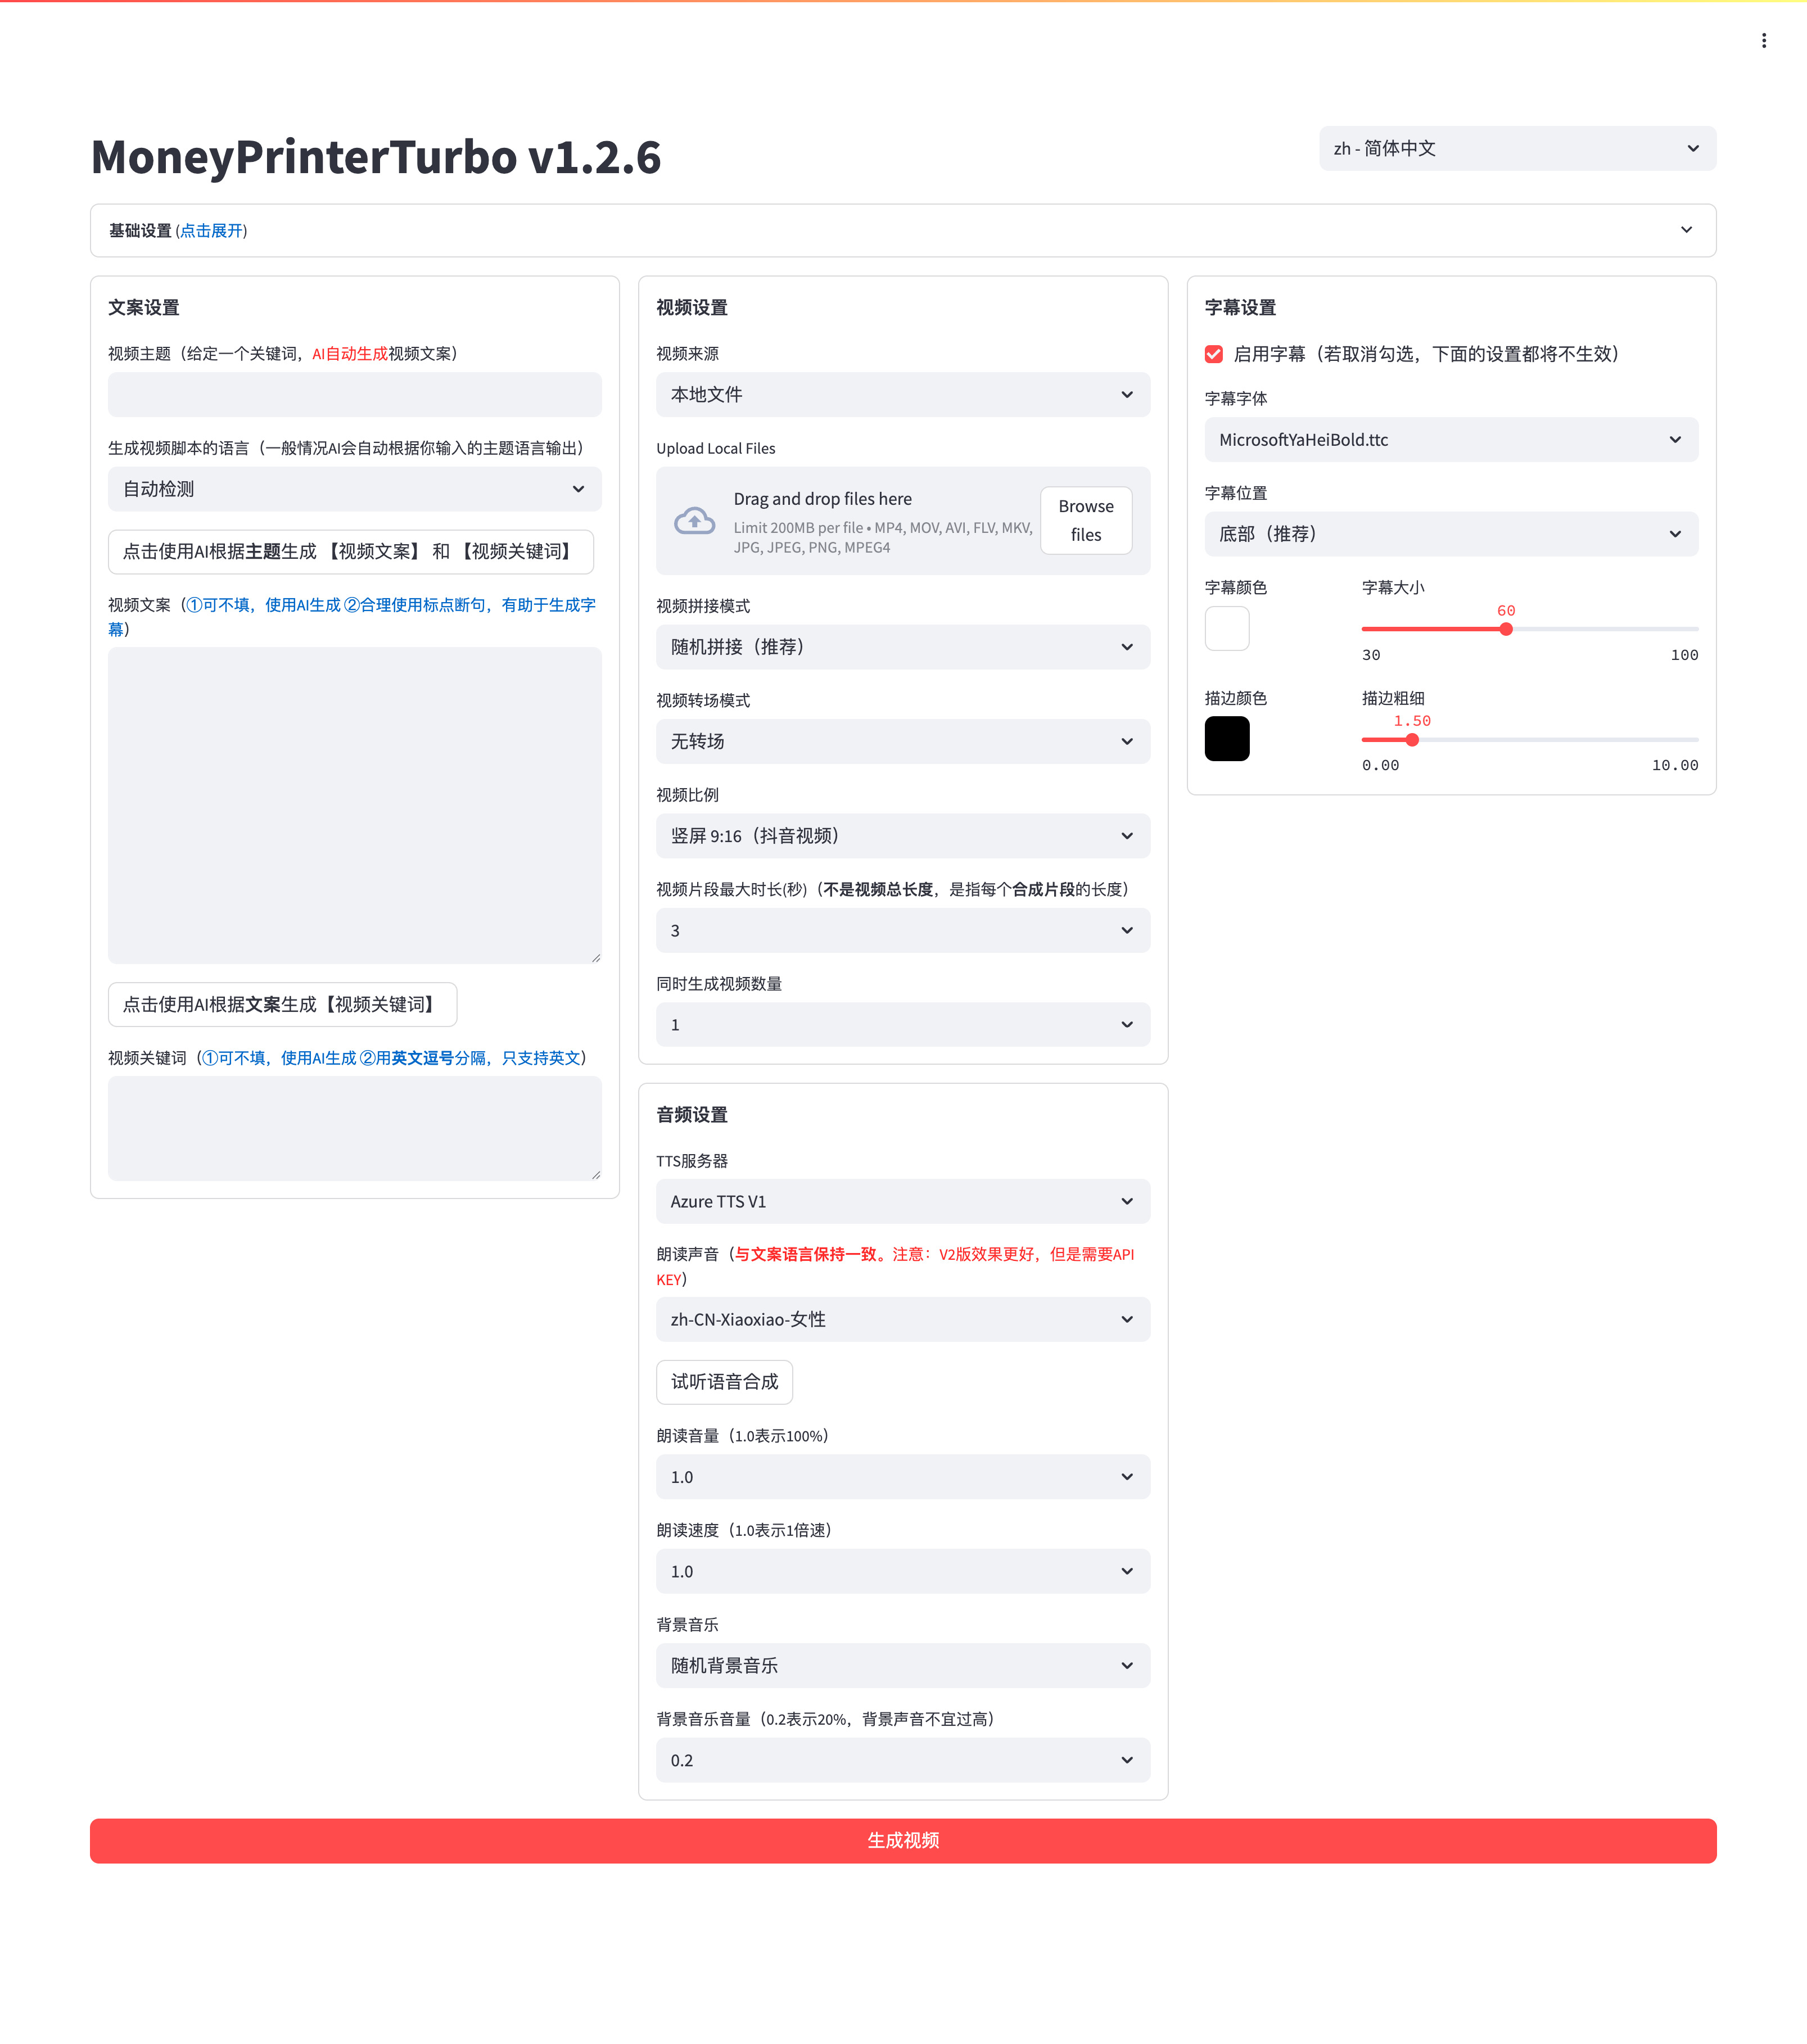
harry0703/MoneyPrinterTurbo
이 프로젝트는 AI 대규모 언어 모델(LLM)을 활용하여 클릭 한 번으로 고화질의 짧은 동영상을 생성하는 도구입니다. 사용자는 복잡한 과정 없이 손쉽게 비디오 콘텐츠를 제작할 수 있습니다.
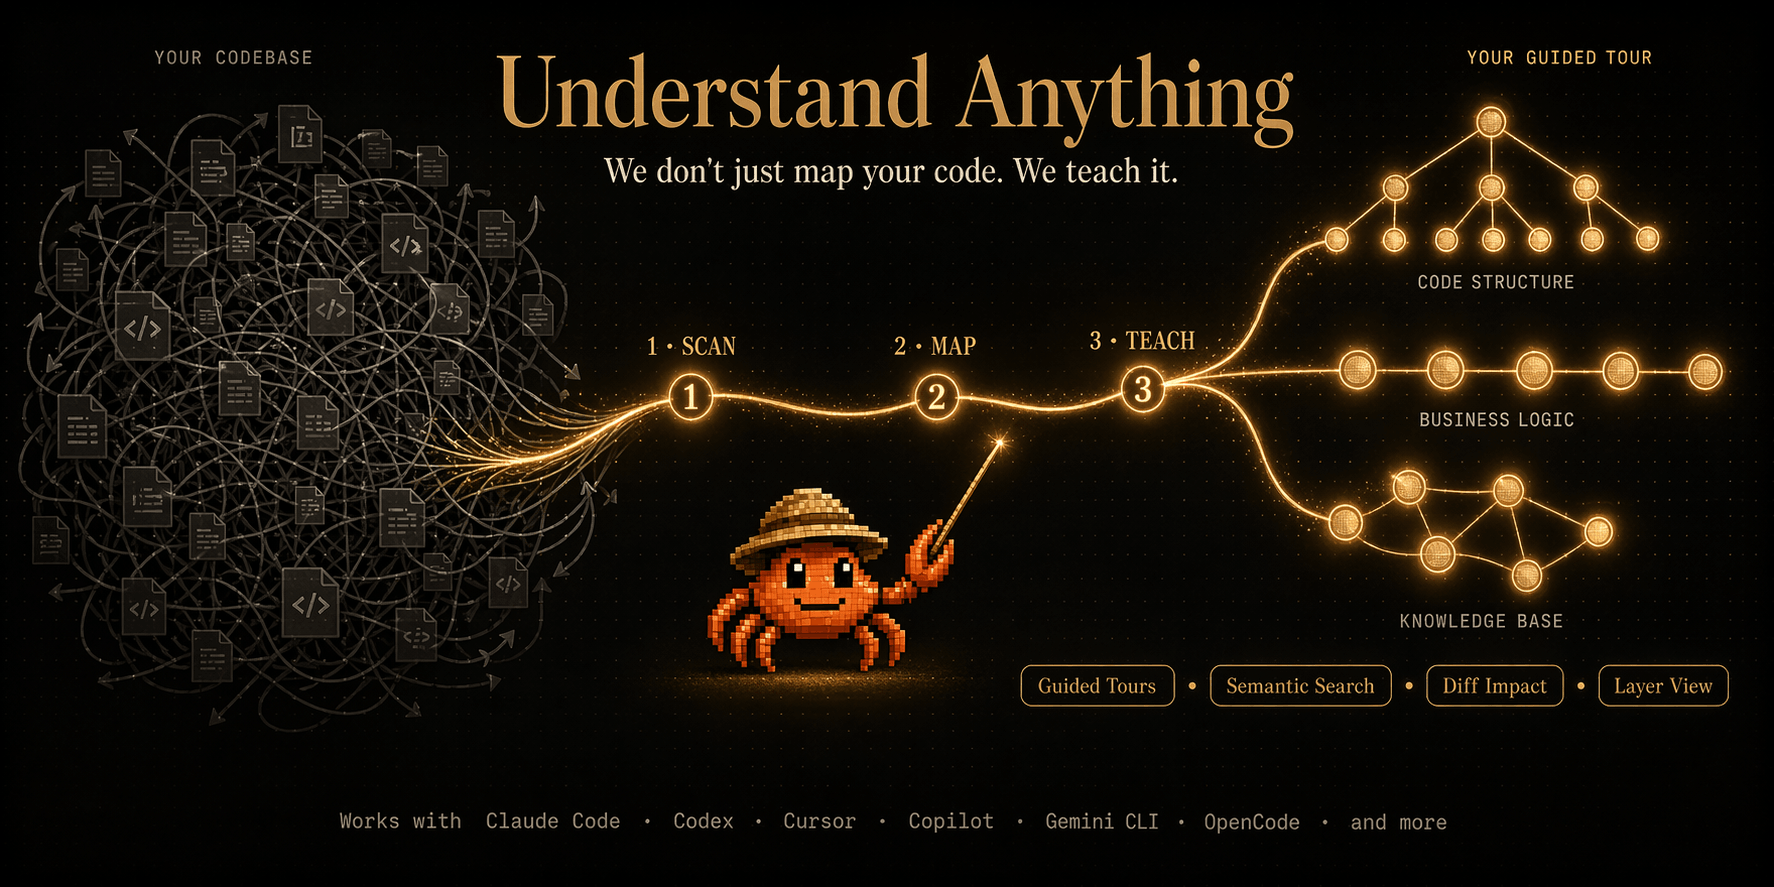
Lum1104/Understand-Anything
이 도구는 어떤 코드든 탐색, 검색, 질문이 가능한 대화형 지식 그래프로 변환해 줍니다. 화려함보다는 실제 학습과 이해에 초점을 맞춘 그래프를 생성하며, Claude나 Copilot 등 다양한 AI 도구와 연동하여 코드 분석을 돕습니다.
hardikpandya/stop-slop
AI가 생성한 글에서 인공지능 특유의 문체나 표현을 제거해 주는 스킬 파일입니다. 이 도구를 사용하면 AI가 작성한 산문을 더욱 자연스럽고 사람처럼 보이도록 다듬을 수 있습니다.
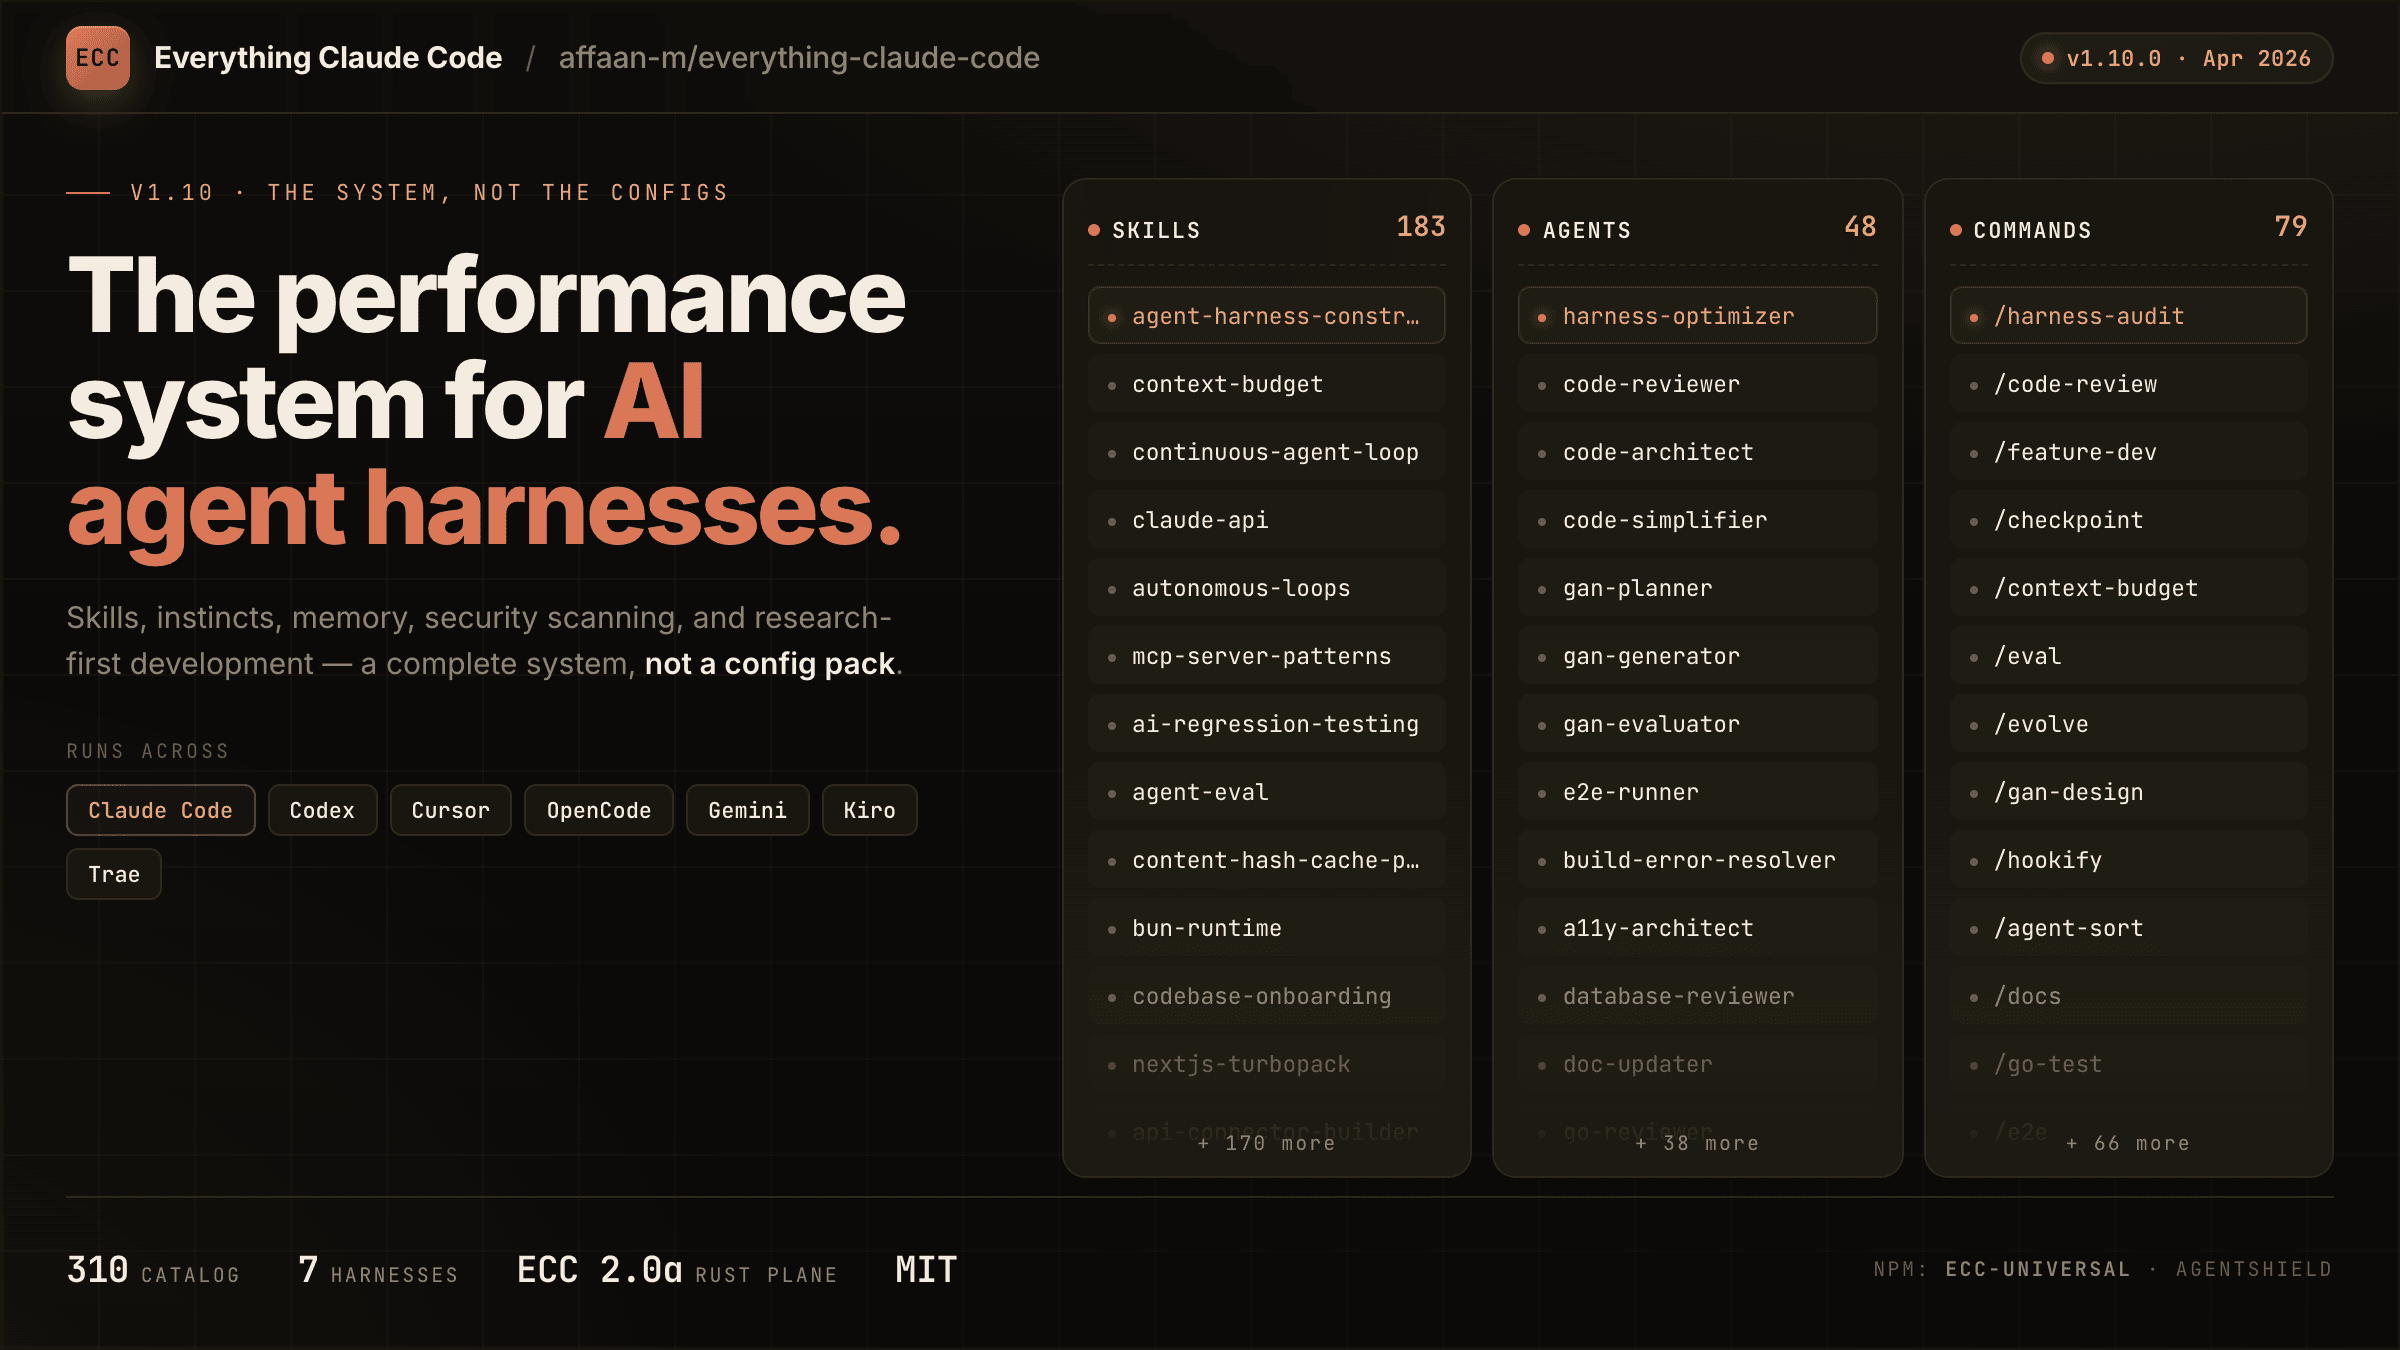
affaan-m/ECC
AI 에이전트의 성능을 최적화하기 위한 시스템으로, 다양한 AI 코딩 도구의 성능 향상을 목표로 합니다. 기술, 메모리, 보안 등의 요소를 통합하여 에이전트의 능력을 극대화하고, 연구 중심의 개발 방식을 채택한 것이 특징입니다.
anthropics/knowledge-work-plugins
지식 노동자를 위해 만들어진 오픈소스 플러그인 저장소입니다. 이 플러그인들은 주로 앤트로픽의 Claude Cowork 환경에서 사용되도록 개발되어, 다양한 전문 작업을 효율적으로 처리할 수 있도록 돕습니다.
AI Weekly
AI Weekly Issue #496: Anthropic's Pentagon model is now everyone's model
앤스로픽이 이전까지 국방부 계약자 등 특정 그룹에만 제공되던 고성능 AI 모델 ‘미소스(Mythos)’를 일반에 공개하여 최첨단 AI 기술의 접근성을 크게 넓혔습니다. 이와 함께 딥마인드의 데미스 하사비스는 AGI(일반인공지능)의 실현 가능 시점을 2029년으로 앞당겨 예측하며 AI 기술 발전의 빠른 속도를 시사했습니다.
오늘의 키워드
Vision Grounding Inference Agent Prompt Eval LLM Claude Knowledge Graph Cursor