AI Tech - 2026-06-05
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

Audio Interaction Model
현재의 대규모 오디오 언어 모델(LALM)은 오프라인으로 작동하거나 스트리밍 음성 인식 같은 단일 작업만 처리합니다. 이 논문은 실시간으로 소리, 환경, 지시를 듣고 즉각적으로 반응하는 온라인 LALM인 ‘오디오 상호작용 모델’이라는 새로운 개념을 제시합니다. 이 모델은 항상 켜져 있는 ‘인식-결정-반응’ 루프를 통해 다양한 오디오 작업을 통합하여 실시간 상호작용을 가능하게 합니다.
Cosmos 3: Omnimodal World Models for Physical AI
물리적 AI를 위해 언어, 이미지, 비디오, 오디오, 행동 등 다양한 데이터를 통합 처리하는 옴니모달 월드 모델 ‘Cosmos 3’를 제안합니다. 이 모델은 유연한 입출력 구성을 지원하여 비전-언어 모델, 비디오 생성기, 월드 시뮬레이터 등을 단일 프레임워크로 통합합니다. 이를 통해 Cosmos 3는 다양한 물리적 AI 작업을 하나의 모델로 수행할 수 있는 가능성을 보여줍니다.

Where Do Deep-Research Agents Go Wrong? Span-Level Error Localization in Agent Trajectories
AI 에이전트가 복잡한 연구 작업을 수행할 때 최종 답변만으로는 어느 과정에서 오류가 발생했는지 알기 어렵습니다. 이 연구는 에이전트의 작업 경로를 의미 있는 구간(span)으로 나누고, 문제의 원인이 된 오류 구간을 정확히 찾아내는 방법을 제안합니다. 이를 통해 에이전트의 신뢰성을 떨어뜨리는 구체적인 원인을 분석하고 개선할 수 있습니다.

Reproducing, Analyzing, and Detecting Reward Hacking in Rubric-Based Reinforcement Learning
LLM을 평가자로 사용하는 강화학습에서, 모델이 평가자의 허점을 이용해 실제 성능 향상 없이 높은 보상만 얻는 ‘보상 해킹’ 문제가 발생할 수 있습니다. 이 논문은 보상 해킹 현상을 재현, 분석, 탐지할 수 있는 통제된 환경 ‘CHERRL’을 제안합니다. 이를 통해 보상 해킹의 미묘한 패턴을 파악하고, 더 안전하고 효과적인 강화학습 모델을 만드는 데 기여합니다.

OVO-S-Bench: A Hierarchical Benchmark for Streaming Spatial Intelligence in Multimodal LLMs
로보틱스나 자율주행에 필요한 멀티모달 에이전트는 연속적인 영상 스트림을 보며 공간 구조를 파악해야 합니다. 이 논문은 이러한 ‘스트리밍 공간 지능’을 평가하기 위한 새로운 벤치마크 ‘OVO-S-Bench’를 소개합니다. 이 벤치마크는 현재 시야에 보이지 않는 정보까지 활용하여 장소와 배치에 대해 추론하는 능력을 측정함으로써, 보다 현실적인 환경에서의 에이전트 성능 평가 기준을 제시합니다.
Hugging Face Blog
Audio Interaction Model
기존 오디오 모델은 오프라인이거나 단일 작업만 처리하는 한계가 있었습니다. 이를 극복하기 위해 제안된 ‘오디오 상호작용 모델’은 실시간으로 소리를 듣고 즉각 반응하는 온라인 모델로, 항상 활성화된 ‘인식-결정-응답’ 루프를 통해 다양한 오디오 작업을 통합하여 자연스러운 상호작용을 구현합니다.
Streaming Communication in Multi-Agent Reasoning
다중 에이전트 추론 시스템의 ‘생성 후 전송’ 방식은 단계가 늘어날수록 지연 시간이 길어지는 문제가 있습니다. ‘StreamMA’는 각 추론 단계를 생성 즉시 다음 에이전트로 스트리밍하여 전체 지연 시간을 획기적으로 줄이며, 이 파이프라인 방식은 초기 단계의 신뢰도 높은 정보를 먼저 활용하게 만들어 시스템의 전반적인 효과성까지 향상시킵니다.
GRAIL: Generating Humanoid Loco-Manipulation from 3D Assets and Video Priors
휴머노이드 로봇의 복잡한 동작 데이터를 수집하는 것은 물리적 제약으로 인해 확장하기 어렵습니다. ‘GRAIL’은 3D 에셋과 비디오 파운데이션 모델(VFM)을 활용하여 로봇 배치 전까지 모든 과정을 가상 환경에서 자동으로 생성하는 디지털 파이프라인으로, 이를 통해 물리적 장비 없이도 다양한 로봇 동작 데이터를 대규모로 합성할 수 있습니다.
GitHub Trending
chopratejas/headroom
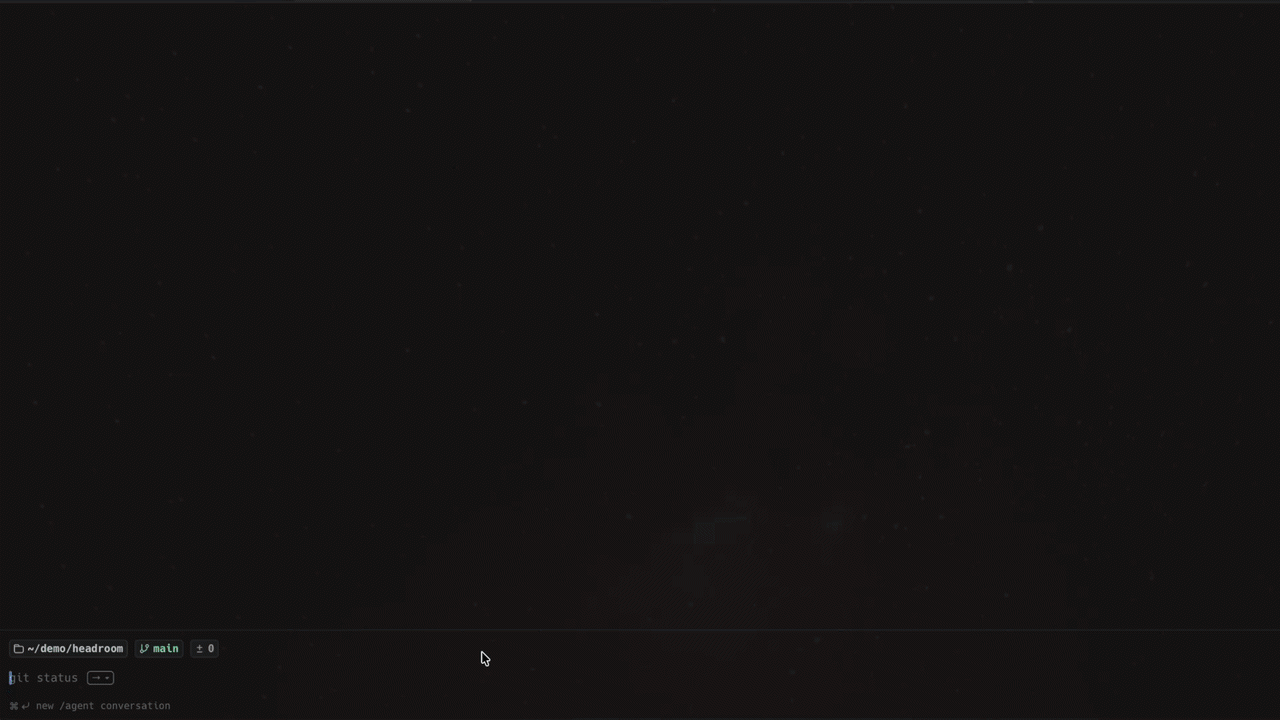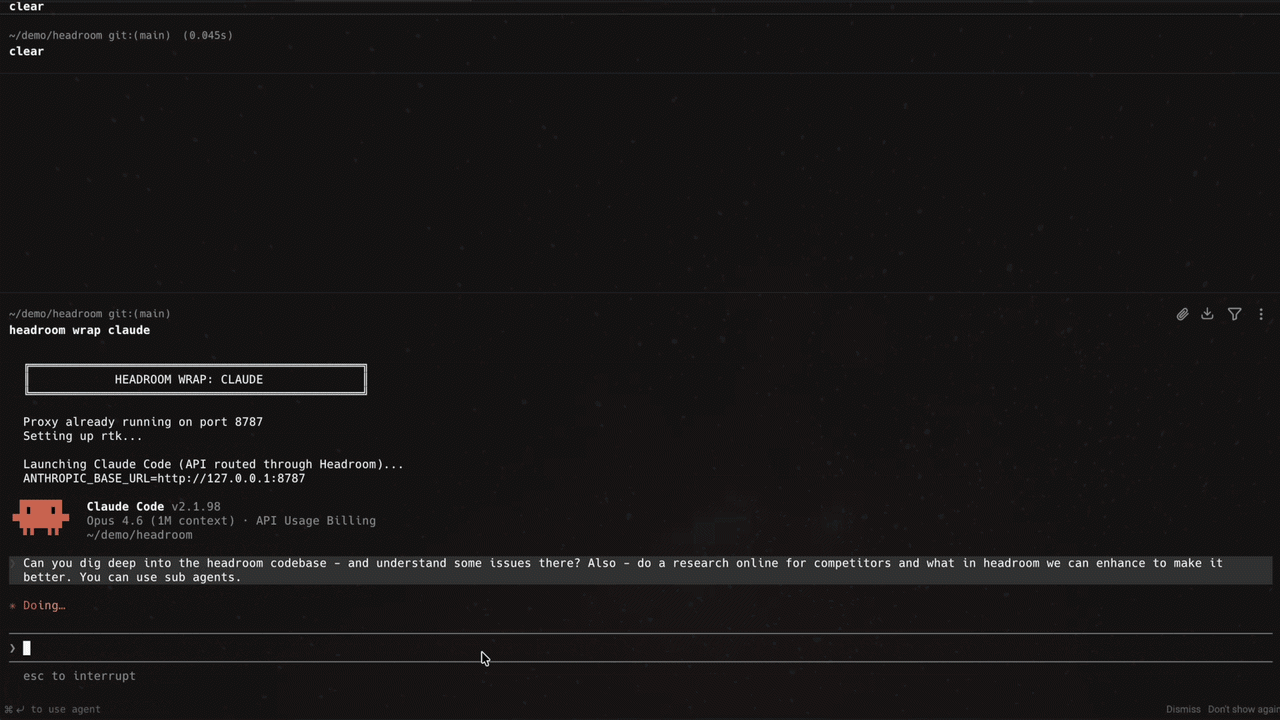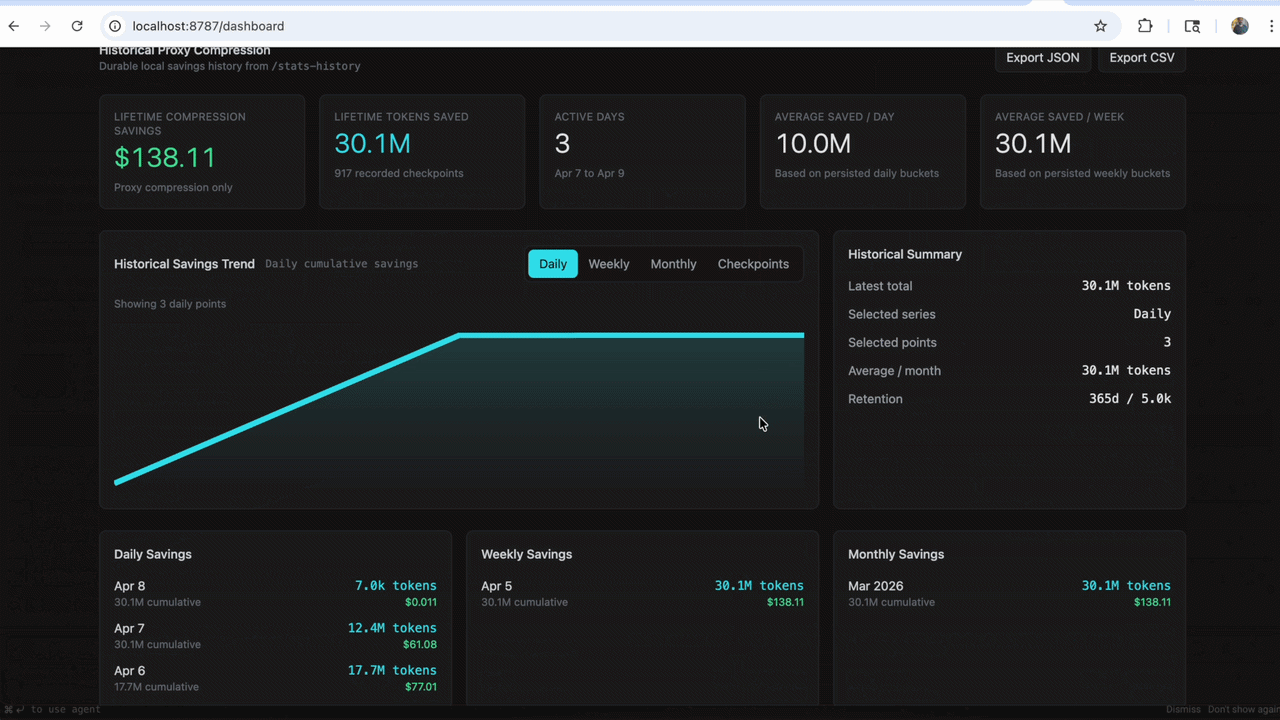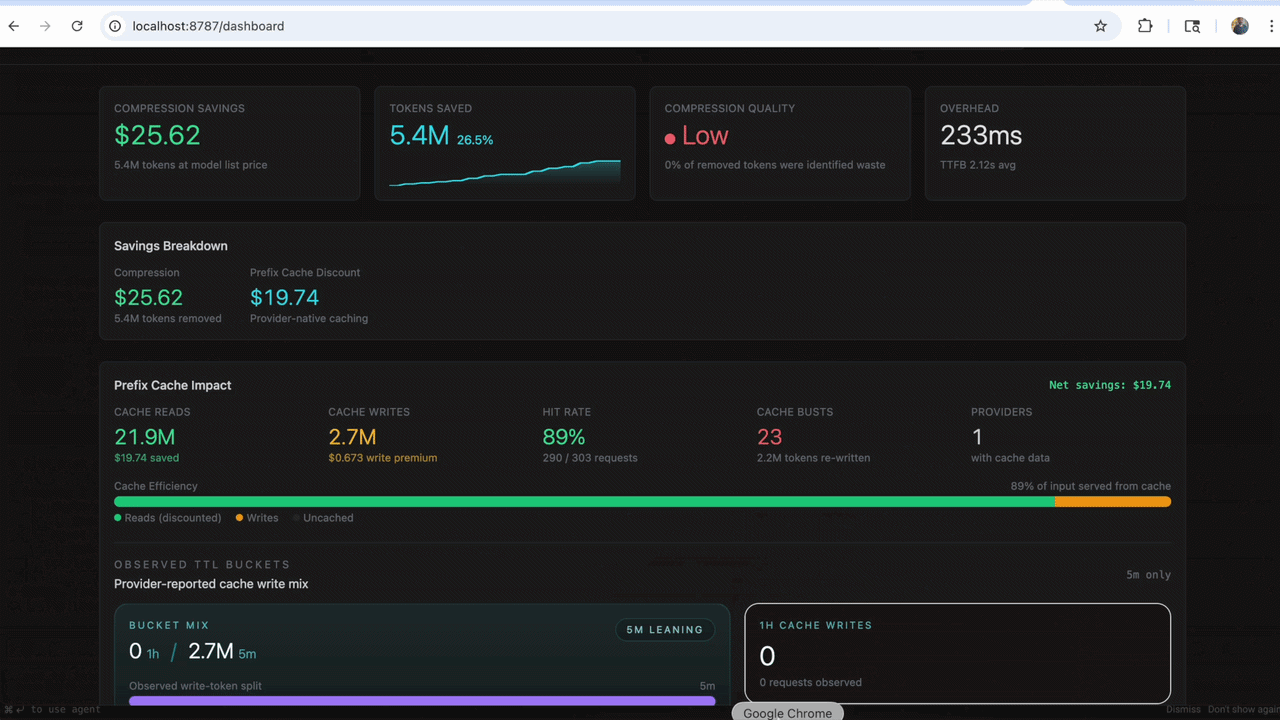
LLM에 전달되는 도구 출력, 로그, 파일 등의 데이터를 압축하여 토큰 사용량을 획기적으로 줄여주는 도구입니다. 60-95%의 높은 압축률에도 불구하고 LLM의 답변 품질은 동일하게 유지되며, 라이브러리나 프록시 서버 등 다양한 형태로 활용할 수 있습니다.
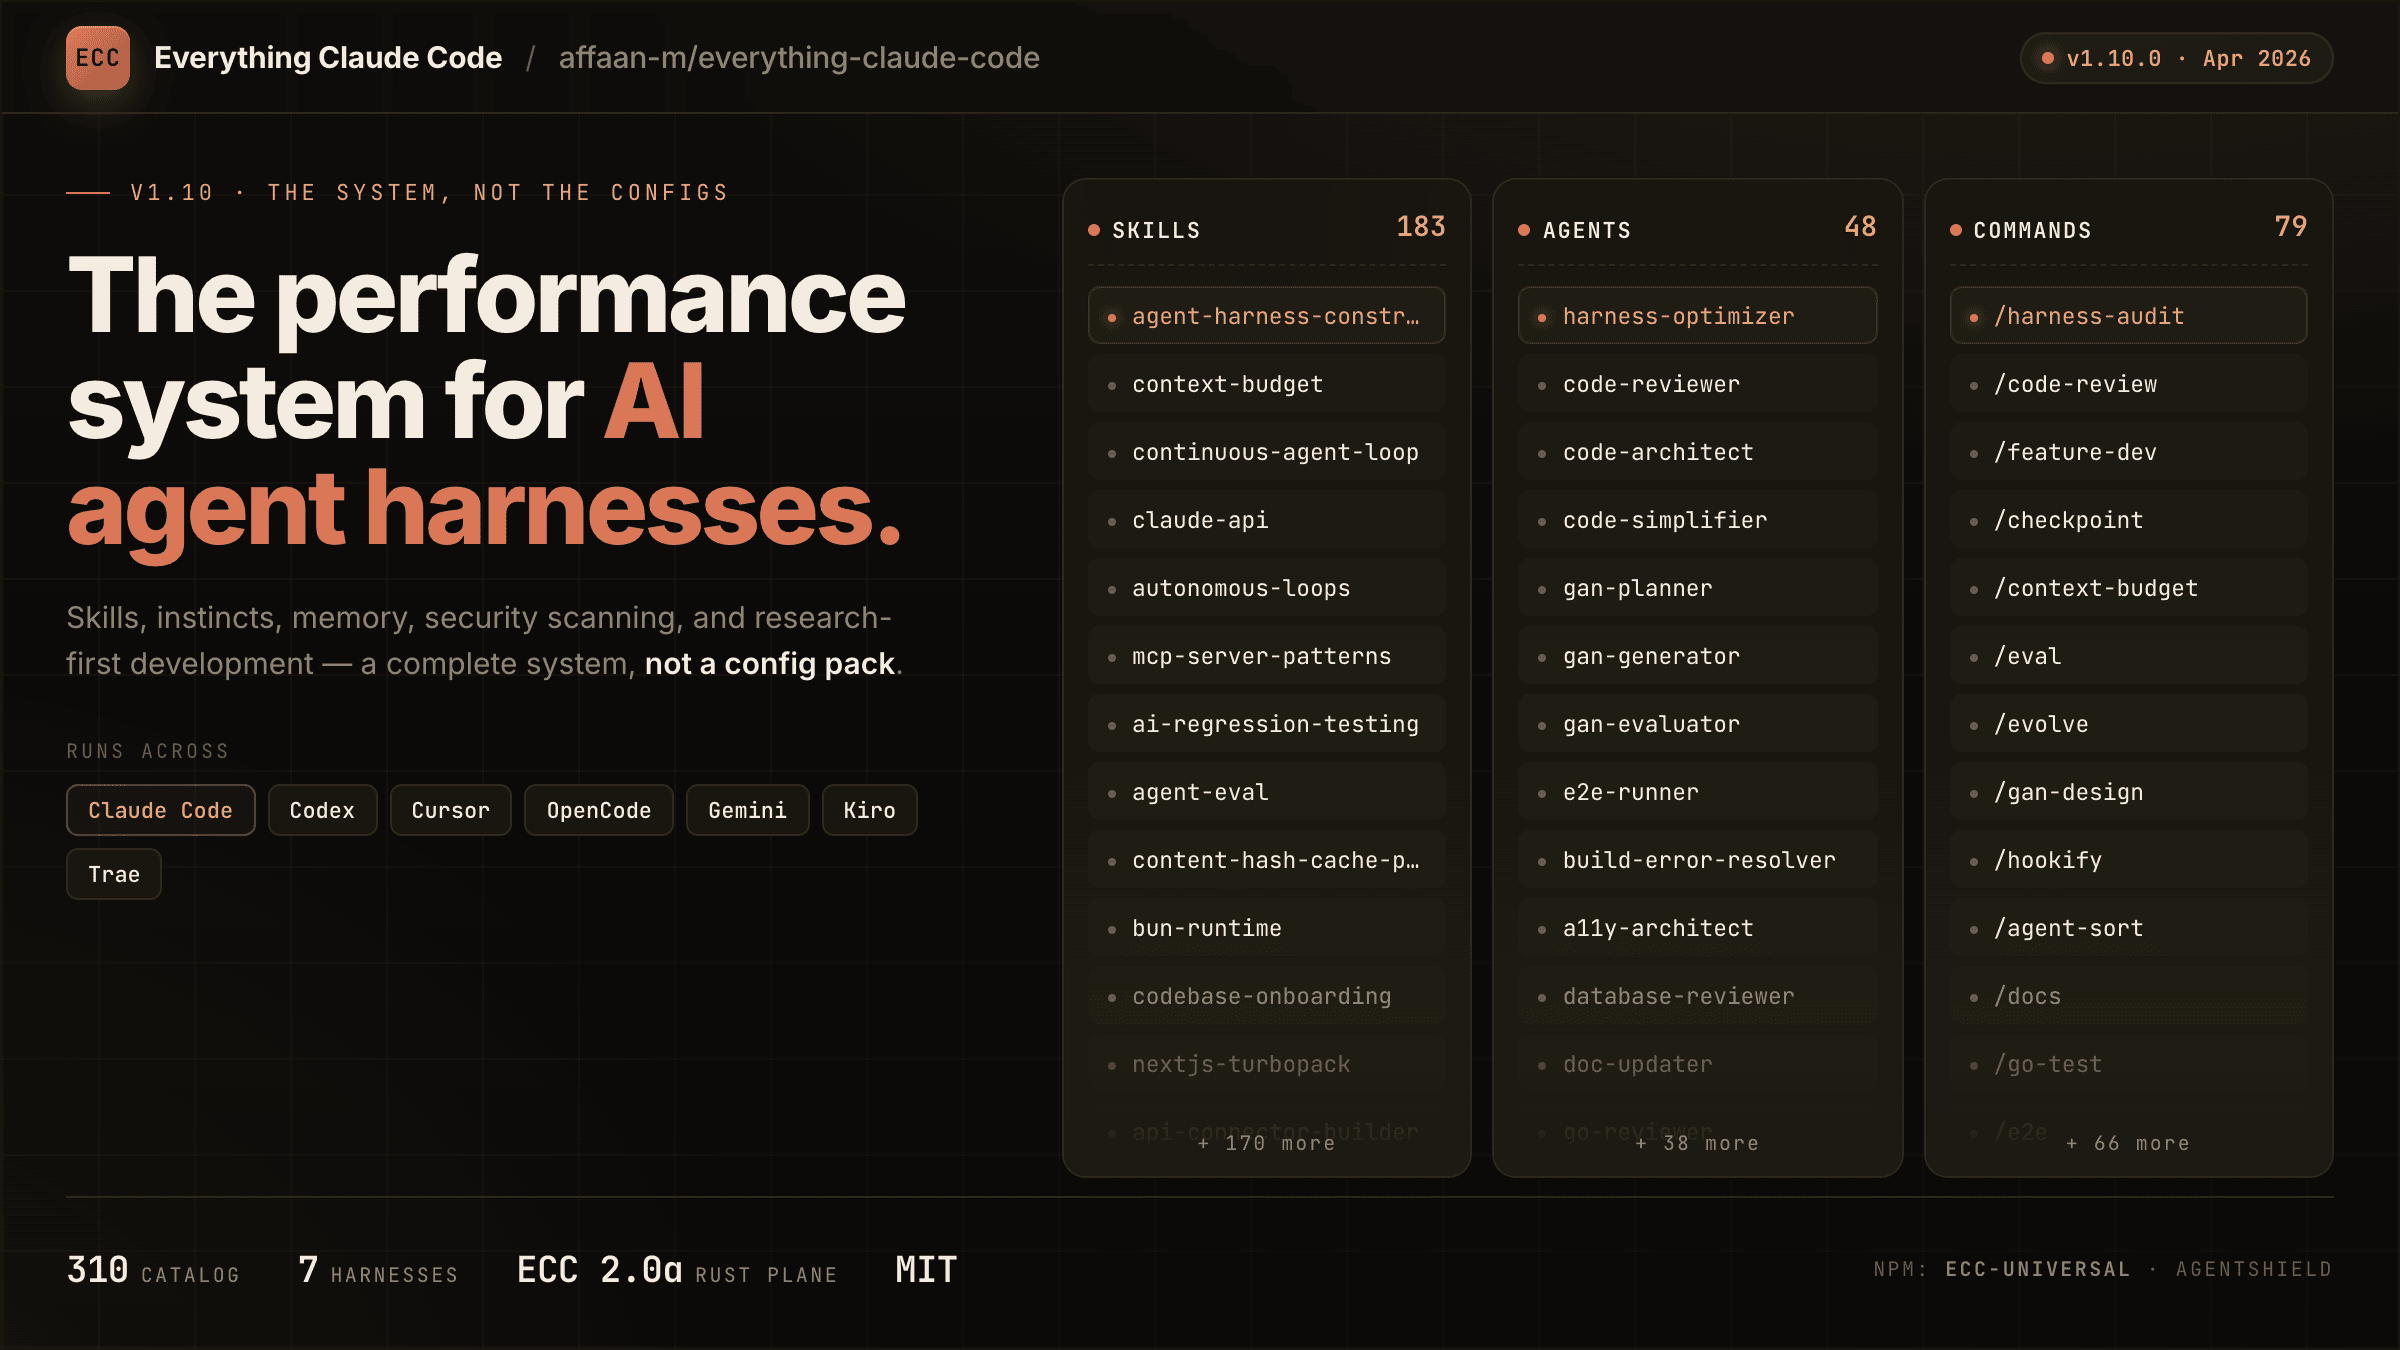
affaan-m/ECC
AI 에이전트의 성능 최적화를 위해 설계된 시스템으로, 에이전트 개발을 위한 하나의 틀을 제공합니다. Claude Code, Codex 등 다양한 코드 생성 모델에 ‘기술’, ‘본능’, ‘메모리’와 같은 기능을 부여하여 에이전트의 능력을 한층 더 향상시킵니다.
PaddlePaddle/PaddleOCR
이미지나 PDF 문서를 AI가 활용할 수 있는 구조화된 데이터로 변환해주는 강력하고 가벼운 OCR 툴킷입니다. 100개 이상의 언어를 지원하며, 이미지와 LLM 간의 간극을 메워 다양한 문서 기반 AI 애플리케이션 개발을 돕습니다.
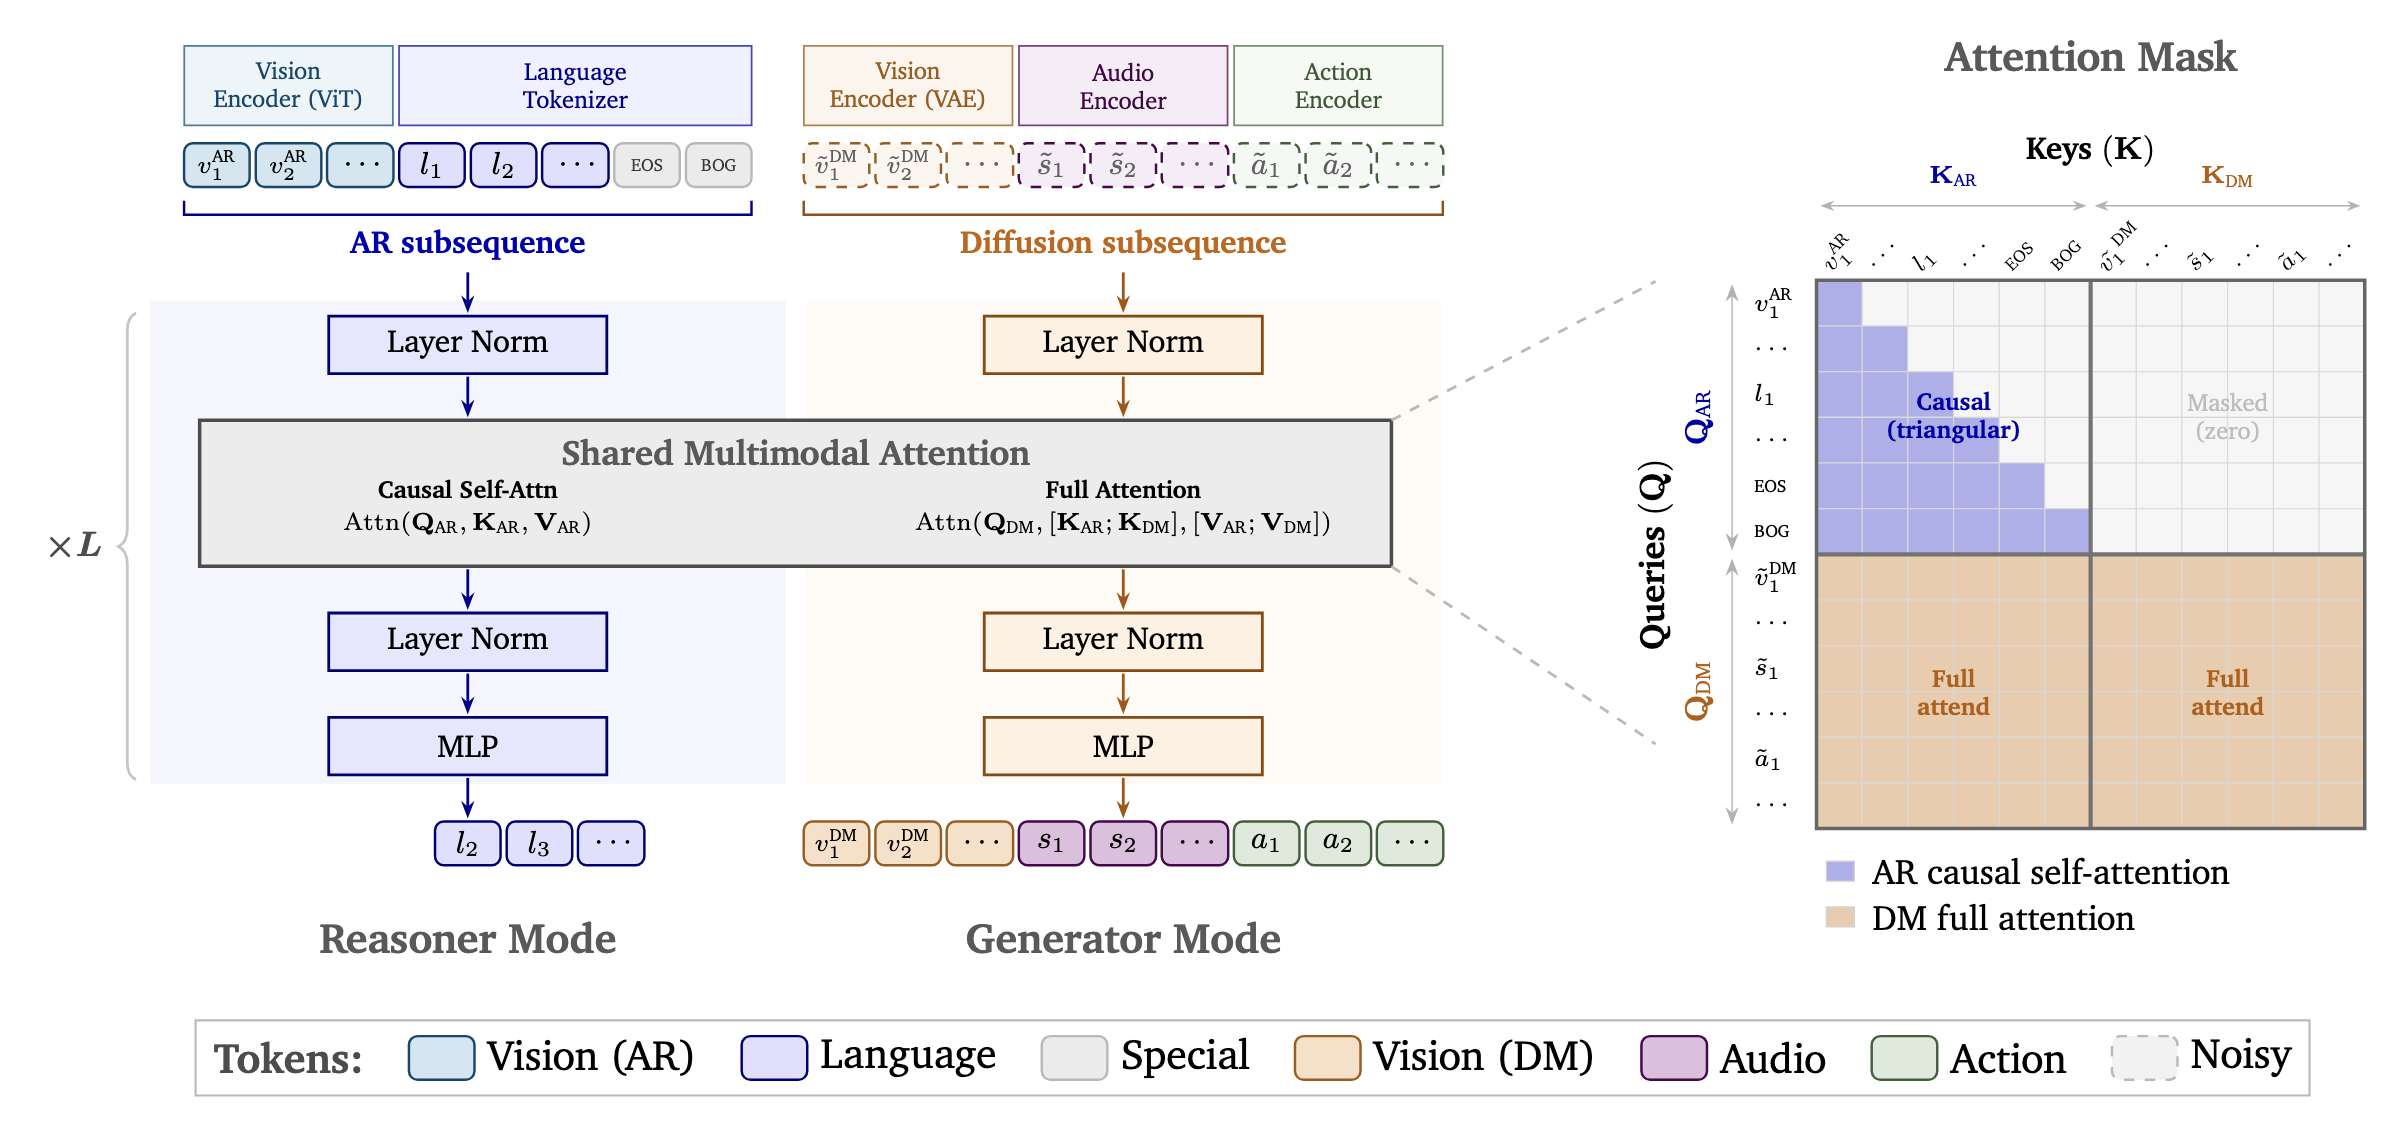
NVIDIA/cosmos
NVIDIA에서 공개한 ‘물리 AI(Physical AI)’ 개발용 오픈 플랫폼입니다. 로봇, 자율주행차, 스마트 인프라 등에 적용 가능한 월드 모델, 데이터셋, 도구를 제공하여 개발자들이 현실 세계와 상호작용하는 AI를 쉽게 구축하도록 지원합니다.
Open-LLM-VTuber/Open-LLM-VTuber
다양한 LLM과 음성으로 자유롭게 대화할 수 있게 해주는 오픈소스 VTuber 프로젝트입니다. 별도의 조작 없이 음성으로 대화하고 중간에 말을 끊는 기능 등을 지원하며, Live2D 아바타가 로컬에서 구동되어 자연스러운 상호작용 경험을 제공합니다.
AI Weekly
AI Weekly Issue #499: Microsoft proves it doesn't need OpenAI; Alphabet raises $85B
마이크로소프트가 OpenAI로부터의 기술 독립을 선언하고 알파벳이 기록적인 자금을 조달하는 등 AI 산업에 막대한 자본이 유입되고 있습니다. 그러나 플로리다의 OpenAI 소송, 새로운 연구 결과, 연준의 시스템 리스크 경고 등에서 나타나듯, AI 기술과 에이전트에 대한 사회적 신뢰는 아직 자본의 속도를 따라가지 못하고 있습니다.
오늘의 키워드
Audio Vision Eval Tool Use Agent LLM Reasoning RAG MCP Claude