Google Research/TimesFM, 시계열 예측 파운데이션 모델 공개
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

Learning from the Self-future: On-policy Self-distillation for dLLMs
기존의 온-폴리시 자기 증류(OPSD) 기법은 자기회귀 모델에 맞춰져 있어 임의의 순서로 생성하는 확산 LLM(dLLM)에는 적용하기 어려웠습니다. 이 연구는 dLLM의 특성을 고려한 최초의 OPSD 프레임워크인 d-OPSD를 제안하여, dLLM의 성능을 효과적으로 향상시키는 새로운 방법을 제시합니다.

Beyond the Current Observation: Evaluating Multimodal Large Language Models in Controllable Non-Markov Games
기존 멀티모달 LLM 평가 벤치마크는 현재 보이지 않는 과거의 정보를 기억하고 활용하는 능력을 제대로 측정하지 못하는 한계가 있었습니다. 이 문제를 해결하기 위해, 본 연구는 모델이 과거 관측 정보를 재구성하고 이를 기반으로 행동하는 능력을 독립적으로 평가할 수 있는 새로운 벤치마크 ‘RNG-Bench’를 제안합니다.

MolmoMotion: Forecasting Point Trajectories in 3D with Language Instruction
이 연구는 에이전트가 미래를 예측하고 행동을 계획하는 데 필수적인 동작 예측 문제를 3D 포인트 궤적 예측으로 접근합니다. 짧은 시각적 기록과 자연어 지시가 주어졌을 때 객체 위의 특정 3D 포인트들이 어떻게 움직일지 예측하는 ‘MolmoMotion’이라는 새로운 과업을 제시하며, 3D 포인트를 활용한 일반적이고 효율적인 예측 방법을 제안합니다.

Kairos: A Native World Model Stack for Physical AI
월드 모델이 물리적 AI의 핵심 인프라로 발전함에 따라, 다양한 경험에서 지식을 습득하고 장기적인 상태를 유지하며 효율적으로 작동해야 할 필요성이 커졌습니다. 이 연구는 이러한 요구사항에 맞춰 설계된 네이티브 월드 모델 스택 ‘Kairos’를 소개하며, 이종 데이터를 통합 학습하는 새로운 사전 훈련 패러다임을 통해 현실 세계에 적용 가능한 AI를 구축합니다.

Guava: An Effective and Universal Harness for Embodied Manipulation
대규모 비전-언어 데이터로 학습된 언어 모델을 로봇과 같은 물리적 에이전트에 활용하는 연구가 활발하며, 특히 고수준 추론과 외부 모듈을 결합하는 방식이 주목받고 있습니다. 이 연구는 물리적 조작을 위한 효과적인 ‘하네스(harness)’의 조건이 무엇인지 탐구하고, 다양한 모델의 능력을 보편적으로 끌어낼 수 있는 ‘Guava’ 프레임워크를 제안합니다.
Hugging Face Blog
Beyond the Current Observation: Evaluating Multimodal Large Language Models in Controllable Non-Markov Games
현재 멀티모달 모델 벤치마크는 과거의 보이지 않는 정보를 기억하고 활용하는 능력을 제대로 평가하지 못하는 한계가 있습니다. 이를 해결하기 위해, RNG-Bench는 모델이 과거 관측 정보를 재구성하고 이를 바탕으로 행동하는 능력을 독립적으로 측정하는 새로운 평가 방식을 제안합니다.
Native Active Perception as Reasoning for Omni-Modal Understanding
기존의 긴 비디오 이해 모델은 모든 프레임을 처리하여 영상 길이가 길어질수록 계산 비용이 급증하는 비효율성 문제가 있습니다. OmniAgent는 영상 이해를 능동적인 추론 과정으로 접근하여, 필요한 부분만 선택적으로 관찰하고 행동하는 방식으로 계산 효율성을 크게 향상시킨 최초의 옴니모달 에이전트입니다.
STARE: Surprisal-Guided Token-Level Advantage Reweighting for Policy Entropy Stability
LLM을 강화학습으로 훈련시킬 때 모델이 탐색 능력을 잃는 ‘정책 엔트로피 붕괴’ 문제가 자주 발생합니다. 이 논문은 토큰 수준에서 문제의 원인을 분석하고, 토큰 단위의 보상 가중치를 조절하여 훈련 과정에서 엔트로피 붕괴를 방지하는 STARE 기법을 제안합니다.
GitHub Trending
google-research/timesfm
TimesFM은 구글 리서치가 개발한 사전 훈련된 시계열 파운데이션 모델입니다. 이 모델은 시계열 데이터 예측을 위해 특별히 설계되었으며, 다양한 예측 작업에 활용될 수 있습니다.
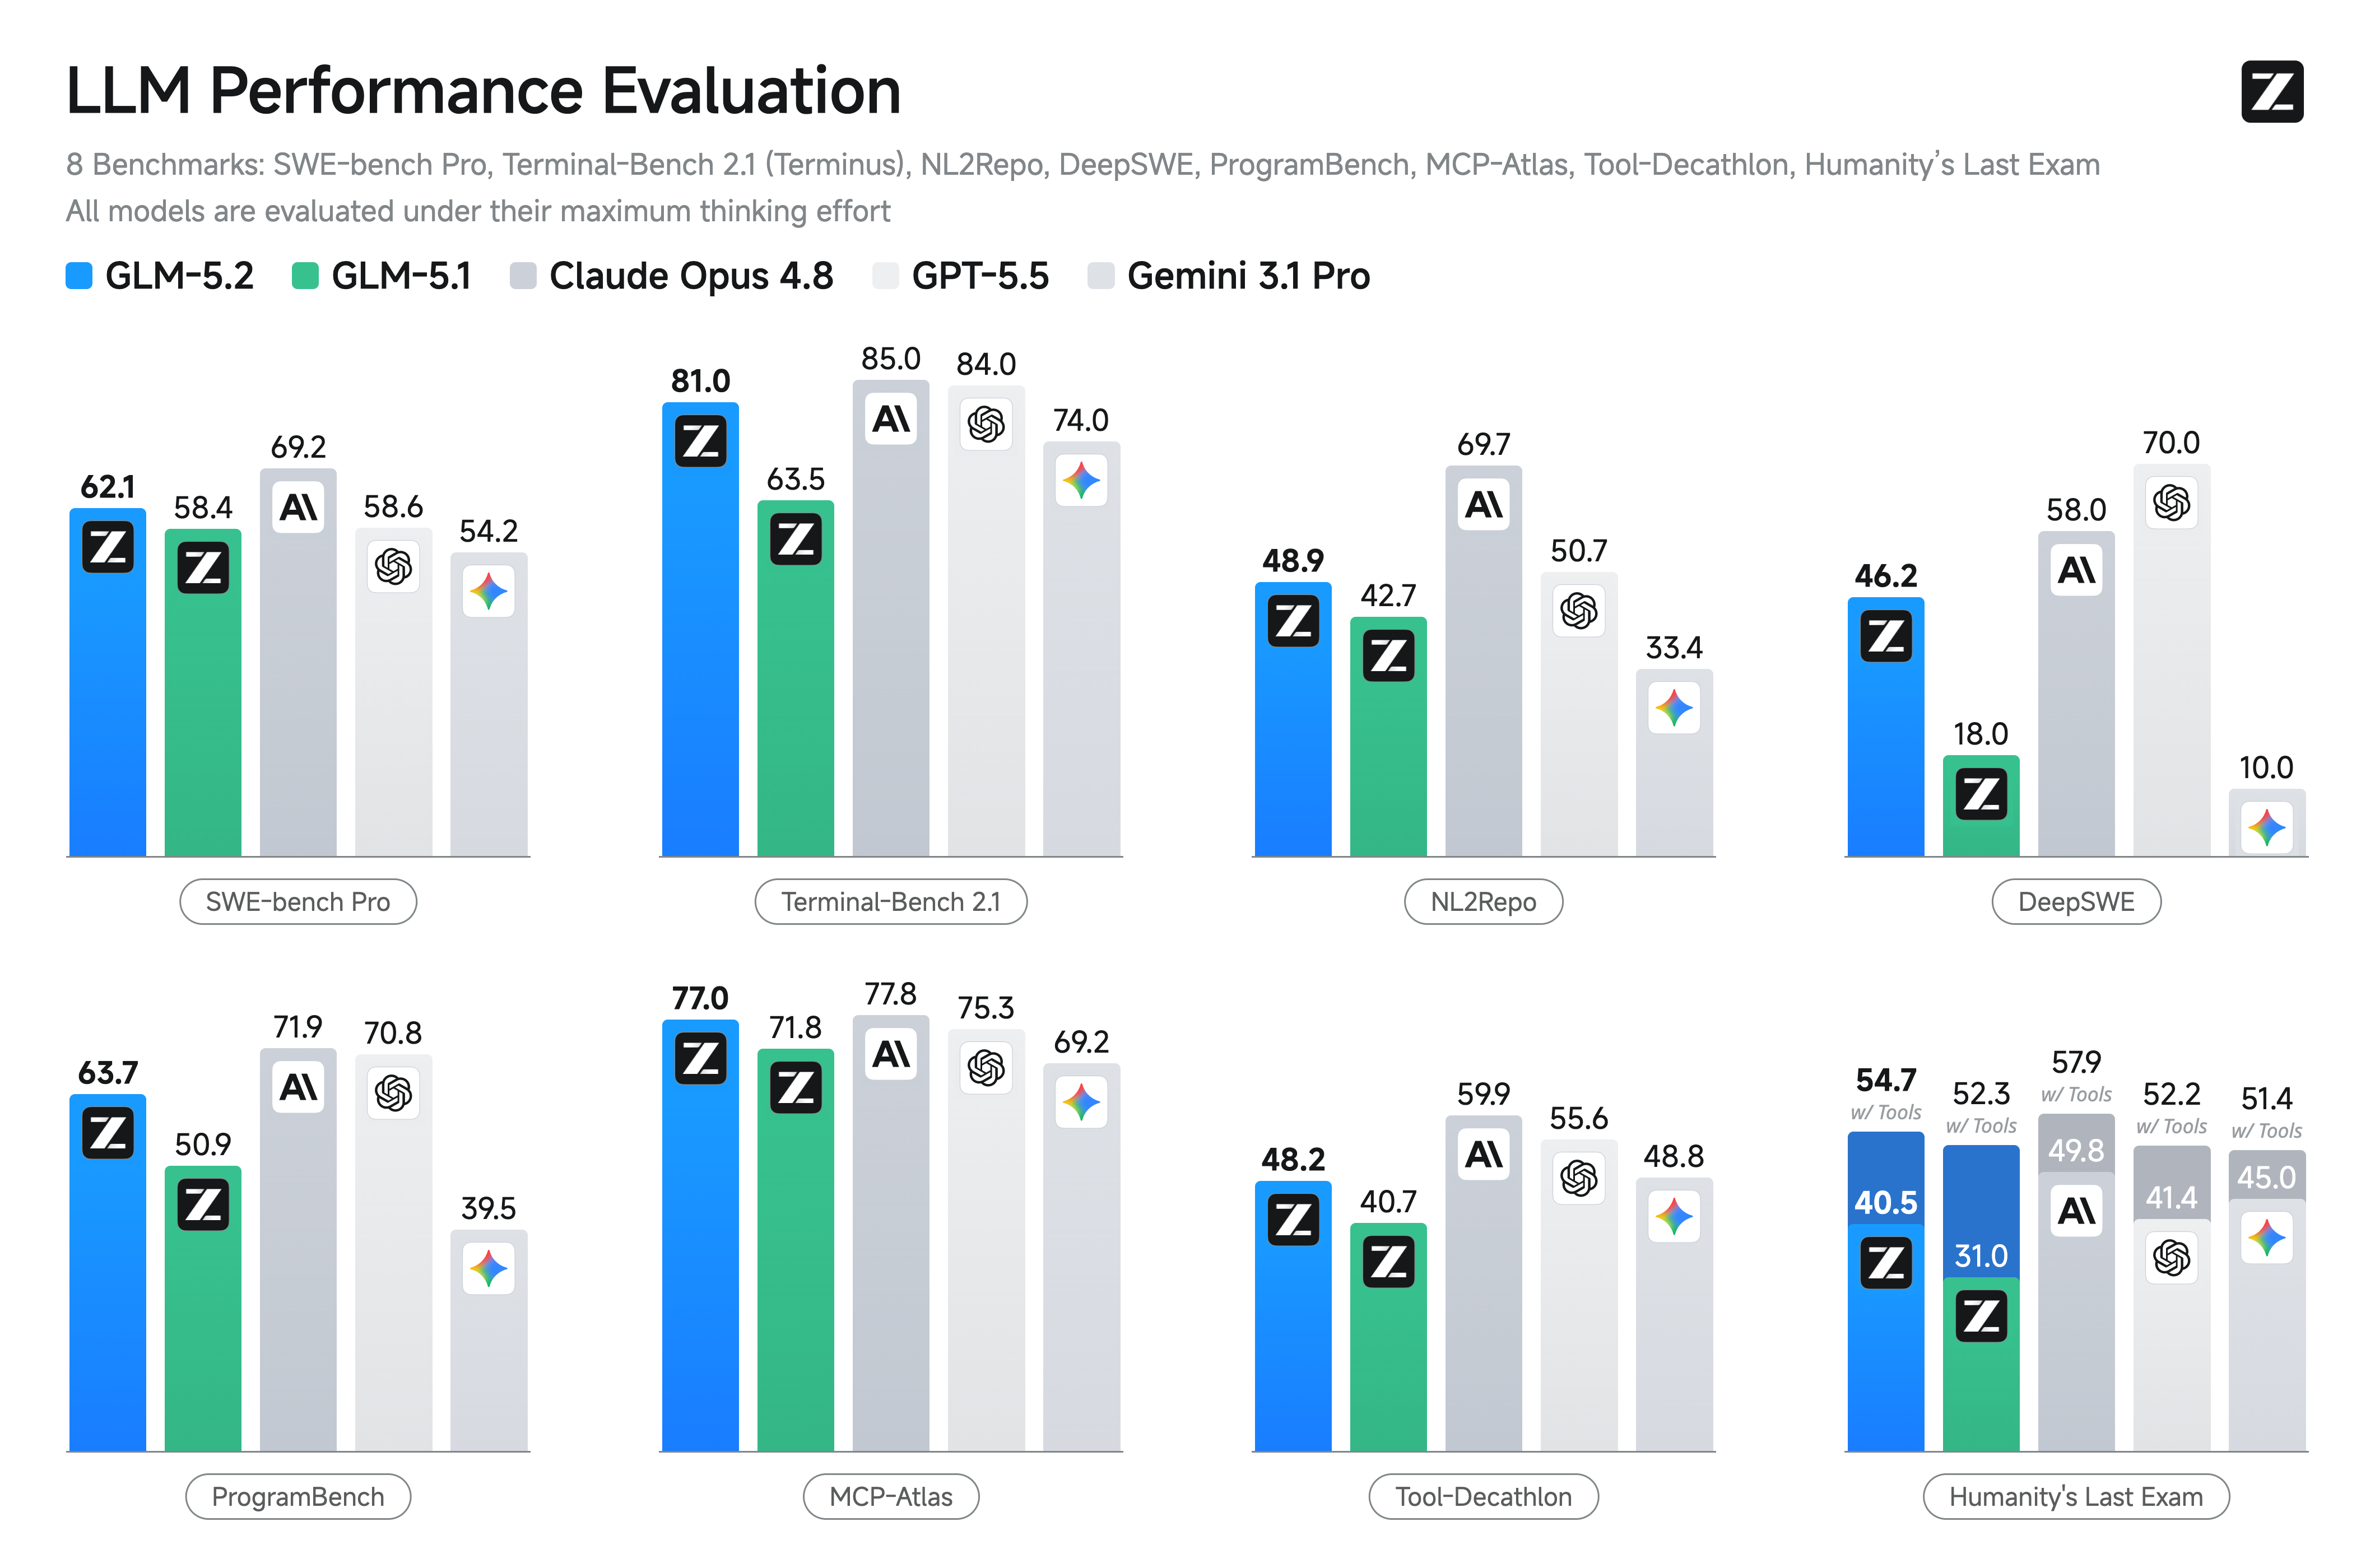
zai-org/GLM-5
GLM-5는 새로운 세대의 GLM 모델로, 직관적인 코딩을 넘어 자율적으로 작업을 수행하는 에이전트를 설계하고 구축하는 ‘에이전틱 엔지니어링’을 지향합니다. 이는 모델과의 상호작용 방식을 한 단계 발전시키는 것을 목표로 합니다.
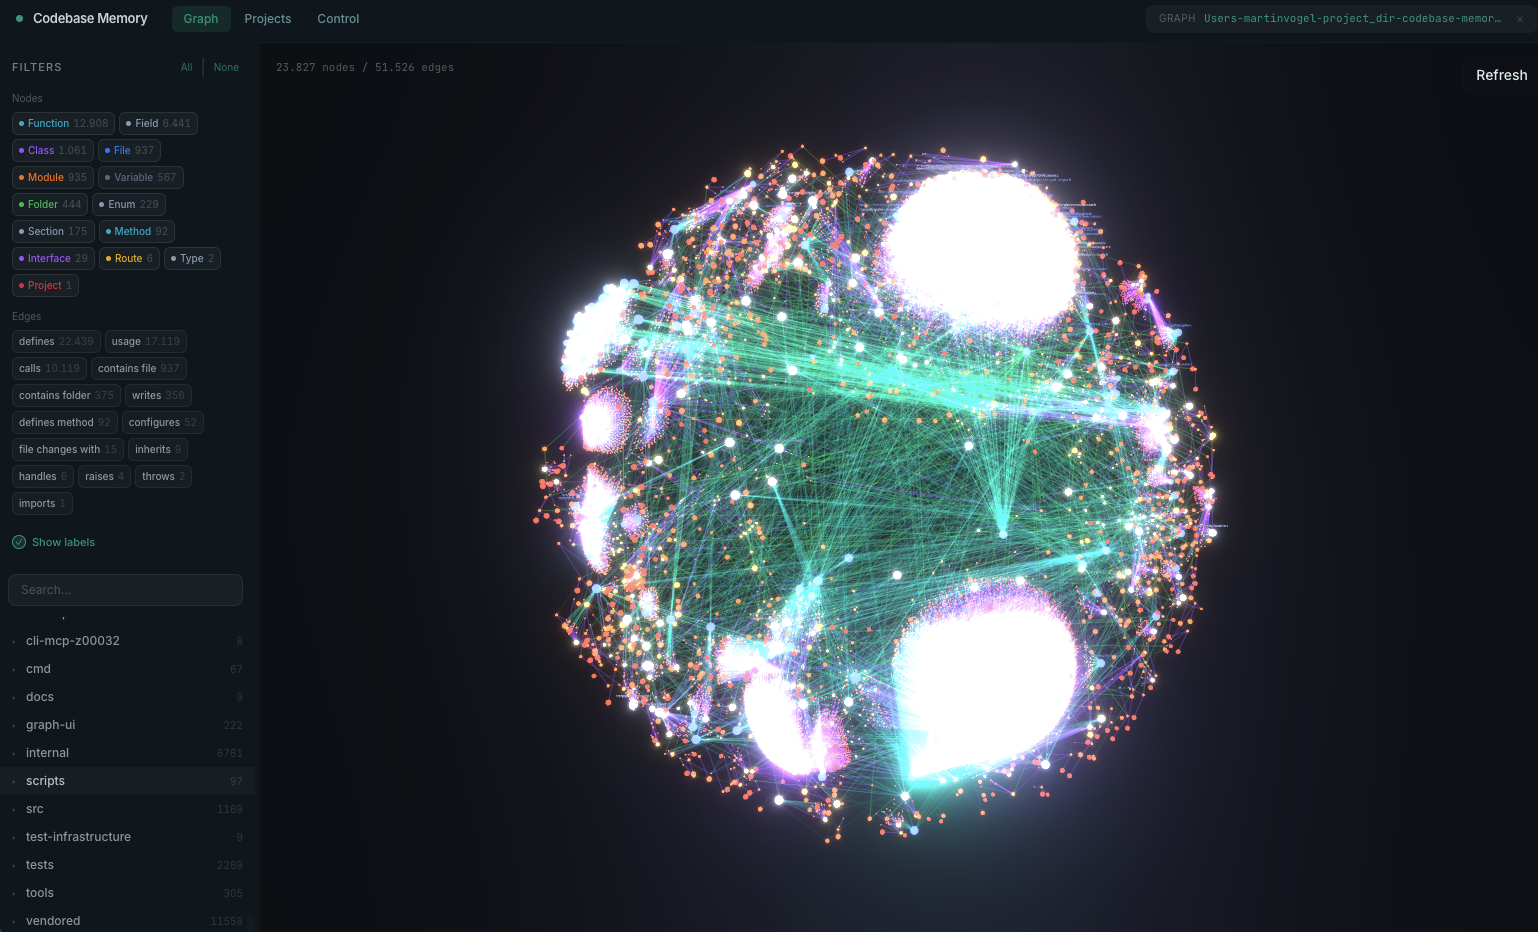
DeusData/codebase-memory-mcp
이 프로젝트는 고성능 코드 인텔리전스 서버로, 코드베이스를 영구적인 지식 그래프로 빠르게 인덱싱합니다. 158개 언어를 지원하고 밀리초 단위의 빠른 쿼리 속도를 자랑하며, 단일 바이너리로 의존성 없이 쉽게 배포할 수 있습니다.
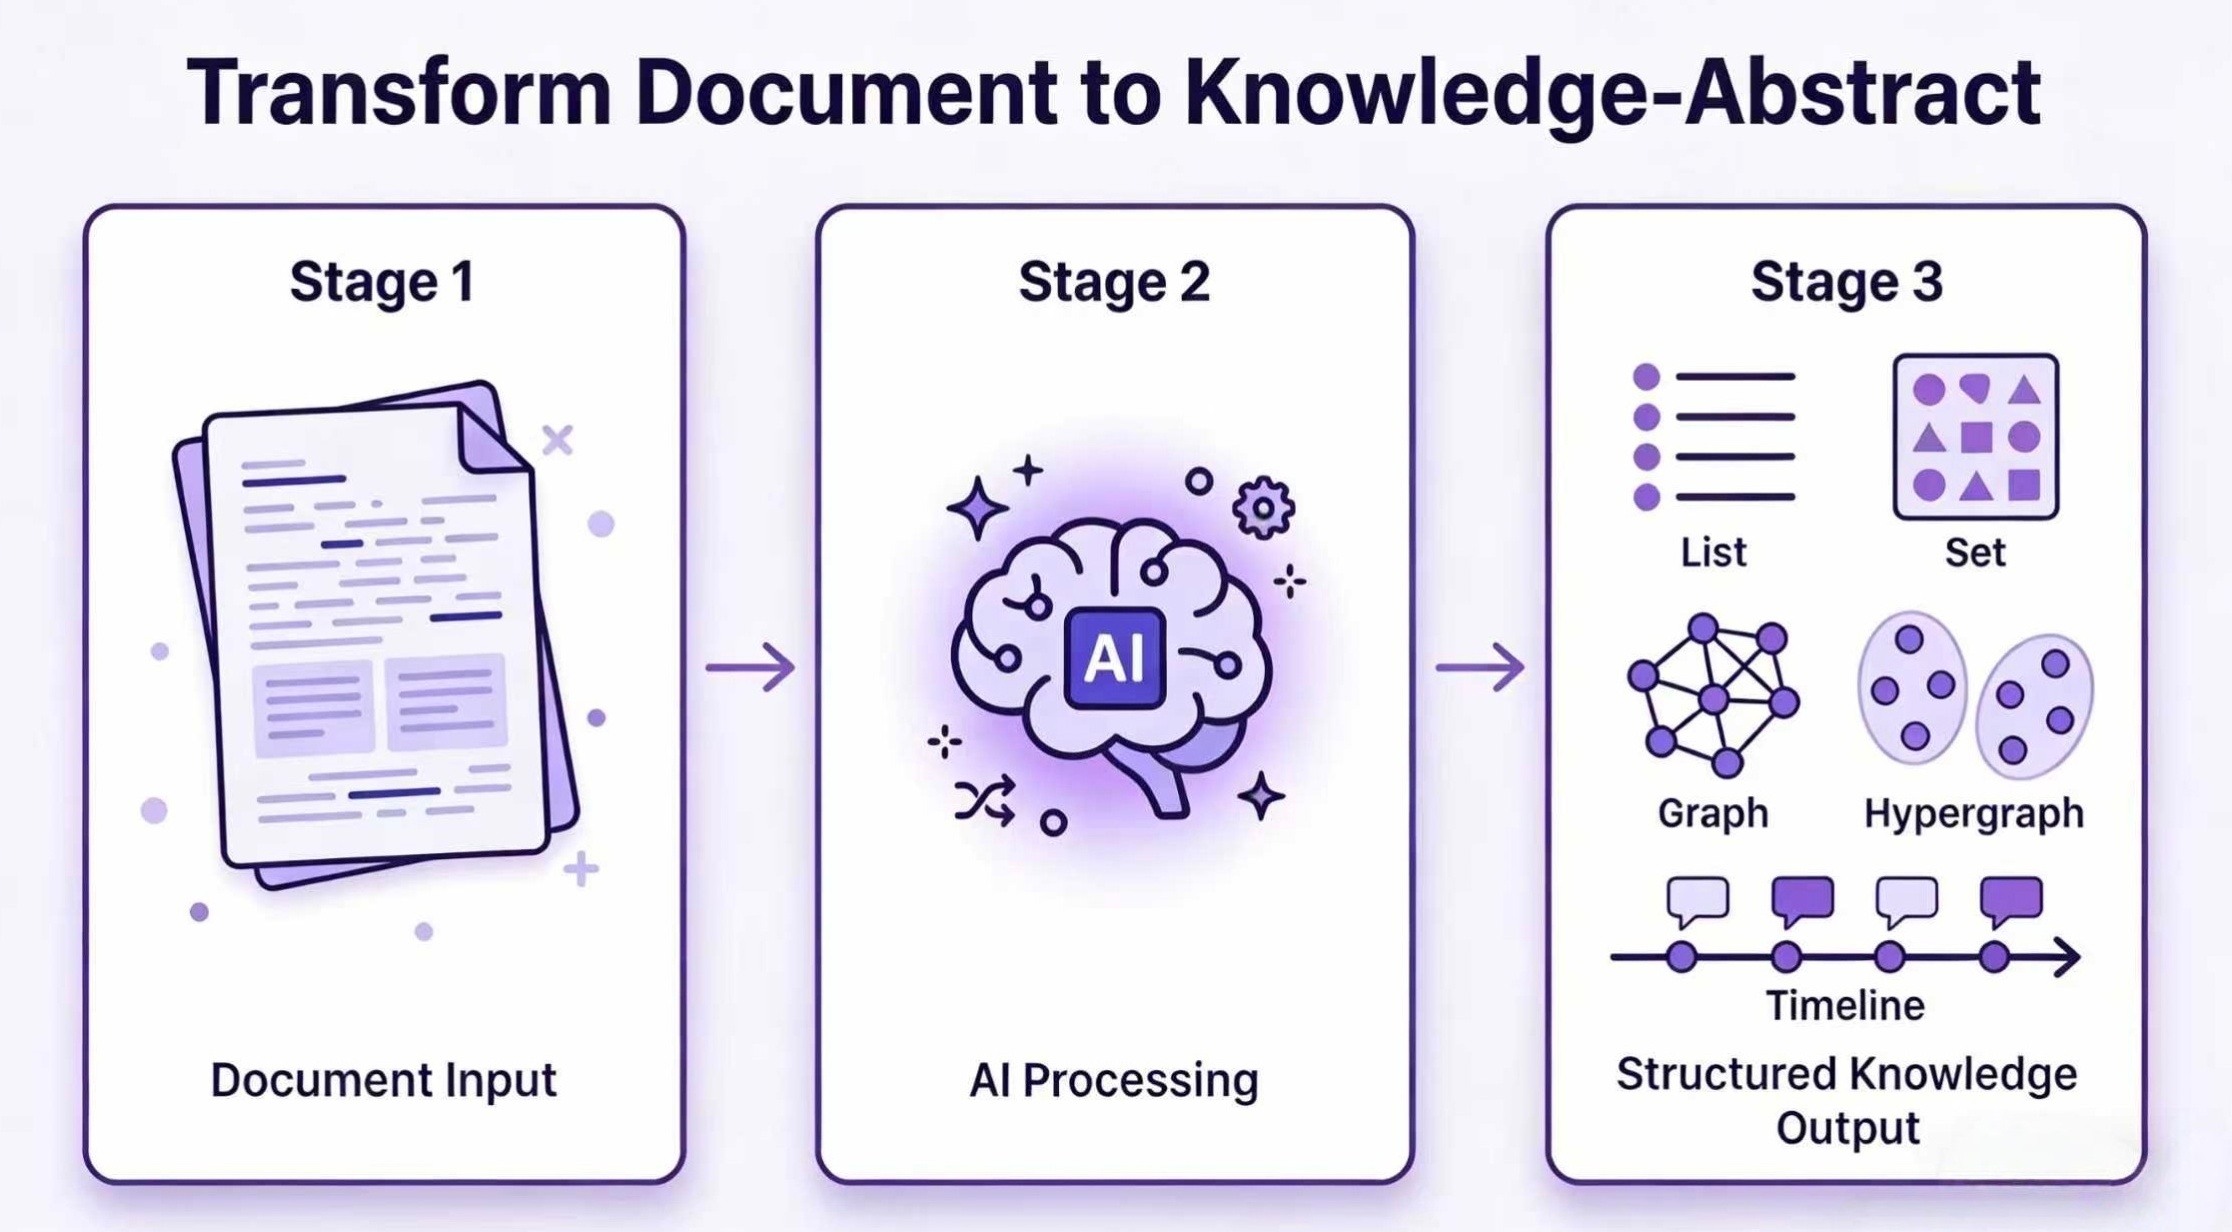
yifanfeng97/Hyper-Extract
Hyper-Extract는 LLM을 활용하여 비정형 텍스트를 구조화된 지식으로 변환하는 도구입니다. 단 하나의 명령어로 텍스트에서 그래프, 하이퍼그래프, 시공간 정보 등 복잡한 데이터를 손쉽게 추출할 수 있습니다.
alibaba/zvec
zvec은 알리바바에서 개발한 경량의 초고속 인-프로세스 벡터 데이터베이스입니다. 애플리케이션 프로세스 내에서 직접 실행되어 별도의 서버 없이 빠르고 효율적인 벡터 검색 기능을 제공합니다.
오늘의 키워드
LLM Distillation Multimodal Agent Eval Vision Reasoning RAG MCP