daily_stock_analysis — LLM 기반 다중 시장 주식 분석 시스템
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

PlanBench-XL: Evaluating Long-Horizon Planning of LLM Tool-Use Agents in Large-Scale Tool Ecosystems
현재 LLM 에이전트 벤치마크는 대규모 도구 생태계에서 장기적인 계획 수립 능력을 평가하기에 한계가 있습니다. 이를 해결하기 위해 제안된 PlanBench-XL은 1,665개의 도구와 327개의 과제를 포함하는 대화형 벤치마크로, 에이전트가 복잡한 목표 달성을 위해 필요한 도구를 스스로 찾고 활용하는 능력을 측정합니다.

OpenRath: Session-Centered Runtime State for Agent Systems
기존 에이전트 시스템은 로그, 메모리, 도구 사용 효과 등 런타임 상태가 여러 곳에 흩어져 있어 분석과 재현이 어렵다는 문제가 있었습니다. OpenRath는 ‘세션(Session)’이라는 핵심 개념을 통해 분산된 런타임 상태를 하나로 통합하고 관리하여, 다중 에이전트 시스템의 관찰과 재현을 용이하게 만드는 새로운 프로그래밍 모델을 제시합니다.

DataClaw0: Agentic Tailoring Multimodal Data from Raw Streams
정제되지 않은 대규모 멀티모달 데이터는 정보의 밀도가 낮아 사람이 지식을 얻거나 AI를 학습시키는 데 비효율적입니다. DataClaw0는 이러한 데이터 처리 과정을 학습 가능한 능력으로 보고, AI 에이전트가 능동적으로 원시 데이터를 정제하고 구조화하는 ‘에이전틱 데이터 테일러링’이라는 새로운 패러다임을 제안합니다.

EnterpriseClawBench: Benchmarking Agents from Real Workplace Sessions
실제 업무 환경에서 파일 읽기, 도구 사용 등 복잡한 작업을 수행하는 기업용 AI 에이전트의 성능을 평가할 현실적인 벤치마크가 부족했습니다. EnterpriseClawBench는 실제 기업 환경의 에이전트 사용 기록을 기반으로 구축되었으며, 실제와 유사한 852개의 재현 가능한 과제를 제공하여 에이전트의 실질적인 업무 능력을 측정합니다.

Grouped Query Experts: Mixture-of-Experts on GQA Self-Attention
트랜스포머 모델의 셀프 어텐션은 모든 토큰에 동일한 연산을 적용하여 긴 시퀀스에서 계산 비용이 매우 높다는 단점이 있습니다. 이를 개선하기 위해 제안된 ‘Grouped Query Experts’는 토큰의 특성에 따라 선택적으로 어텐션 헤드를 활성화하는 전문가 혼합(MoE) 방식을 적용하여, 연산 효율성을 크게 향상시키는 새로운 기법입니다.
Hugging Face Blog
EnterpriseClawBench: Benchmarking Agents from Real Workplace Sessions
엔터프라이즈 환경에서 AI 에이전트의 성능을 평가하기 위한 새로운 벤치마크 EnterpriseClawBench가 공개되었습니다. 이 벤치마크는 실제 업무 환경에서 수집된 데이터를 기반으로 852개의 재현 가능한 과제를 제공하여, 에이전트가 복잡한 작업을 얼마나 잘 수행하는지 측정합니다.
Causal Discovery in the Era of Agents
최근 LLM을 인과관계 추론에 직접 활용하려는 시도가 많지만, 이는 환각이나 프롬프트 오류 등으로 인해 신뢰도가 떨어질 수 있습니다. 따라서 이 연구는 LLM 에이전트가 인과 모델을 직접 생성하기보다는, 데이터 분석과 검증 과정을 보조하여 인간 연구자가 더 신뢰도 높은 모델을 구축하도록 돕는 역할을 해야 한다고 주장합니다.
Tapered Language Models
현대 언어 모델은 모든 레이어에 동일한 파라미터를 할당하는 구조가 일반적이지만, 각 레이어의 실제 기여도는 균일하지 않습니다. 이에 본 연구는 모델의 깊이에 따라 파라미터 용량을 다르게 할당하는 ‘Tapered Language Model’ 개념을 제안하며, 후반부 레이어로 갈수록 파라미터를 줄이는 구조의 효율성을 탐구합니다.
토스 기술블로그
6. 도구를 넘어, 기준과 책임으로
문서화의 성공은 도구와 자동화를 넘어, 명확한 기준과 책임 정립에 달려있습니다. 이 글은 어떤 문서를 남기고 누가 책임질지 등 문서화의 핵심 원칙을 수립해나간 과정을 상세히 설명합니다.
5. Technical Writer, 사라질 결심
테크니컬 라이터의 전문 지식과 노하우를 AI에 학습시켜 글쓰기와 리뷰 과정을 자동화했습니다. 사람이 하던 반복적인 업무를 AI가 대신하게 함으로써 기술 문서 작성의 효율을 극대화한 과정을 소개합니다.
GitHub Trending
calesthio/OpenMontage
세계 최초의 오픈소스 에이전트 기반 영상 제작 시스템입니다. 12개의 파이프라인, 52개의 도구, 500개 이상의 에이전트 기술을 활용하여 AI 코딩 어시스턴트를 완전한 영상 제작 스튜디오로 변신시킬 수 있습니다.
ZhuLinsen/daily_stock_analysis
LLM을 활용하여 여러 국가의 주식 시장을 분석하는 지능형 시스템입니다. 다양한 출처의 시세 정보, 실시간 뉴스, 의사결정 대시보드를 제공하며 자동 알림과 예약 실행 기능을 무료로 이용할 수 있습니다.
mukul975/Anthropic-Cybersecurity-Skills
AI 에이전트를 위한 817개의 구조화된 사이버 보안 기술을 모아놓은 프로젝트입니다. 이 기술들은 MITRE ATT&CK, NIST CSF 2.0 등 6개의 주요 프레임워크에 매핑되어 있으며, Claude Code나 GitHub Copilot 같은 다양한 플랫폼과 호환됩니다.
garrytan/gstack
유명 투자자 개리 탠(Garry Tan)이 사용하는 Claude Code 설정 전체를 공유하는 프로젝트입니다. CEO, 디자이너, 엔지니어링 매니저 등 다양한 역할을 수행하도록 구성된 23개의 특화된 도구 모음을 포함하고 있습니다.
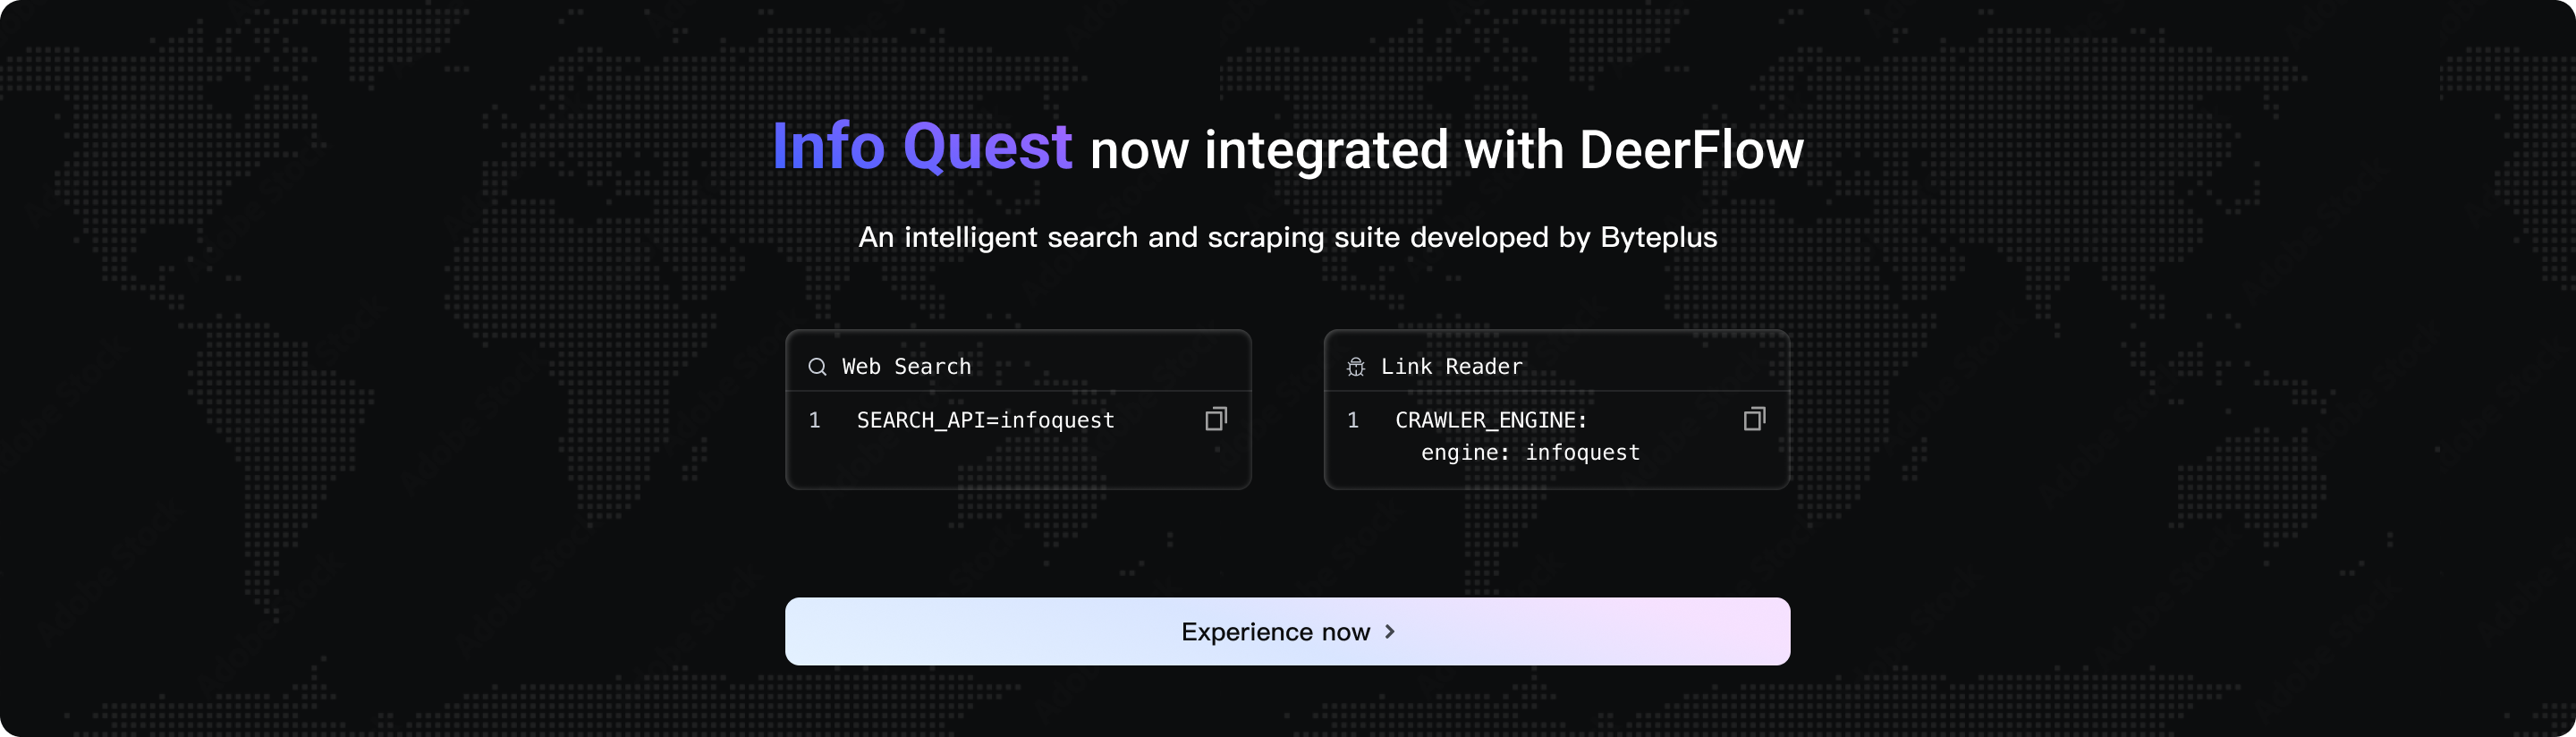
bytedance/deer-flow
바이트댄스가 공개한 오픈소스 ‘슈퍼에이전트’ 프레임워크로, 연구, 코딩, 창작 등 복잡하고 긴 시간이 소요되는 작업을 수행할 수 있습니다. 샌드박스, 메모리, 하위 에이전트 등 다양한 구성 요소를 활용하여 수 분에서 수 시간에 이르는 고난도 작업을 처리하도록 설계되었습니다.
오늘의 키워드
LLM Retrieval Agent Eval RAG Multimodal Prompt Transformer Long Context AI Coding