free-for-dev — 개발자를 위한 무료 SaaS/PaaS/IaaS 서비스 모음
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

Are We Ready For An Agent-Native Memory System?
LLM 에이전트의 메모리 시스템은 단순한 정보 검색을 넘어 복잡한 데이터 관리 시스템으로 진화했습니다. 하지만 현재의 성능 평가는 여전히 최종 결과에만 초점을 맞춰 메모리 시스템 자체의 효율성을 제대로 측정하지 못하고 있습니다. 따라서 이 연구는 에이전트 네이티브 메모리 시스템의 성능을 정밀하게 평가할 새로운 벤치마크의 필요성을 제기합니다.

DanceOPD: On-Policy Generative Field Distillation
최신 이미지 생성 모델은 텍스트-이미지 변환, 부분 편집 등 다양한 기능을 통합해야 하지만, 이 기능들이 서로 충돌하여 성능 저하를 일으키는 문제가 있습니다. 이 논문은 이러한 기능 간의 충돌을 해결하고 효과적으로 조합하기 위해 ‘DanceOPD’라는 새로운 학습 방법을 제안합니다. 이를 통해 단일 모델에서 여러 기능을 조화롭게 통합하여 다양한 편집 작업을 안정적으로 수행할 수 있습니다.

DomainShuttle: Freeform Open Domain Subject-driven Text-to-video Generation
텍스트 설명에 따라 특정 피사체를 주인공으로 하는 비디오 생성 기술은 피사체의 특징을 그대로 유지하는 경우와 유연하게 변경하는 경우로 나뉩니다. 기존 연구들은 주로 피사체의 일관성을 유지하는 데 집중했지만, 이 논문은 ‘DomainShuttle’이라는 새로운 방법을 제안하여 두 시나리오 모두에서 높은 품질을 달성합니다. 이를 통해 사용자는 텍스트 프롬프트만으로 원하는 피사체를 다양한 맥락의 영상으로 자유롭게 만들 수 있습니다.
In-Context World Modeling for Robotic Control
기존의 로봇 제어 모델(VLA)은 학습된 환경과 조금만 달라져도 일반화에 실패하는 경향이 있는데, 이는 현재 관찰 정보에만 의존하기 때문입니다. 이 연구는 ‘In-Context World Modeling’이라는 새로운 접근법을 제안하여, 모델이 몇 가지 예시만으로 새로운 환경의 카메라 위치나 로봇 형태 같은 변화를 스스로 파악하고 적응하도록 합니다. 이를 통해 대규모 재학습 없이도 다양한 환경에서 로봇이 효과적으로 작업을 수행할 수 있습니다.

OPID: On-Policy Skill Distillation for Agentic Reinforcement Learning
언어 에이전트를 강화학습으로 훈련시킬 때 최종 결과에만 보상을 주면 중간 과정의 좋은 결정을 학습하기 어렵습니다. 이 논문은 ‘OPID’라는 새로운 온폴리시(on-policy) 스킬 증류 방법을 제안하여, 외부 메모리 없이 에이전트가 스스로 생성한 궤적 내에서 중요한 스킬을 추출하고 학습하도록 합니다. 이를 통해 에이전트는 더 효율적으로 세밀한 행동 지침을 학습하여 전반적인 성능을 향상시킬 수 있습니다.
Hugging Face Blog
DanceOPD: On-Policy Generative Field Distillation
현대 이미지 생성 모델은 텍스트-이미지 변환, 부분 편집, 전체 편집 등 다양한 기능을 통합해야 하지만, 이 기능들은 종종 서로 충돌하여 성능 저하를 일으킵니다. ‘DanceOPD’는 이처럼 상충하는 여러 기능들을 효과적으로 조합하여 단일 모델에서 다양한 작업을 안정적으로 수행할 수 있도록 하는 새로운 훈련 방법을 제시합니다.
PhysiFormer: Learning to Simulate Mechanics in World Space
‘PhysiFormer’는 물리적으로 현실적인 3D 객체의 움직임을 예측하는 새로운 확산 트랜스포머 모델입니다. 기존의 픽셀 기반 비디오 모델과 달리, 이 모델은 월드 좌표계의 3D 메시를 직접 사용하여 객체의 초기 상태와 재질을 바탕으로 미래의 움직임 궤적을 시뮬레이션합니다.
Ask, Solve, Generate: Self-Evolving Unified Multimodal Understanding and Generation via Self-Consistency Rewards
이 연구는 외부의 정답 데이터나 보상 모델 없이, 레이블 없는 이미지만으로 시각 이해와 이미지 생성 능력을 동시에 향상시키는 대형 멀티모달 모델(LMM)의 자가 발전 훈련 프레임워크를 제안합니다. 모델 내부에 질문 생성, 답변 및 평가, 이미지 생성의 역할을 부여하여, 스스로 생성한 데이터를 통해 자율적으로 학습하고 발전하는 새로운 패러다임을 제시합니다.
GitHub Trending
ripienaar/free-for-dev
이 저장소는 개발자와 데브옵스 엔지니어를 위한 무료 플랜을 제공하는 다양한 SaaS, PaaS, IaaS 서비스 목록을 정리한 자료입니다. 클라우드 기반의 여러 유용한 도구와 플랫폼을 비용 부담 없이 사용해 볼 수 있어 개발자들에게 매우 유용합니다.
commaai/openpilot
openpilot은 로보틱스를 위한 오픈소스 운영체제이며, 현재 300개 이상의 차종에서 운전자 보조 시스템을 업그레이드하는 데 사용됩니다. 이 시스템을 통해 기존 차량의 주행 보조 기능을 획기적으로 향상시킬 수 있습니다.
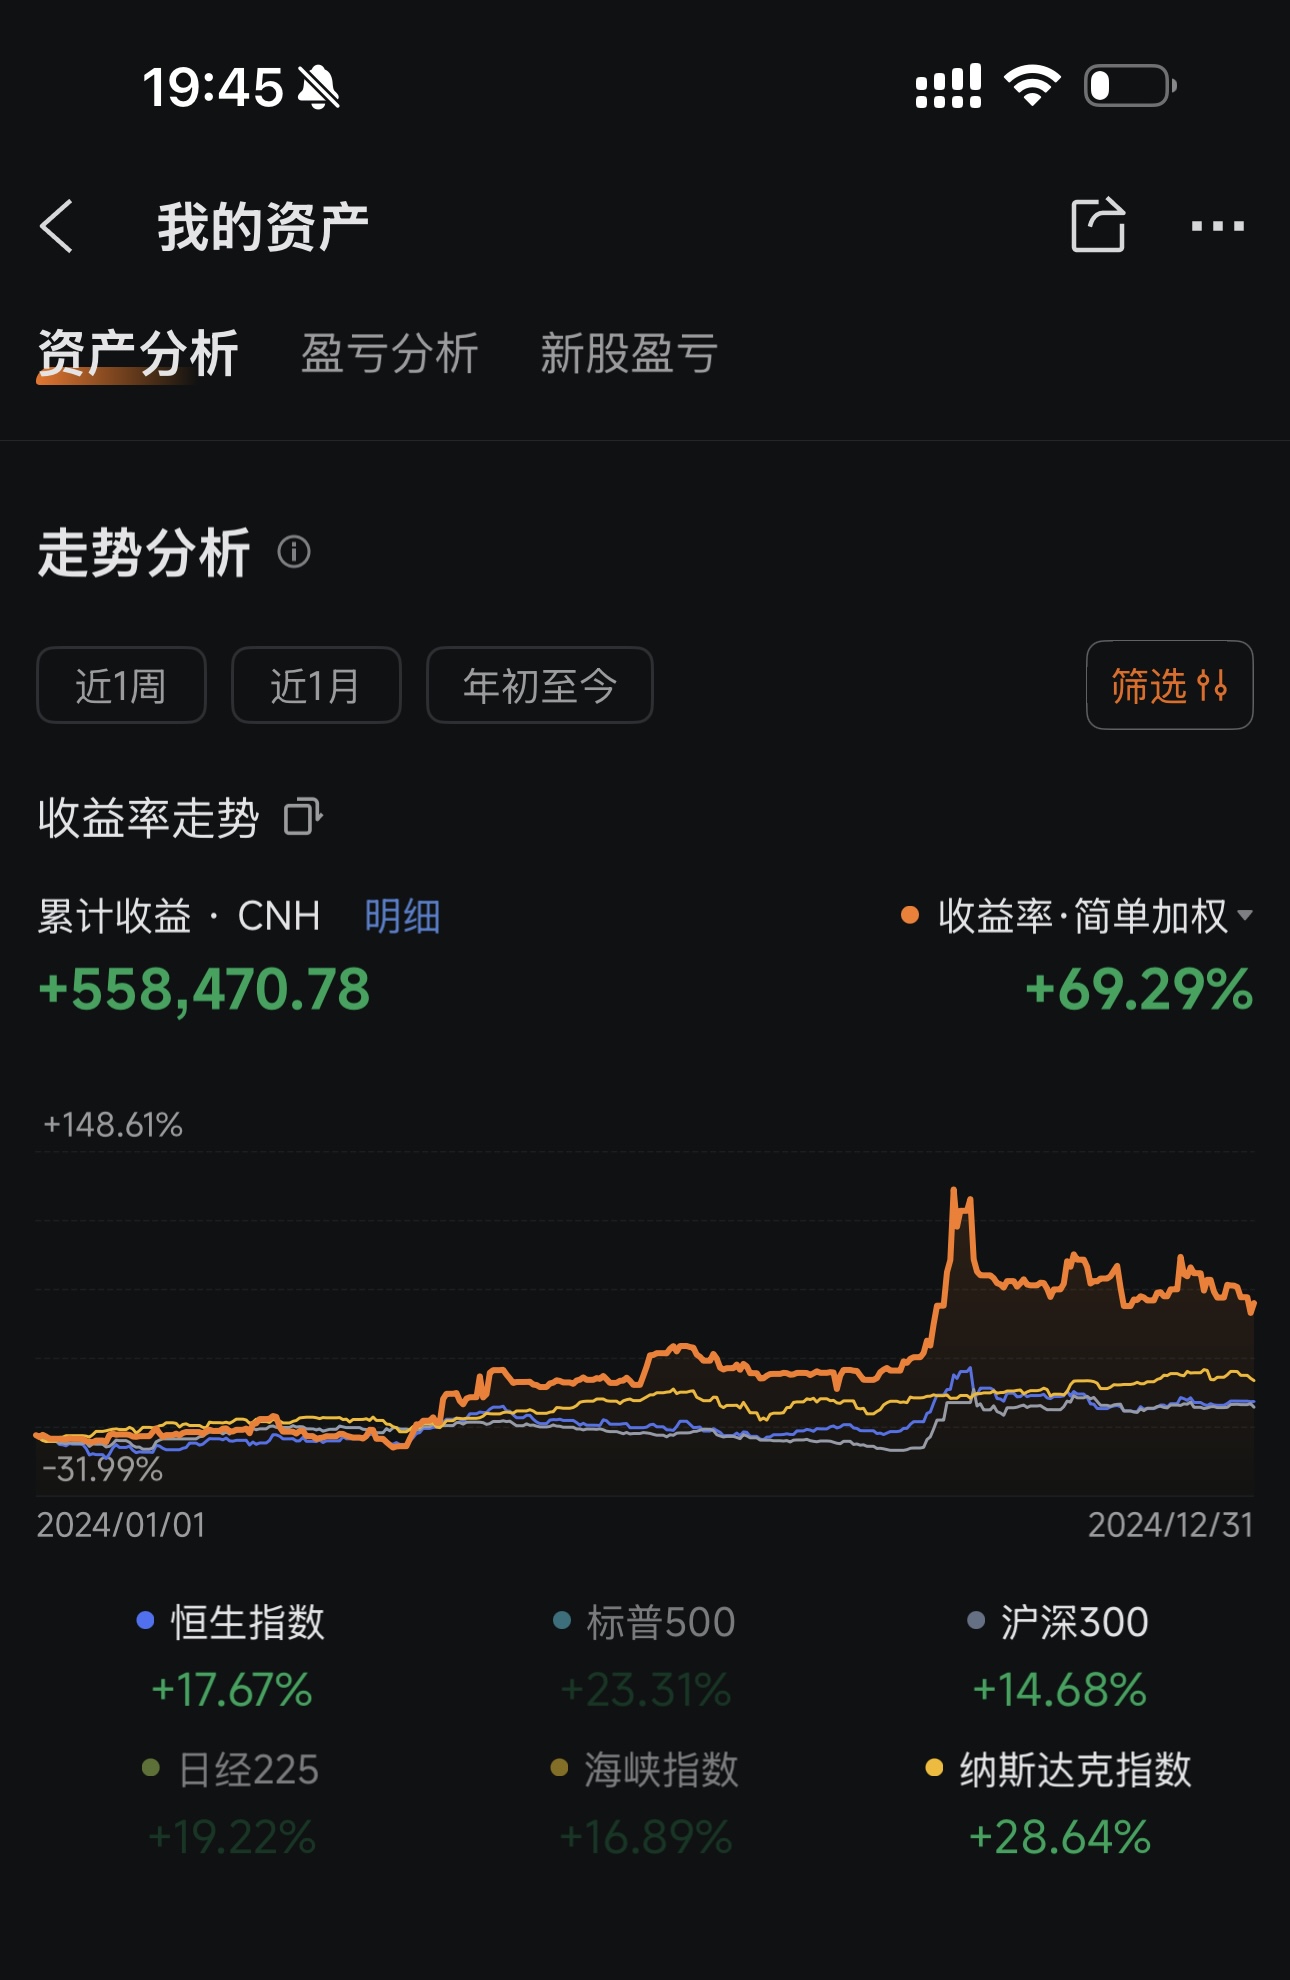
xbtlin/ai-berkshire
이 프로젝트는 AI 시대를 위한 가치 투자 연구 프레임워크로, Claude Code나 Codex 같은 AI 모델을 기반으로 구축되었습니다. 워렌 버핏, 찰리 멍거 등 네 명의 투자 대가들의 방법론을 적용하고 여러 AI 에이전트가 병렬적으로 분석을 수행하는 점이 특징입니다.
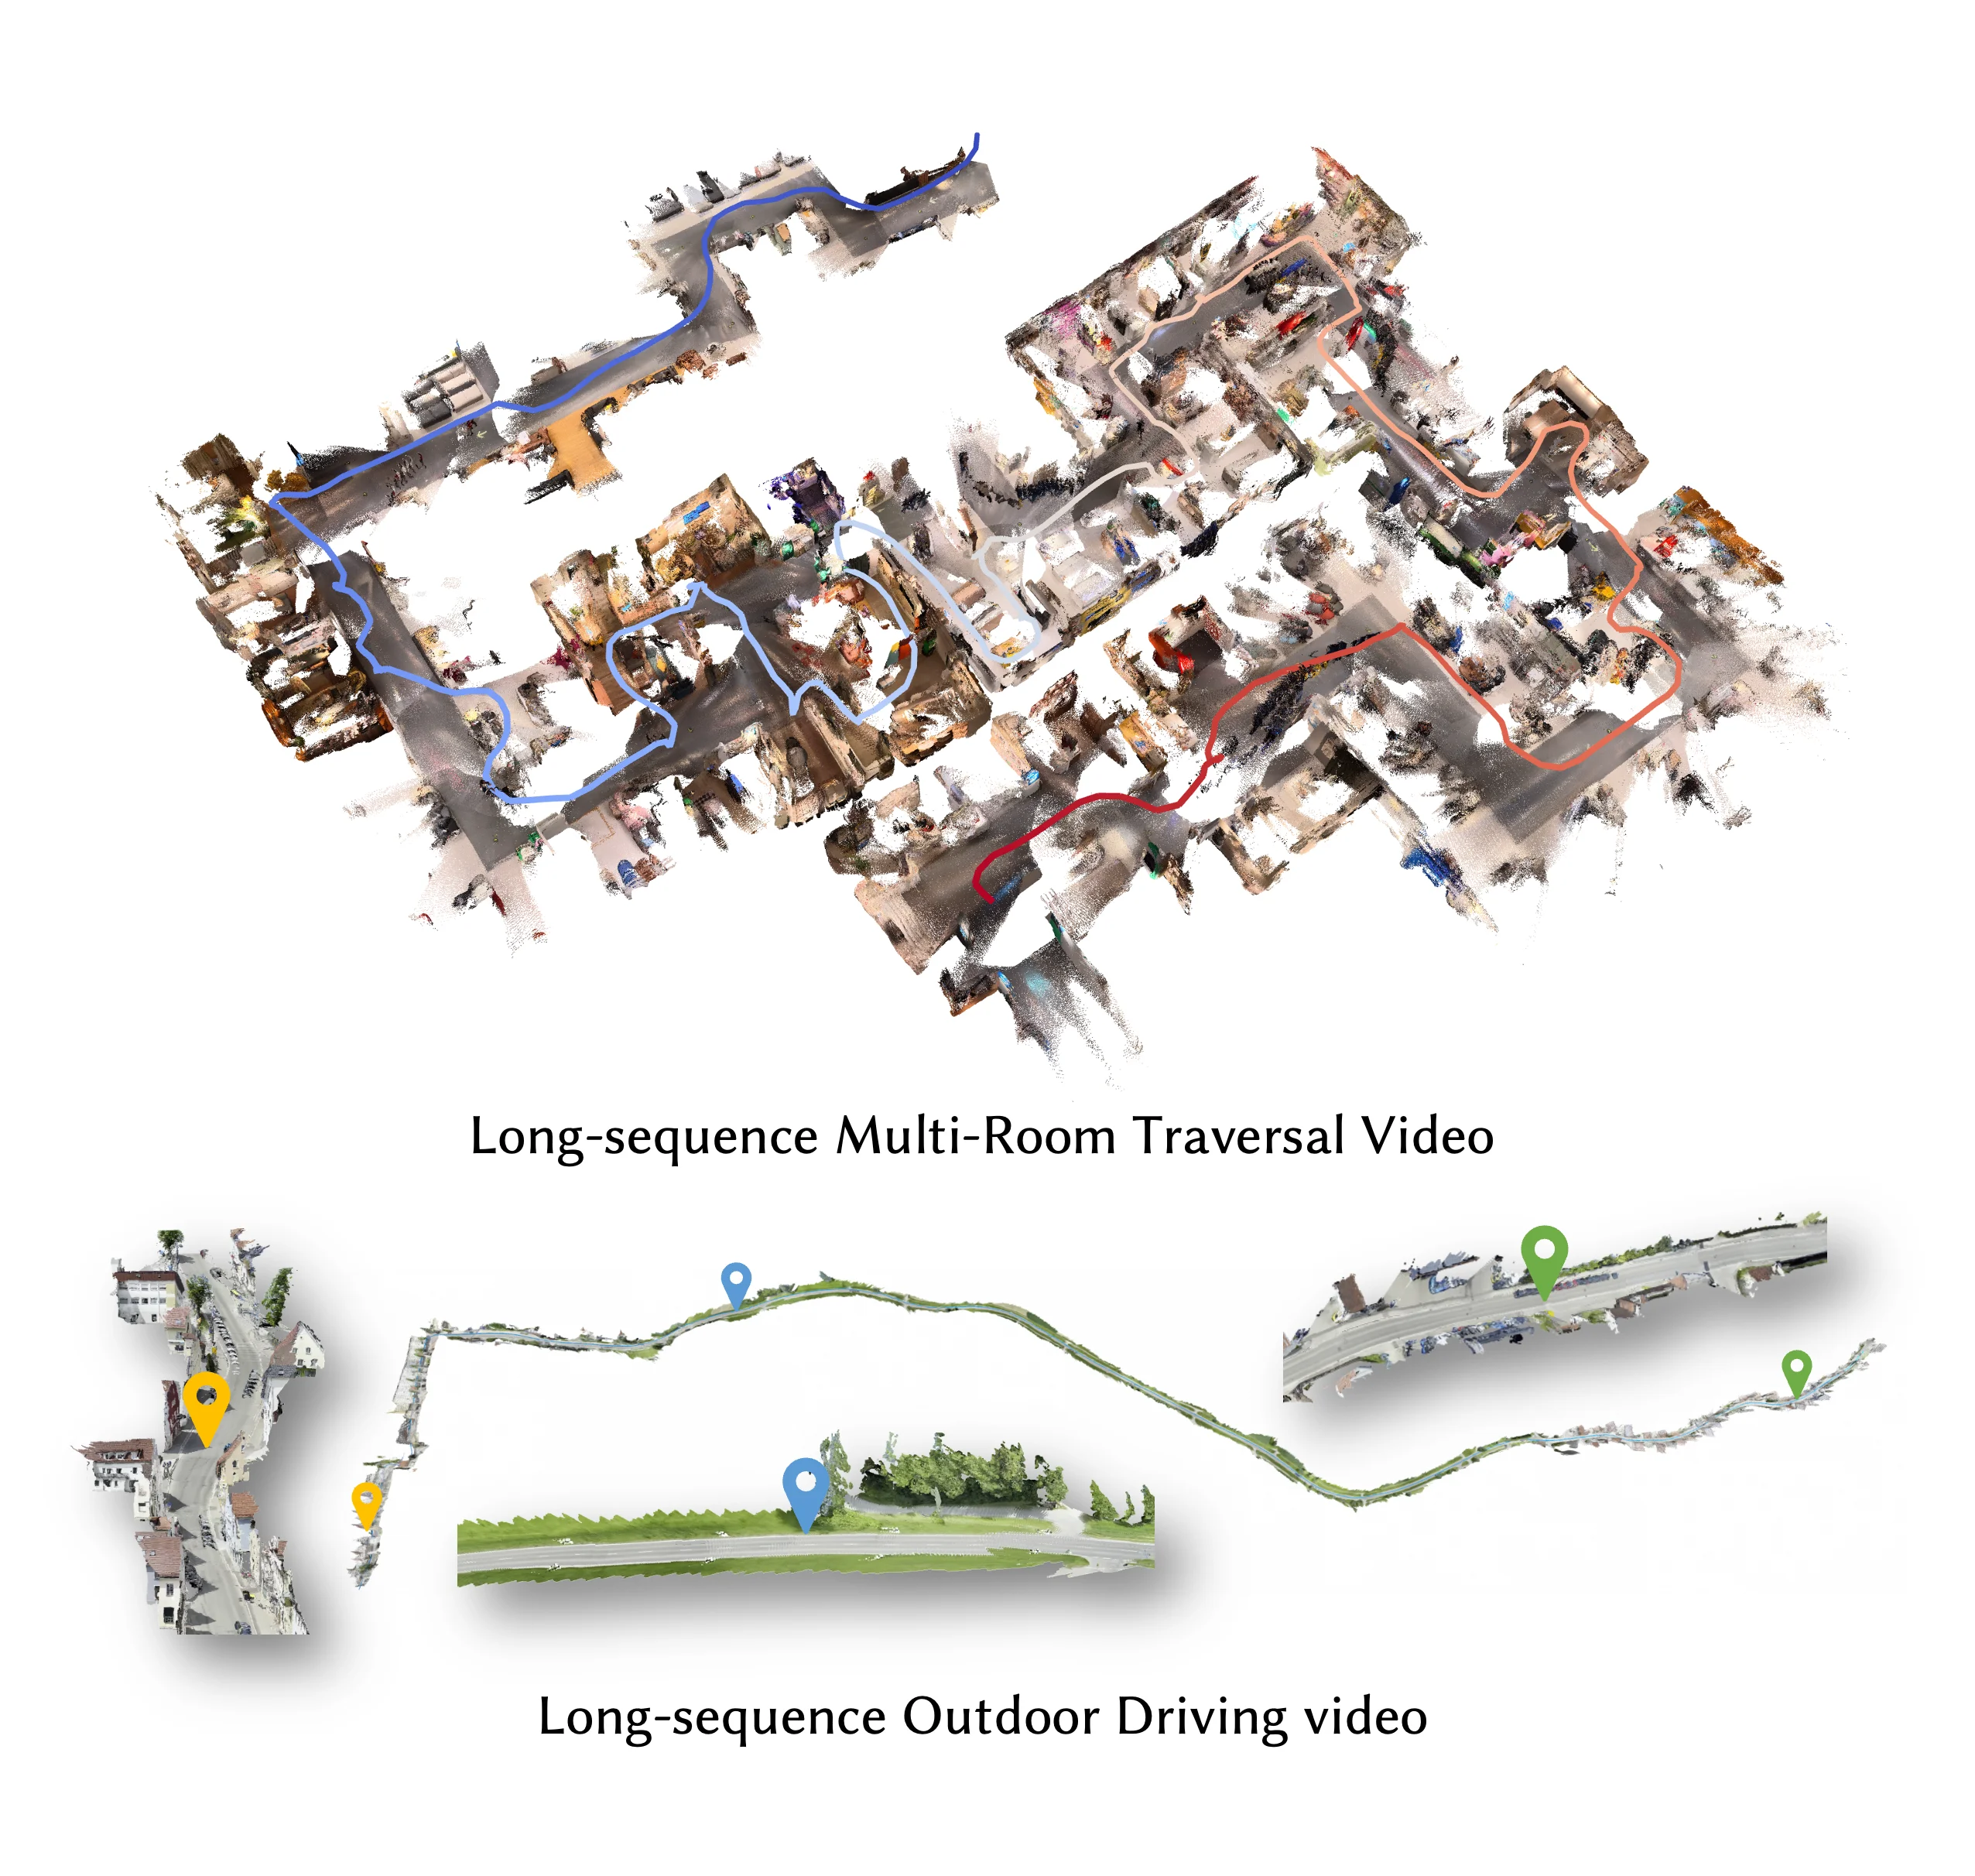
Robbyant/lingbot-map
이 프로젝트는 스트리밍 데이터를 이용해 실시간으로 3D 장면을 재구성하는 피드-포워드 방식의 3D 파운데이션 모델입니다. 입력되는 데이터를 바탕으로 주변 환경을 입체적으로 복원하여 다양한 분야에 활용될 수 있습니다.
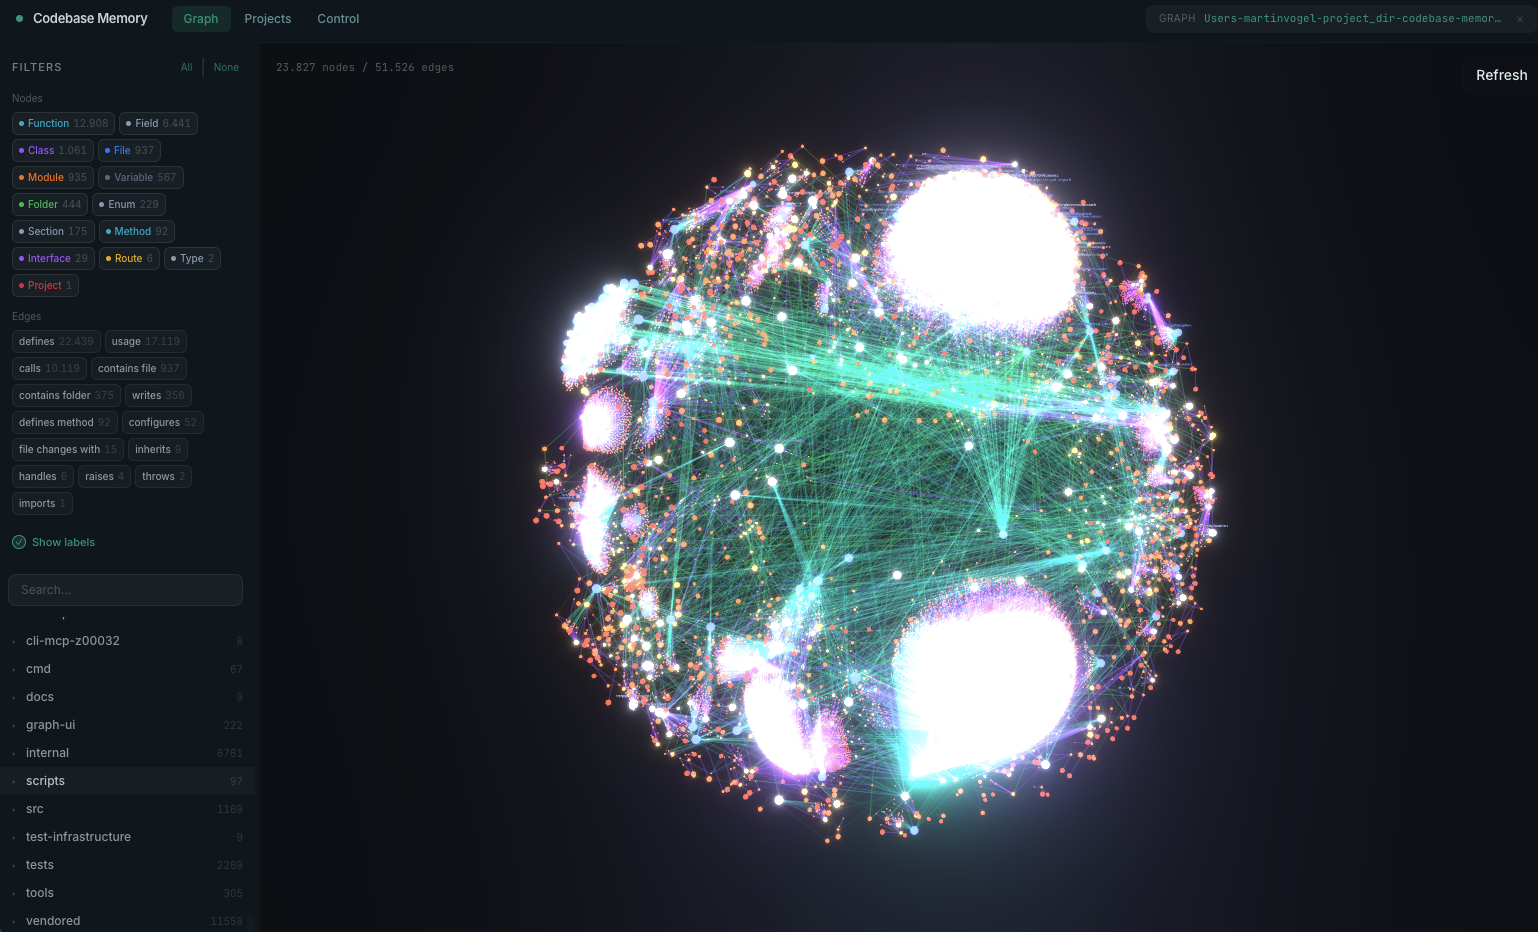
DeusData/codebase-memory-mcp
이 프로젝트는 코드베이스 전체를 영구적인 지식 그래프로 색인화하는 고성능 코드 인텔리전스 서버입니다. 158개 언어를 지원하며 밀리초 단위로 리포지토리를 분석하고, 종속성 없는 단일 바이너리로 실행되어 토큰 사용량을 99%까지 줄여줍니다.
AI Weekly
AI Weekly Issue #508: The Cutting Edge, Across the Board
최근 AI 기술은 1.6조 파라미터의 거대 모델부터 라즈베리파이용 소형 모델까지 다양한 규모로 발전하며, 비디오 게임으로 로봇을 훈련시키고 의료 분야의 난제를 해결하는 등 전방위적인 혁신을 보여주고 있습니다. 이처럼 강력한 AI 에이전트가 스마트폰에 보편적으로 탑재되면서, 기술의 발전과 함께 새로운 보안 위협에 대한 고민도 깊어지고 있습니다.
오늘의 키워드
LLM RAG Agent Eval Distillation Prompt Vision Fine-tuning Transformer Multimodal