TencentDB-Agent-Memory — AI 에이전트용 완전 로컬 장기 기억 솔루션
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

RynnWorld-4D: 4D Embodied World Models for Robotic Manipulation
로봇이 현실 세계에서 물체를 다루려면 3D 구조뿐만 아니라 상호작용에 따른 움직임까지 예측해야 합니다. 이 논문은 RGB, 깊이(depth), 광학 흐름(optical flow)을 결합한 표현이 장면의 4D 동역학을 포착하는 물리적 기반을 제공한다고 주장합니다. 이 다중 모드 접근법은 시각적 외형, 기하학적 구조, 시간적 움직임을 통합하여 2D 비디오보다 훨씬 풍부한 표현 공간을 만들어냅니다.

AlayaWorld: Long-Horizon and Playable Video World Generation
기존의 게임 세계 제작은 많은 시간과 비용이 들고 수정이 어려웠지만, 비디오 월드 모델이 새로운 패러다임을 제시합니다. 이 모델은 현재 세계 상태와 사용자 상호작용을 바탕으로 다음 장면을 자동 회귀적으로 생성하여 플레이 가능한 세계를 만들어냅니다. 이를 통해 개발자들은 가상 환경의 모든 요소를 직접 만드는 대신, 모델을 활용하여 더 유연하고 확장성 있게 게임 세계를 구축할 수 있습니다.

RynnWorld-Teleop: An Action-Conditioned World Model for Digital Teleoperation
로봇 학습에 필요한 대규모 데이터 수집은 실제 로봇을 원격 조종해야 하는 물리적 제약 때문에 병목 현상을 겪고 있습니다. 이 연구는 실제 로봇을 생성형 월드 모델로 대체하는 ‘디지털 원격 조종’ 패러다임을 제안합니다. 이 방식에서는 조작자의 손 움직임이 로봇 중심의 생성 모델을 구동하여 고품질의 로봇 궤적 데이터를 합성하므로, 물리적 제약 없이 방대하고 다양한 데이터를 생성할 수 있습니다.

Hierarchical Sparse Attention Done Right: Toward Infinite Context Modeling
현대 LLM을 긴 컨텍스트에 적용하는 것은 어텐션의 제곱 연산 비용과 길이 외삽 성능 저하 문제로 제한됩니다. 이 논문은 언어 모델링 손실 하에서 최적의 청크 선택을 학습하는 계층적 랜드마크 희소(HiLS) 어텐션 메커니즘을 제안합니다. HiLS는 기존 희소 어텐션의 부정확한 청크 선택 문제를 해결하여, 전체 어텐션의 성능을 유지하면서도 무한에 가까운 컨텍스트 모델링을 가능하게 합니다.

Vision as Unified Multimodal Generation
이 연구는 컴퓨터 비전의 다양한 과제들을 개별적인 아키텍처 없이 통합된 멀티모달 생성 문제로 재정의합니다. 제안된 SenseNova-Vision 모델은 자연어 지시와 시각적 프롬프트를 입력받아, 과제에 따라 텍스트, 이미지, 또는 혼합된 형태로 응답을 생성합니다. 이 접근법은 특정 과제에 종속된 아키텍처 없이, 단일 모델의 텍스트 및 이미지 생성 공간 안에서 이질적인 시각적 과제들을 통합적으로 처리할 수 있게 합니다.
Hugging Face Blog
RynnWorld-4D: 4D Embodied World Models for Robotic Manipulation
로봇이 현실 세계의 물체를 정교하게 다루기 위해서는 3D 구조와 함께 시간의 흐름에 따른 움직임까지 예측하는 4D 월드 모델이 필요합니다. RynnWorld-4D는 RGB, 깊이, 광학 흐름(optical flow) 데이터를 동기화하여 장면의 동역학을 물리적으로 표현함으로써, 기존 2D 영상보다 훨씬 풍부한 시공간적 이해를 가능하게 합니다.
RynnWorld-Teleop: An Action-Conditioned World Model for Digital Teleoperation
로봇 학습을 위한 데이터 수집은 실제 장비와 작업 공간에 얽매이는 물리적 원격 조종 방식 때문에 한계가 있었습니다. RynnWorld-Teleop은 실제 로봇을 생성형 월드 모델로 대체하는 ‘디지털 원격 조종’ 개념을 도입하여, 운영자가 물리적 제약 없이 손의 움직임만으로 방대하고 다양한 궤적 데이터를 생성할 수 있게 합니다.
Vision as Unified Multimodal Generation
이 연구는 다양한 컴퓨터 비전 과제들을 과제별 특화 아키텍처 없이, 하나의 통합된 멀티모달 생성 문제로 접근하는 새로운 패러다임을 제안합니다. SenseNova-Vision 모델은 자연어 지시를 통해 과제를 이해하고, 분류 결과 같은 상징적 출력은 텍스트로, 공간 예측 같은 조밀한 출력은 이미지로 생성하여 이질적인 작업들을 단일 모델 내에서 처리합니다.
GitHub Trending
addyosmani/agent-skills
AI 코딩 에이전트를 위한 프로덕션 수준의 엔지니어링 기술을 제공하는 프로젝트입니다. 실제 현업에서 사용할 수 있는 견고한 코드를 생성하도록 AI 에이전트의 능력을 향상시키는 데 중점을 둡니다.
TencentCloud/TencentDB-Agent-Memory
AI 에이전트에게 완전한 로컬 환경의 장기 기억장치를 제공하는 기술입니다. 4단계 파이프라인을 통해 외부 API 의존성 없이 에이전트가 정보를 오랫동안 기억하고 활용할 수 있게 해줍니다.
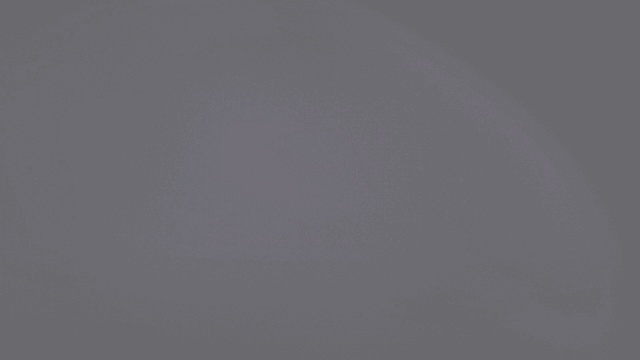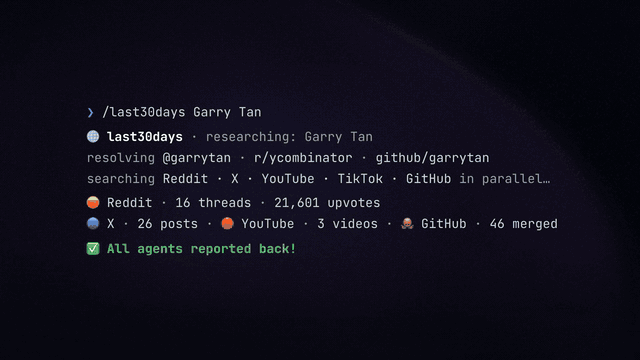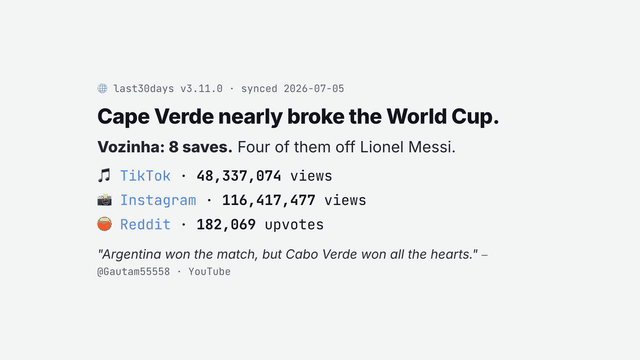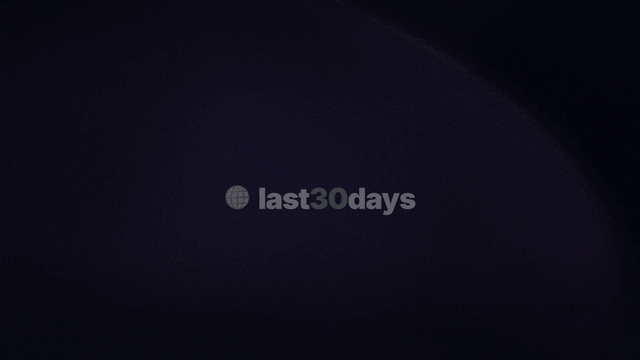
mvanhorn/last30days-skill
이 AI 에이전트 스킬은 레딧, X, 유튜브 등 다양한 웹 플랫폼에서 특정 주제를 리서치하는 능력을 제공합니다. 수집한 정보를 종합하여 근거에 기반한 요약문을 생성해주는 강력한 정보 분석 도구입니다.
iOfficeAI/OfficeCLI
OfficeCLI는 AI 에이전트가 워드, 엑셀, 파워포인트 파일을 읽고 편집하며 자동화할 수 있도록 설계된 최초의 오피스 도구입니다. 별도의 오피스 프로그램 설치 없이 단일 실행 파일로 동작하는 무료 오픈소스 프로젝트입니다.
asgeirtj/system_prompts_leaks
이 저장소는 Claude, GPT, Gemini 등 주요 AI 모델에서 추출된 시스템 프롬프트를 모아놓은 곳입니다. 개발자들은 이 프롬프트들을 통해 각 AI 모델의 동작 방식과 특성을 깊이 있게 파악할 수 있습니다.
오늘의 키워드
LLM Long Context Multimodal Prompt Agent AI Coding AI Agent GPT Cursor