Vidu S1 — 실시간 상호작용 가능한 영상 생성 모델
· #AI #LLM #트렌드 #기술블로그
arXiv 논문
Vidu S1: A Real-Time Interactive Video Generation Model
Vidu S1은 음성 명령으로 디지털 캐릭터를 제어하며 실시간으로 상호작용할 수 있는 영상 생성 모델입니다. 이 모델은 일반 소비자용 GPU에서도 고화질 영상을 끊김이나 왜곡 없이 무한한 길이로 생성할 수 있으며, 사용자가 직접 업로드한 이미지로도 캐릭터를 만들 수 있습니다.
Accurate, Interdisciplinary and Transparent Structure-property Understanding with Deep Native Structural Reasoning
생물학, 화학, 재료 과학 분야에서 구조와 속성 간의 관계를 이해하는 것은 매우 중요하지만, 기존 AI는 이를 과학적 원리에 기반하여 설명하는 데 한계가 있었습니다. 이 연구는 ‘심층 네이티브 구조 추론’이라는 새로운 AI 접근법을 제안하여, 다양한 과학 분야에 걸쳐 구조적 증거를 정확하고 투명하게 해석함으로써 이러한 문제를 해결합니다.

Video-Oasis: Rethinking Evaluation of Video Understanding
기존 영상 이해 모델(Video-LLM)의 벤치마크 성능이 실제 시각적 인식 능력 때문인지, 언어적 추론 능력이나 사전 지식 덕분인지 명확히 구분하기 어렵다는 문제가 있습니다. 이 연구는 새로운 벤치마크를 제시하는 대신, ‘Video-Oasis’라는 평가 기준 재검토 프레임워크를 도입하여 영상 이해 능력을 보다 근본적이고 신뢰도 높게 평가하는 방법을 제안합니다.

Dual Latent Memory in Vision-Language-Action Models for Robotic Manipulation
현재의 관찰에만 의존하는 주류 시각-언어-행동(VLA) 모델은 시간적 맥락이 중요한 장기 로봇 조작 과제 수행에 어려움을 겪습니다. 이 연구는 VLA 모델의 잠재 공간 내에 과거 경험을 직접 통합하는 ‘이중 잠재 기억(Dual Latent Memory)’ 구조를 제안하여, 로봇이 과거와 현재 정보를 유기적으로 결합해 더 복잡한 작업을 성공적으로 수행하도록 돕습니다.
Scaling Mixture-of-Experts Video Pretraining for Embodied Intelligence
로봇 제어에 영상 생성 모델을 활용하려는 시도가 늘고 있지만, 기존 모델들은 시각적 품질과 창의성에 초점을 맞춰 개발되어 연산 효율성과 물리적 현실성이 중요한 로봇 지능에는 적합하지 않았습니다. 이 연구는 ‘LingBot-Video’라는 새로운 영상 사전 훈련 패러다임을 제시하며, 전문가 혼합(MoE) 아키텍처를 채택하여 로봇 지능에 특화된 계산 효율성과 물리적 현실성을 확보합니다.
Hugging Face Blog
LongE2V: Long-Horizon Event-based Video Reconstruction, Prediction, and Frame Interpolation with Video Diffusion Models
LongE2V는 희소한 이벤트 스트림 데이터로부터 고품질 비디오를 복원하는 새로운 접근법입니다. 사전 훈련된 비디오 확산 모델을 미세 조정하여 비디오 재구성, 예측, 프레임 보간 작업을 동시에 처리하며, 이를 통해 데이터 효율성과 시각적 품질을 크게 향상시켰습니다.
UniClawBench: A Universal Benchmark for Proactive Agents on Real-World Tasks
UniClawBench는 LLM 기반의 최신 AI 에이전트가 실제 환경에서 도구를 사용하는 능력을 평가하기 위한 새로운 벤치마크입니다. 기존 벤치마크의 한계인 가상 환경 및 단일 평가 방식에서 벗어나, 현실 세계의 복잡한 작업을 수행하는 에이전트의 성능을 보다 효과적으로 측정할 수 있도록 설계되었습니다.
Enhancing In-context Panoramic Generation via Geometric-aware Pretraining
Canvas360은 기하학적 구조를 고려한 사전 훈련과 파인튜닝을 결합하여 고품질 파노라마 이미지를 생성하는 2단계 프레임워크입니다. 이 연구는 스타일 변환, 인페인팅 등 다양한 파노라마 생성 작업을 위해 100만 개의 고품질 샘플로 구성된 Canvas360Dataset을 함께 제안하여 데이터 부족 문제를 해결하고 뛰어난 결과물을 만들어냅니다.
GitHub Trending
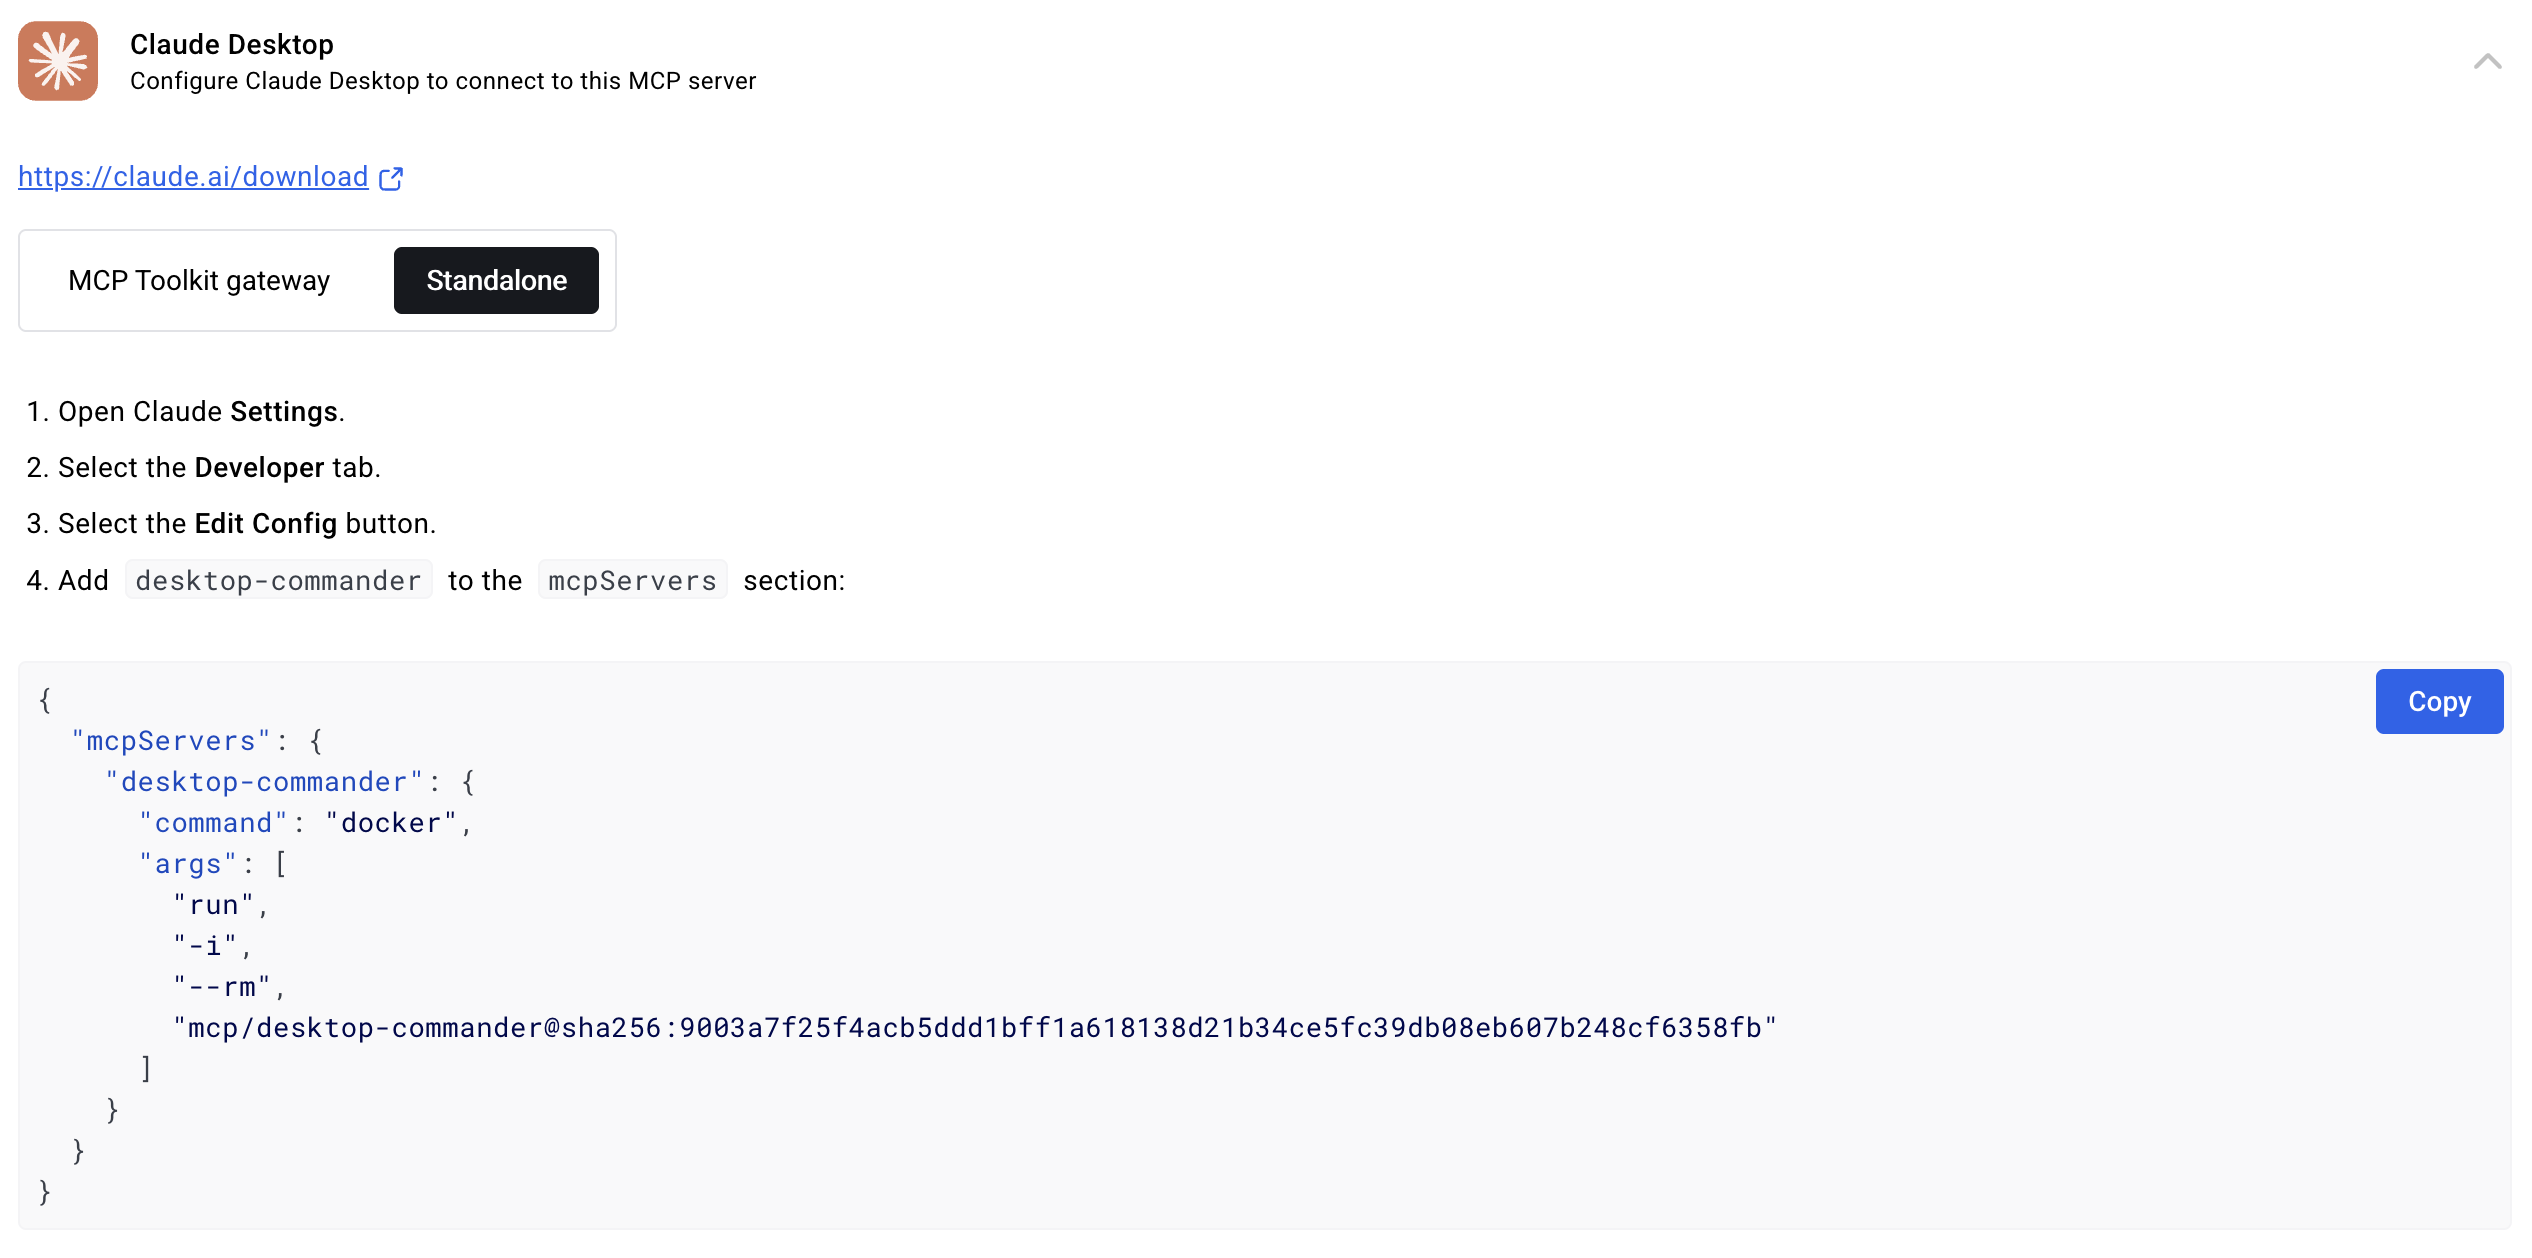
wonderwhy-er/DesktopCommanderMCP
DesktopCommanderMCP는 Claude AI 모델에게 데스크톱 제어 능력을 부여하는 서버입니다. 이 도구를 활용하면 Claude가 직접 터미널을 제어하고 파일 시스템을 검색하며, 파일을 수정하는 등 복잡한 작업을 수행할 수 있습니다.
Shubhamsaboo/awesome-llm-apps
이 프로젝트는 바로 실행해볼 수 있는 100개 이상의 AI 에이전트 및 RAG 애플리케이션을 모아놓은 목록입니다. 개발자들은 이 앱들을 복제하고 자신의 목적에 맞게 수정한 뒤, 실제 서비스로 배포하며 LLM 기반 앱 개발 경험을 쌓을 수 있습니다.
anthropics/claude-cookbooks
Claude-cookbooks는 Claude AI 모델을 재미있고 효과적으로 활용하는 방법을 담은 예제 코드 모음입니다. 개발자들은 이 ‘요리책’에 담긴 다양한 레시피를 통해 Claude의 기능을 깊이 이해하고 자신의 프로젝트에 손쉽게 적용할 수 있습니다.
Crosstalk-Solutions/project-nomad
Project N.O.M.A.D는 인터넷 연결 없이도 작동하는 오프라인 생존 컴퓨터 시스템입니다. 이 장치에는 위기 상황에 필요한 핵심 도구, 방대한 지식 데이터베이스, 그리고 AI가 탑재되어 있어 언제 어디서든 사용자의 정보 접근과 생존을 지원합니다.
virattt/ai-hedge-fund
이 프로젝트는 AI를 활용하여 완전한 헤지펀드 팀을 구축하는 것을 목표로 합니다. 여러 AI 에이전트가 각각 CEO, 분석가, 트레이더 등의 역할을 맡아 시장을 분석하고 투자 전략을 실행하는 자동화된 금융 시스템을 구현합니다.
오늘의 키워드
Reasoning LLM Eval Vision MoE Fine-tuning RAG Multimodal Agent Claude