Weak-to-Strong Generalization — 강화학습 효율 높이는 모델 일반화
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

Weak-to-Strong Generalization via Direct On-Policy Distillation
강력한 언어 모델을 강화학습으로 훈련시키는 것은 비용이 많이 듭니다. 이 연구는 먼저 더 작은 모델을 강화학습으로 훈련시킨 후, 그 학습 결과를 더 강력한 모델로 이전하는 ‘약한 모델에서 강한 모델로의 일반화’ 방법을 제안하여 훈련 효율성을 높입니다.

ABot-N1: Toward a General Visual Language Navigation Foundation Model
기존의 시각 언어 내비게이션 모델은 장거리 이동이나 복잡한 의미 이해에 어려움을 겪으며, 작동 방식을 해석하기도 어렵습니다. 이 연구는 공간적 의사결정을 위한 깊이 있는 추론 능력과 다양한 임무 수행 능력을 통합한 새로운 범용 기초 모델 ‘ABot-N1’을 제안하여 이러한 문제를 해결하고자 합니다.

ABot-AgentOS: A General Robotic Agent OS with Lifelong Multi-modal Memory
최신 로봇 기술은 인식과 행동 예측은 뛰어나지만, 장기적인 작업을 수행하기 위한 추론, 기억, 도구 사용을 관리하는 범용 시스템이 부족합니다. 이를 위해 ‘ABot-AgentOS’라는 로봇 에이전트 운영체제를 개발하여, 장면 기반 계획, 멀티모달 메모리 관리, 다단계 검증 등을 수행하는 상위 제어 계층을 제공합니다.

Long-Horizon-Terminal-Bench: Testing the Limits of Agents on Long-Horizon Terminal Tasks with Dense Reward-Based Grading
기존 AI 에이전트 벤치마크는 짧은 작업의 최종 결과만 평가하여 에이전트의 능력을 온전히 파악하기 어렵다는 한계가 있습니다. ‘Long-Horizon-Terminal-Bench’는 46개의 장기적인 작업을 포함하는 새로운 벤치마크로, 최종 결과뿐만 아니라 중간 과정까지 조밀하게 평가하여 에이전트의 능력을 더 세밀하게 측정합니다.

Video-Oasis: Rethinking Evaluation of Video Understanding
비디오-LLM의 성능이 실제 시각적 이해 능력 때문인지, 언어 추론 능력이나 사전 지식 때문인지 구별하기 어렵다는 문제가 있습니다. 이 연구는 새로운 벤치마크를 제시하는 대신, ‘Video-Oasis’라는 평가 프레임워크를 통해 비디오 이해 능력을 평가하는 기준 자체를 재검토하여 모델의 성능을 더 명확하게 분석합니다.
Hugging Face Blog
AdvancedMathBench: A Benchmark Suite for Advanced Mathematical Proof Generation and Verification
대규모 언어 모델(LLM)이 고등 수학 분야에서 어느 정도의 성능을 보이는지는 아직 명확히 알려지지 않았습니다. 기존 벤치마크는 평가 범위가 좁고 추론 과정의 타당성을 제대로 검증하지 못하는 한계가 있었는데, 이를 해결하기 위해 고급 수학 증명 생성 및 검증을 위한 새로운 벤치마크인 ‘AdvancedMathBench’가 제안되었습니다.
Metacognition in LLMs: Foundations, Progress, and Opportunities
메타인지, 즉 자신의 생각에 대해 생각하는 능력은 지능의 핵심 요소이지만, LLM이 이 능력을 얼마나, 어떻게 발휘할 수 있는지는 아직 불분명합니다. 이 연구는 LLM의 메타인지 능력에 대한 기초와 현재까지의 연구 동향을 살펴보고, 향후 발전 가능성과 기회를 탐색합니다.
MET: Theory-Grounded and Culture-Aware Multilingual Moral Reasoning
언어 모델이 다양한 언어와 문화권에서 도덕적 판단을 내리는 데 사용되고 있지만, 기존 연구는 문화적 특수성을 무시한 번역 기반 평가와 영어 중심적인 추론 방식의 한계를 보였습니다. 이 문제를 해결하기 위해, 본 연구는 도덕 이론에 기반하고 문화적 인식을 갖춘 다국어 도덕 추론 방법론 ‘MET’를 제안합니다.
무신사 기술블로그
MATCH란 무엇인가
무신사는 매일 쌓이는 방대한 고객 데이터를 실질적인 비즈니스 가치로 전환하기 위해 개인화 인프라 MATCH를 구축하고 있습니다. 단순히 데이터를 수집하고 분석하는 것을 넘어, 적시에 활용하여 수익을 창출하는 ‘진짜 자산’으로 만드는 것이 핵심 목표입니다.
GitHub Trending
Shubhamsaboo/awesome-llm-apps
이 저장소는 100개가 넘는 AI 에이전트 및 RAG 기반 애플리케이션을 모아놓은 컬렉션입니다. 사용자는 이 앱들을 직접 복제하고 맞춤화하여 실제 서비스로 배포할 수 있어, 실용적인 AI 개발에 큰 도움이 됩니다.

mattpocock/skills
이 프로젝트는 실제 현업 엔지니어에게 필요한 기술들을 정리한 자료입니다. 특히 Claude AI 모델을 활용하여 얻은 노하우와 프롬프트들이 포함되어 있어, AI를 이용한 개발 생산성 향상에 유용한 팁을 제공합니다.
virattt/ai-hedge-fund
이 프로젝트는 AI를 활용하여 헤지펀드 팀을 구성하고 운영하는 것을 목표로 합니다. 다양한 AI 에이전트들이 각각 분석가, 트레이더 등의 역할을 수행하며 금융 시장에서 투자 결정을 내리는 시스템을 구현합니다.
Nutlope/hallmark
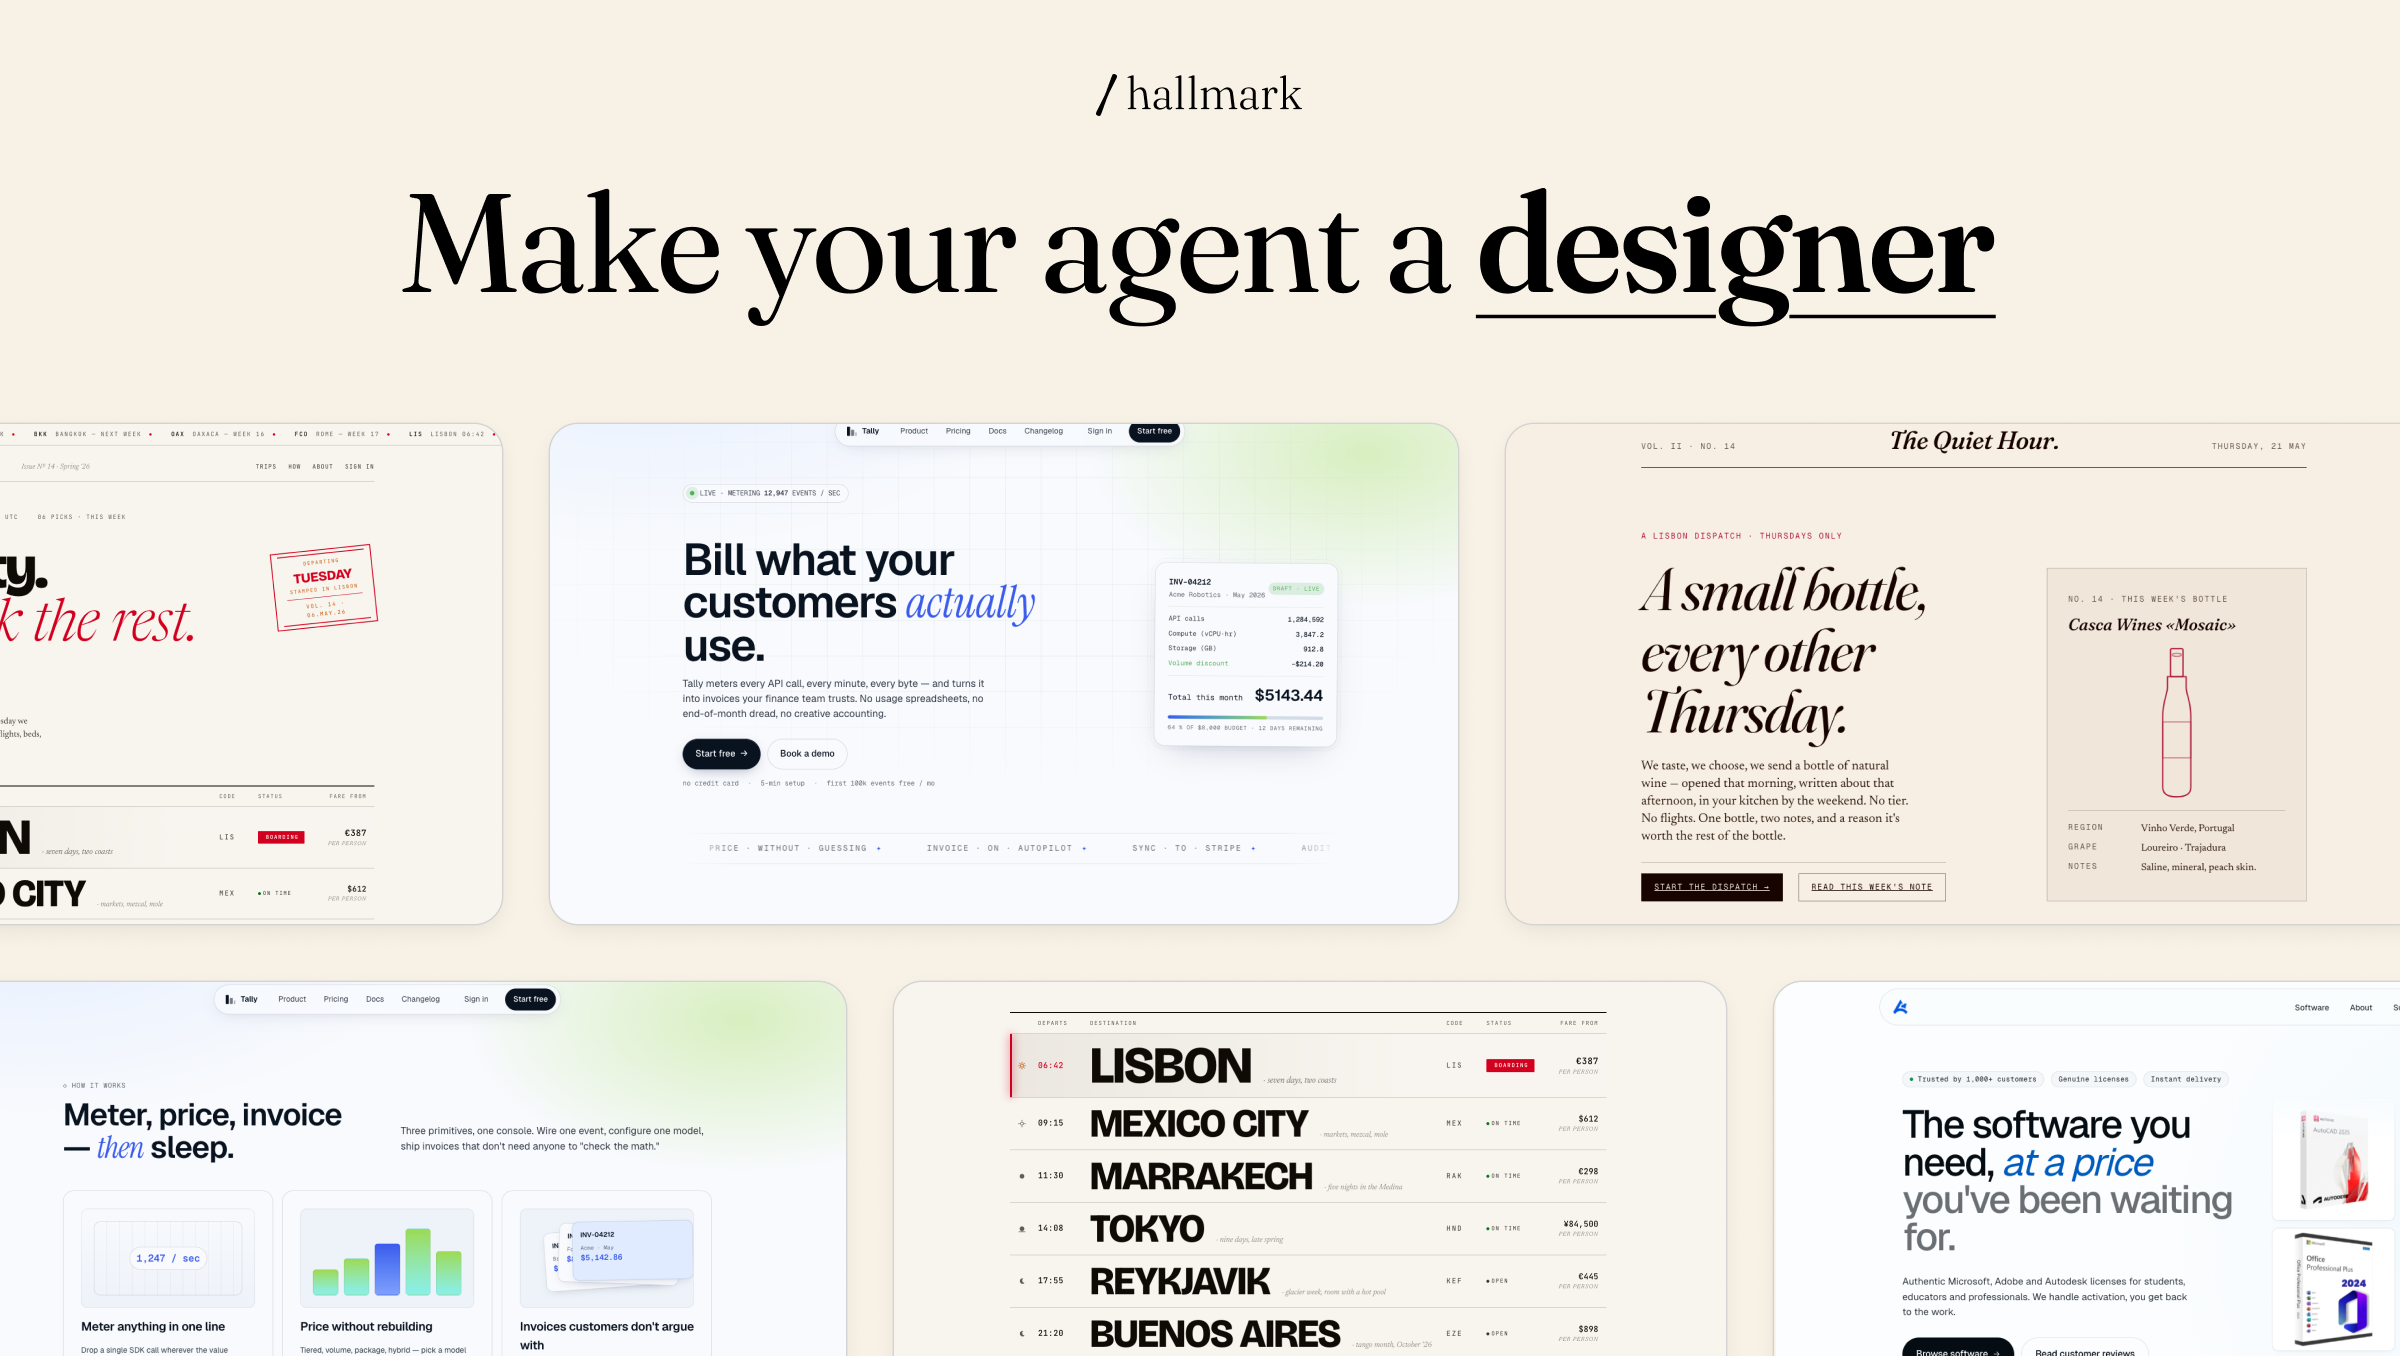
이 프로젝트는 Claude Code나 Cursor 같은 AI 코딩 도우미를 사용할 때 발생하는 품질 저하 문제를 방지하기 위한 디자인 기술을 제공합니다. 이를 통해 AI가 생성하는 일반적이거나 조잡한 코드를 피하고 더 정교하고 품질 높은 결과물을 얻을 수 있습니다.
hasaneyldrm/exercises-dataset
이 자료는 1,324개의 피트니스 운동 정보를 담고 있는 방대한 데이터셋입니다. 각 운동의 애니메이션 GIF, 관련 근육 및 장비 정보, 6개 언어로 된 단계별 설명이 포함되어 있어 피트니스 앱 개발에 유용하게 활용될 수 있습니다.
오늘의 키워드
Reasoning Distillation Tool Use Agent AI Agent Eval LLM RAG Vision Grounding