Robbyant/lingbot-map — 스트리밍 데이터 기반 3D 장면 재구성 모델
· #AI #LLM #트렌드 #기술블로그
arXiv 논문
LongStraw: Long-Context RL Beyond 2M Tokens under a Fixed GPU Budget
최근 AI 모델의 추론 컨텍스트 길이는 수백만 토큰에 달하지만, 강화학습(RL) 후속 훈련은 여전히 수십만 토큰 수준에 머물러 한계가 있었습니다. LongStraw는 고정된 GPU 예산 내에서도 2백만 토큰 이상의 긴 컨텍스트를 처리할 수 있는 강화학습 후속 훈련 스택을 제안하여, 긴 대화나 복잡한 작업을 수행하는 AI 에이전트의 성능을 크게 향상시킬 수 있습니다.
Boogu-Image-0.1: Boosting Open-Source Unified Multimodal Understanding and Generation
Boogu-Image-0.1은 텍스트-이미지 생성, 빠른 추론, 지시 기반 편집, 그리고 한-영 이중 언어 텍스트 렌더링에서 뛰어난 성능을 보이는 오픈소스 통합 멀티모달 모델군입니다. 이 모델은 Base, Turbo, Edit 등 다양한 버전을 제공하며, 폐쇄적인 상용 모델에 필적하는 강력한 성능을 오픈소스 커뮤니티에 제공하는 것을 목표로 합니다.

VideoChat3: Fully Open Video MLLM for Efficient and Generalist Video Understanding
기존 오픈소스 비디오 모델들은 특정 영역에서만 효과적이거나 높은 연산 비용을 요구하는 등 여러 한계를 가지고 있었습니다. VideoChat3는 다양한 유형의 비디오를 효율적으로 이해하는 범용 비디오 멀티모달 거대 언어 모델(MLLM)로, 훈련 데이터와 코드를 포함한 모든 구성 요소를 완전히 공개하여 접근성을 높였습니다.

Ring-Zero: Scaling Zero RL to a Trillion Parameters for Emergent Reasoning
인간의 데이터 없이 검증 가능한 보상을 통해 연쇄적 사고(chain-of-thought) 추론 능력을 이끌어내는 제로 강화학습(Zero RL)은 주로 소규모 모델에서만 연구되어 왔습니다. Ring-Zero는 이러한 제로 강화학습을 조 단위 파라미터 모델까지 확장하는 새로운 방법론으로, 대규모 모델에서 나타나는 새로운 추론 능력의 발현과 훈련 동역학을 탐구합니다.

SEED: Self-Evolving On-Policy Distillation for Agentic Reinforcement Learning
도구 사용과 같은 긴 작업을 수행하는 AI 에이전트를 강화학습으로 훈련할 때, 최종 결과에만 주어지는 희소한 보상 신호는 중간 과정의 학습을 어렵게 만듭니다. SEED는 에이전트가 스스로 성공적인 과거 행동으로부터 지식을 증류하여 토큰 수준의 정책 학습을 위한 조밀한 감독 신호를 생성하는 새로운 방법론으로, 이를 통해 복잡한 작업을 더 효과적으로 학습할 수 있습니다.
Hugging Face Blog
SearchOS-V1: Towards Robust Open-Domain Information-Seeking Agent Collaboration
현재 웹 검색을 활용하는 정보 탐색 에이전트들은 검색 기록이 길어지면 작업 진행 상황을 추적하기 어려워하고, 검색 실패 시 반복적인 루프에 빠지는 문제가 있습니다. 이를 해결하기 위해 SearchOS는 다중 에이전트 협업 시스템을 도입하여, 에이전트가 작업 상태를 효과적으로 관리하고 검색 예산을 낭비하지 않도록 도와 최종 결과물의 품질을 향상시킵니다.
RoboTTT: Context Scaling for Robot Policies
기존 로봇 파운데이션 모델들은 단일 단계나 짧은 기록만을 활용하는 한계가 있었지만, RoboTTT는 추론 지연 시간 증가 없이 시각-운동 컨텍스트를 8K 타임스텝까지 확장하는 새로운 로봇 모델 및 학습 방법입니다. 이처럼 확장된 컨텍스트 덕분에 인간의 비디오 시연을 한 번만 보고 모방하거나 실시간으로 정책을 개선하는 등 새로운 로봇 능력을 구현할 수 있게 되었습니다.
MeanFlowNFT: Bringing Forward-Process RL to Average-Velocity Generators
MeanFlow 생성 모델은 평균 속도를 예측하여 빠르고 효율적인 샘플링이 가능하지만, 강화학습(RL)을 적용하여 인간의 선호도에 맞게 조정하는 데는 어려움이 있었습니다. MeanFlowNFT는 기존 확산 모델에 효과적이었던 순방향 프로세스 강화학습 프레임워크를 MeanFlow 모델에 성공적으로 적용하여, 복잡한 과정 없이도 생성 모델을 효율적으로 최적화할 수 있게 해줍니다.
GitHub Trending
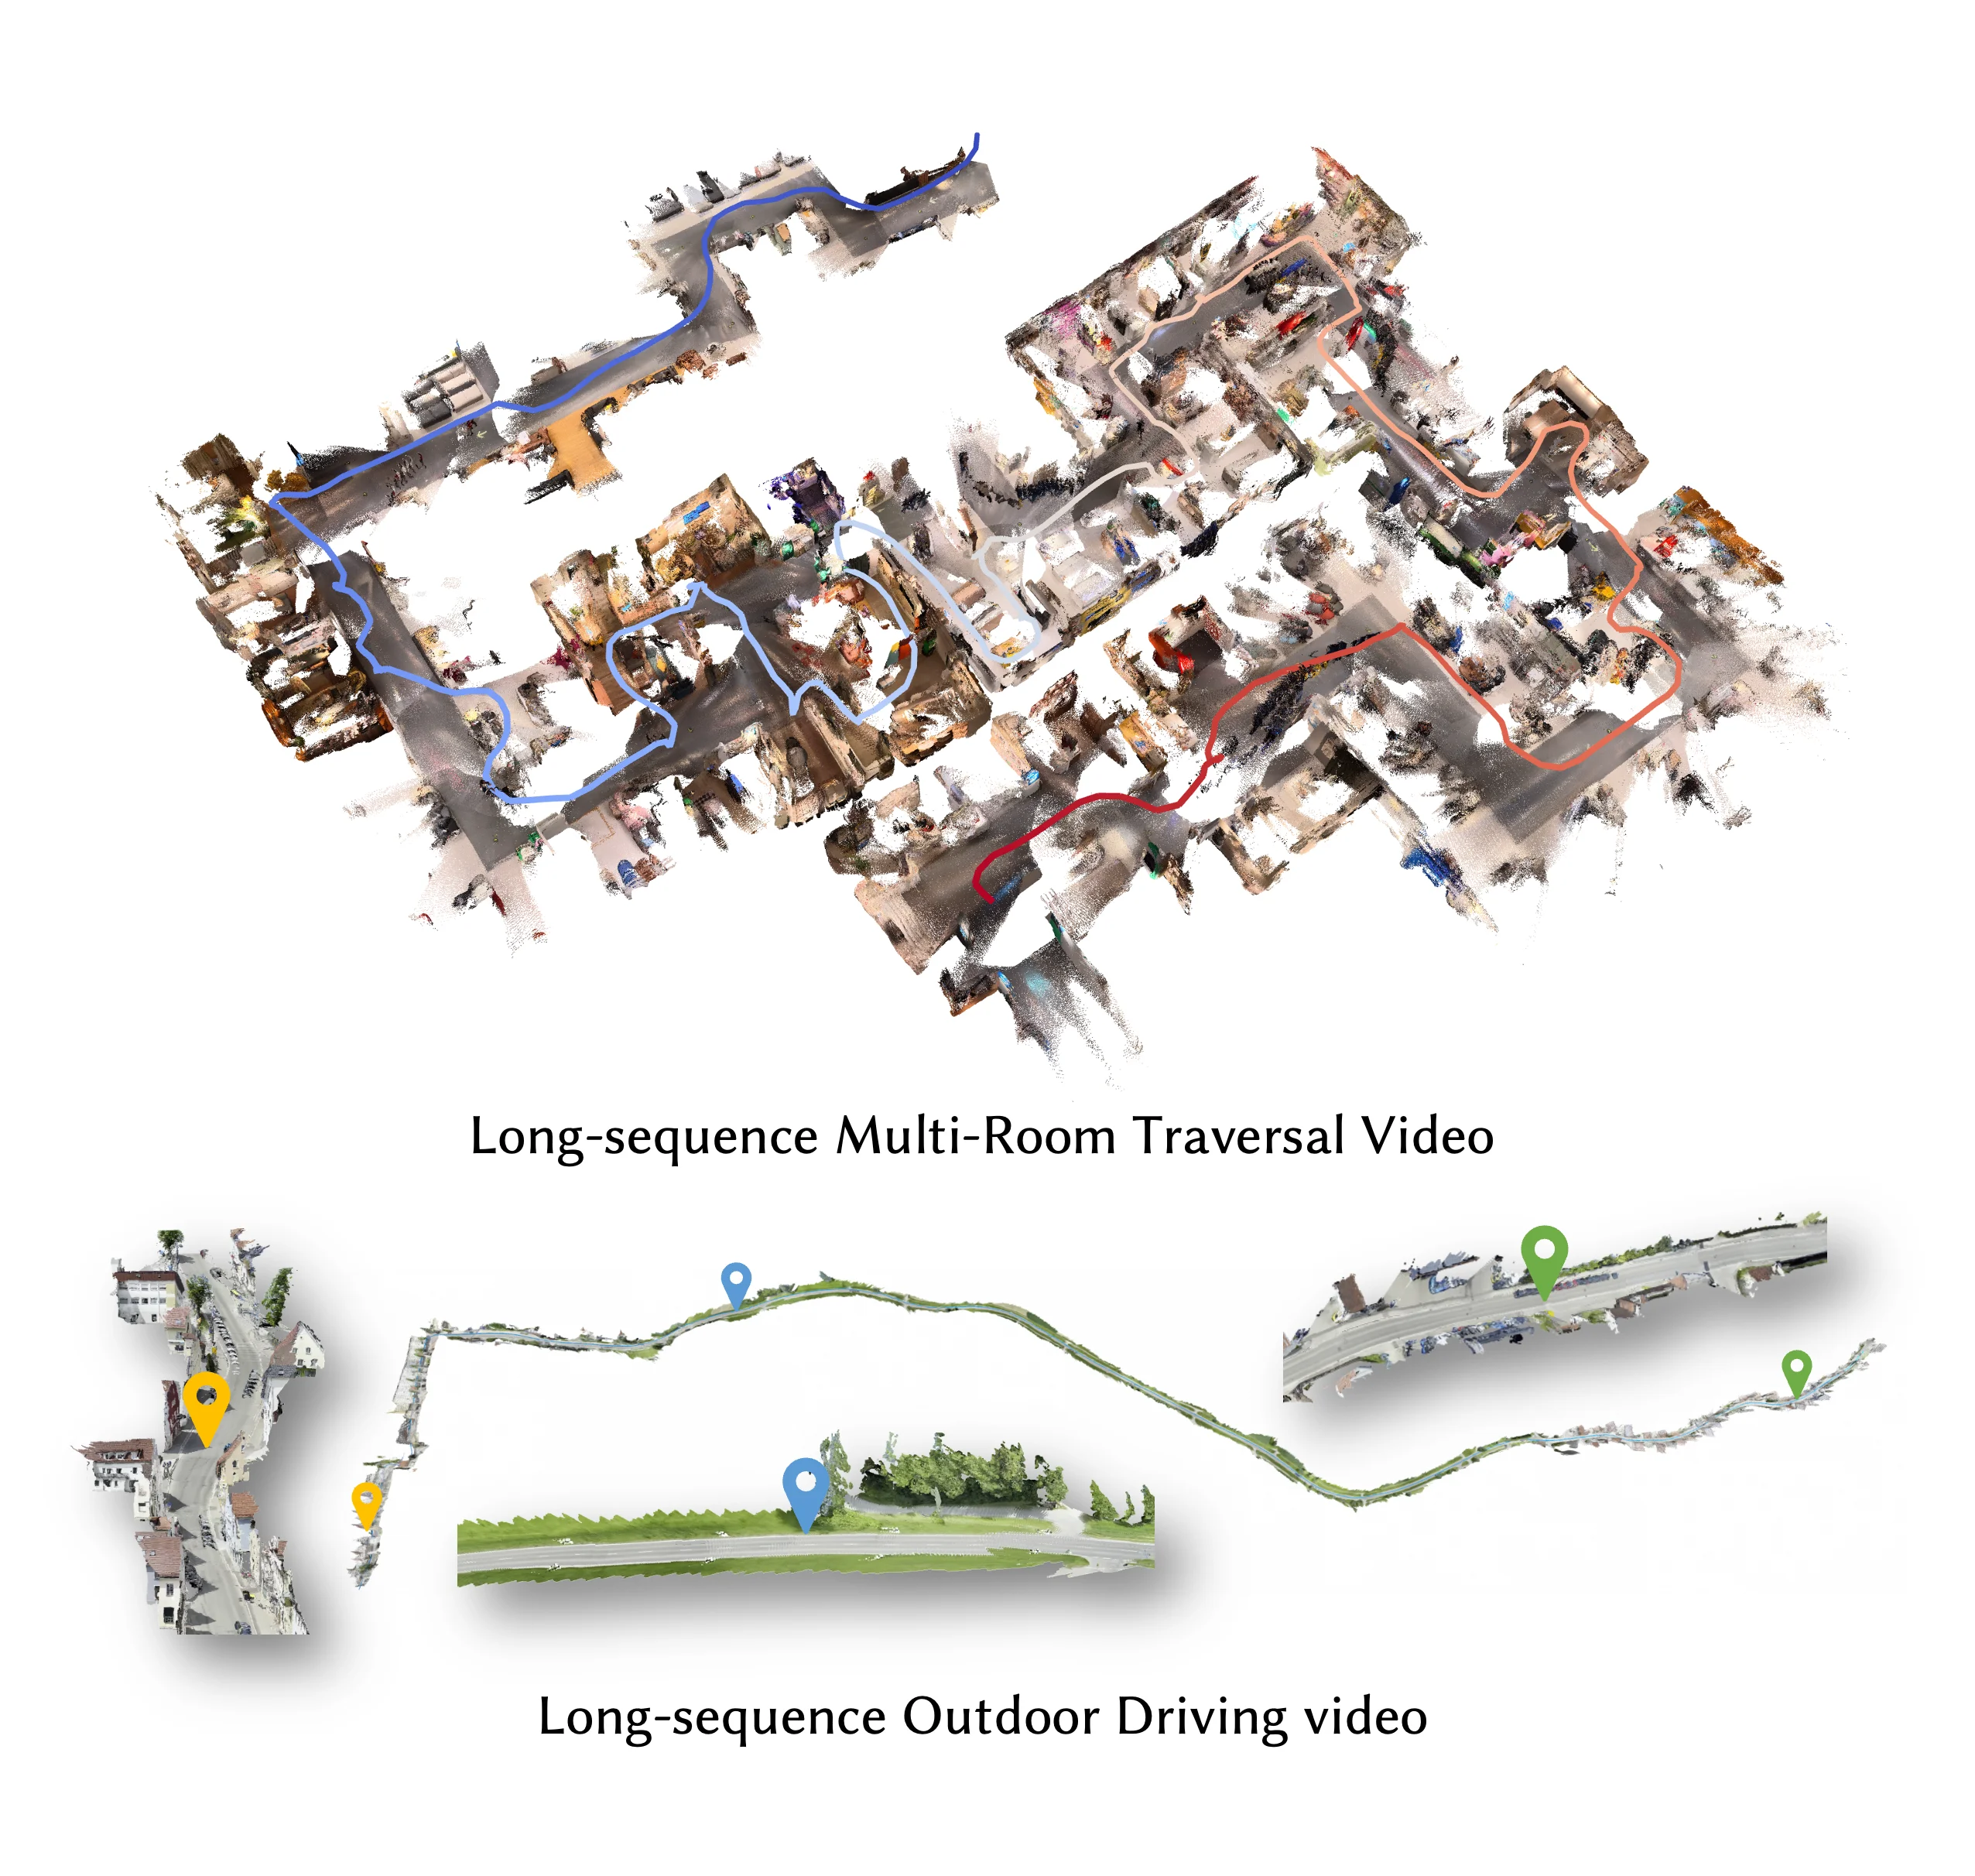
Robbyant/lingbot-map
스트리밍 데이터를 기반으로 3D 장면을 재구성하는 피드-포워드 방식의 파운데이션 모델입니다. 이 프로젝트는 실시간으로 들어오는 데이터를 활용하여 3차원 공간을 효과적으로 만들어냅니다.
apache/ossie
아파치 Ossie는 분석, AI, BI 플랫폼 간에 시맨틱 메타데이터를 교환하는 방식을 표준화하기 위한 산업 표준 사양입니다. 특정 벤더에 종속되지 않는 중립적인 방식으로 시맨틱 데이터에 대한 단일 진실 공급원(single source of truth)을 제공하는 것을 목표로 합니다.

PostHog/posthog
PostHog는 자율적으로 동작하는 제품을 구축하기 위한 선도적인 플랫폼입니다. AI 관찰 가능성, 분석, 세션 리플레이, 오류 추적 등 개발자에게 필요한 다양한 도구를 제공하여 문제 진단과 기회 발견을 돕고 제품 개선을 가속화합니다.
rohitg00/ai-engineering-from-scratch
AI 엔지니어링을 처음부터 학습하고, 직접 구축하며, 다른 사람들을 위해 배포하는 전 과정을 다루는 학습 자료입니다. 이론부터 실제 제품 출시까지의 경험을 체계적으로 배울 수 있도록 구성되어 있습니다.
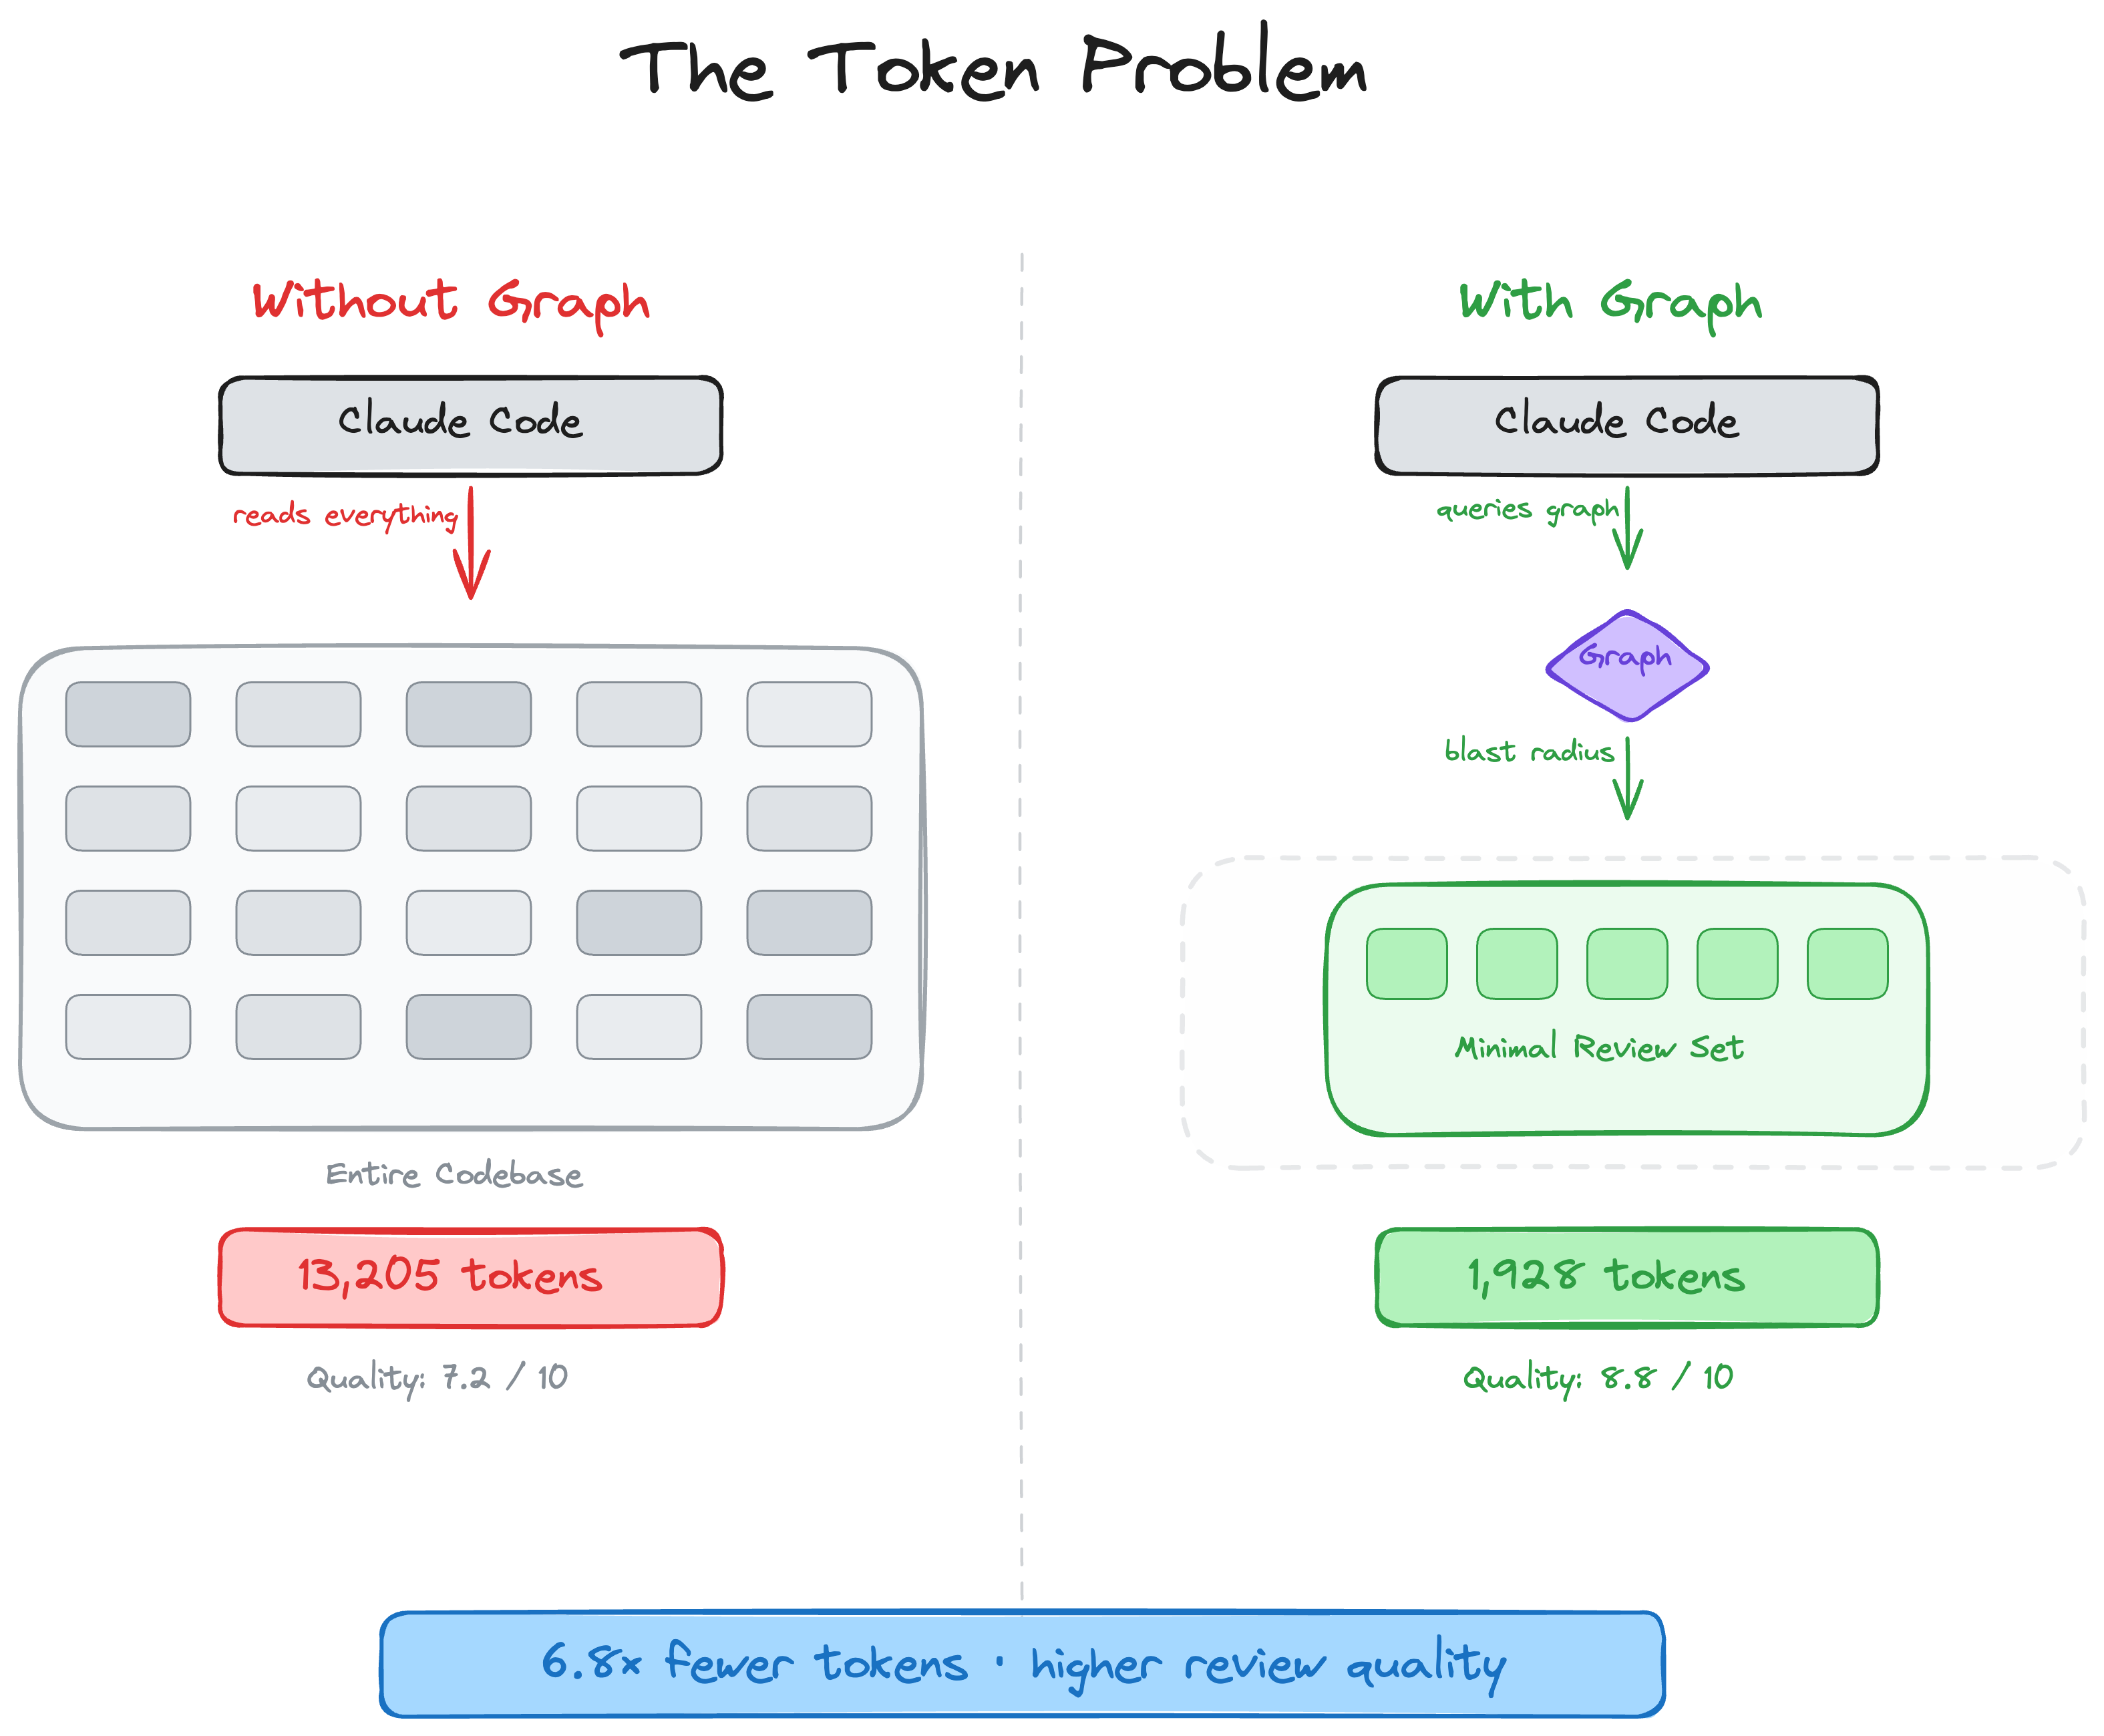
tirth8205/code-review-graph
로컬 우선 방식으로 동작하는 코드 인텔리전스 그래프 도구로, 코드베이스의 영구적인 맵을 생성합니다. 이를 통해 AI 코딩 도구가 코드 리뷰나 대규모 저장소 작업 시 불필요한 정보 없이 핵심적인 컨텍스트만 읽도록 도와 생산성을 높여줍니다.
오늘의 키워드
Inference AI Agent GPT LLM Reasoning Chain-of-Thought Vision Distillation Tool Use Agent