worldmonitor — AI 기반 실시간 글로벌 인텔리전스 대시보드
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

TimeLens2: Generalist Video Temporal Grounding with Multimodal LLMs
기존 멀티모달 LLM은 영상 속 사건을 설명할 수는 있지만, 그 사건이 언제 일어났는지 정확히 찾아내지는 못합니다. ‘TimeLens2’는 영상 길이, 도메인, 질문 형태에 구애받지 않고 질문에 해당하는 증거 구간을 정확히 예측하는 범용 비디오 시간대 특정(temporal grounding) 모델로, 다양한 영상에서 특정 장면의 발생 시점을 효과적으로 찾아냅니다.

RESOURCE2SKILL: Distilling Executable Agent Skills from Human-Created Multimodal Resources
소프트웨어 에이전트가 작업을 수행하려면 ‘스킬’이 필요하지만, 기존 스킬 라이브러리는 튜토리얼 영상 같은 멀티모달 자료를 제대로 활용하지 못했습니다. ‘RESOURCE2SKILL’은 튜토리얼 영상, 코드 저장소, 기술 문서 등 인간이 만든 다양한 멀티모달 자료로부터 에이전트가 직접 실행할 수 있는 스킬을 자동으로 추출하는 프레임워크입니다.

RAGU: A Multi-Step GraphRAG Engine with a Compact Domain-Adapted LLM
GraphRAG는 구조화된 지식을 활용해 LLM의 성능을 높이지만, 기존 시스템은 단일 단계로 지식 그래프를 구축하여 정보의 노이즈가 많았습니다. ‘RAGU’는 정보 추출과 통합 단계를 분리하고 여러 단계의 정제 과정을 거쳐, 더 깨끗하고 신뢰도 높은 지식 그래프를 생성함으로써 LLM의 검색 및 답변 품질을 향상시키는 새로운 GraphRAG 엔진입니다.

EvolvingWorld: An Open-Schema Framework for Co-Evolving Role-Play Agents and World Model in Interactive Literary World
기존의 상호작용형 문학 세계 시뮬레이션은 캐릭터와 세계가 함께 진화하지 못하고 정적인 상태에 머물러 있었습니다. ‘EvolvingWorld’는 캐릭터 간의 상호작용과 사건의 진행에 따라 캐릭터와 세계의 상태가 지속적으로 업데이트되며 함께 진화하는 프레임워크로, 시간이 흐름에 따라 역동적으로 변화하는 장기적인 서사 시뮬레이션을 구현합니다.
DeepSearch-World: Self-Distillation for Deep Search Agents in a Verifiable Environment
도구를 사용하는 에이전트가 스스로의 경험을 통해 학습하도록 훈련시키는 것은 어려운 과제였습니다. 이 논문은 재현 가능한 검색 환경인 ‘DeepSearch-World’와, 에이전트가 자신의 성공적인 탐색 경험을 바탕으로 스스로를 개선하는 자기 증류(self-distillation) 프레임워크 ‘DeepSearch-Evolve’를 제시합니다.
Hugging Face Blog
SWE-Pruner Pro: The Coder LLM Already Knows What to Prune
SWE-Pruner Pro는 코딩 LLM이 컨텍스트를 이해할 때 이미 코드의 관련성을 내부적으로 파악한다는 점에 착안한 기술입니다. 이 방식은 별도의 분류기 없이 에이전트의 자체적인 판단을 활용하여 불필요한 코드를 직접 제거함으로써, 더욱 효율적인 컨텍스트 관리를 가능하게 합니다.
HOMIE: Human-object Centric Video Personalization via Multimodal Intelligent Enchancement
HOMIE는 사람과 객체가 중심이 되는 비디오 개인화(HOCVP) 기술로, 기존 모델들이 겪는 어려움을 해결하고자 합니다. 특히 생성된 영상 속 인물의 정체성을 충실히 유지하면서도, 로고와 같은 추상적인 객체와의 상호작용까지 정확하게 표현하는 데 중점을 둡니다.
FlowMimic: Mask-free Visual Editing and Generation with Pixel-pair Warped Flow Field for Online Video Editing Data Generation and Modality Mimicry
FlowMimic은 단일 모델 안에서 이미지와 비디오의 생성 및 편집 기능을 모두 통합하는 새로운 접근 방식을 제시합니다. 이 기술은 기존의 노동 집약적이고 오류 발생 가능성이 높았던 비디오 편집 데이터 수집 과정을 ‘마스크 없는(mask-free)’ 방식으로 자동화하여 효율을 높입니다.
GitHub Trending
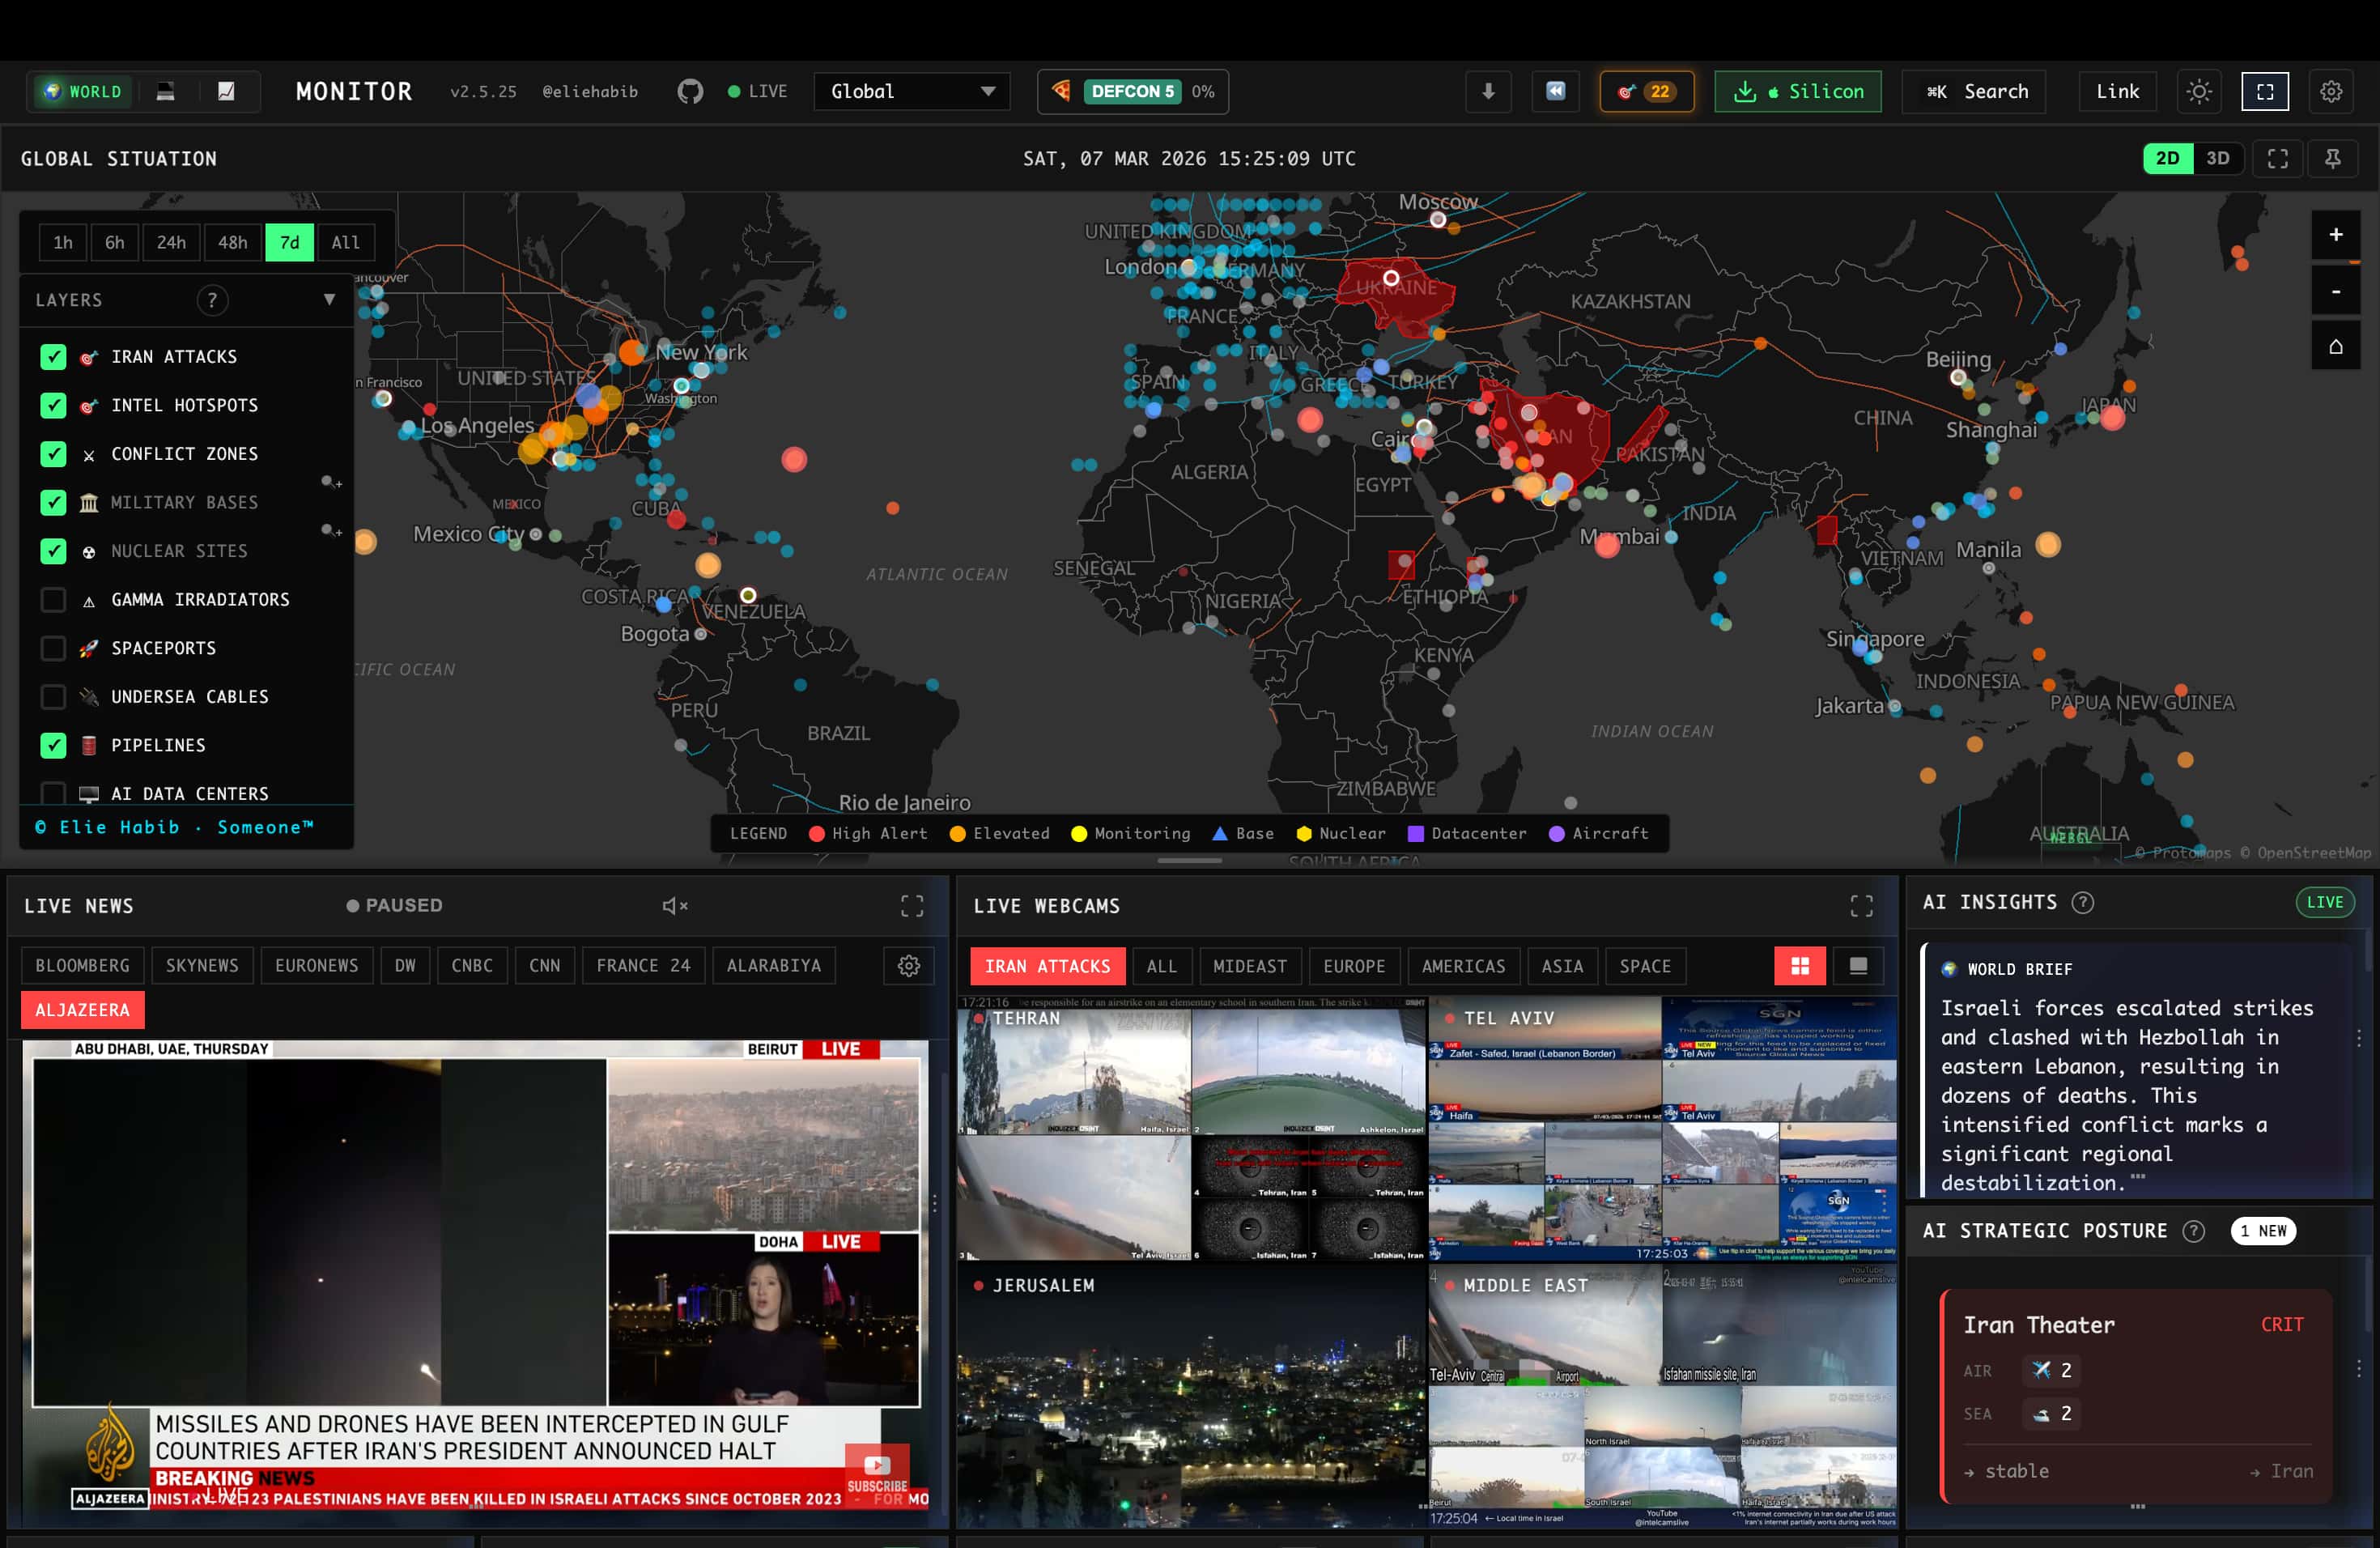
koala73/worldmonitor
worldmonitor는 실시간 글로벌 인텔리전스 대시보드입니다. AI 기술을 활용하여 전 세계의 뉴스, 지정학적 동향, 인프라 정보를 통합적으로 수집하고 추적하여 단일 인터페이스에서 상황을 종합적으로 파악할 수 있도록 돕습니다.
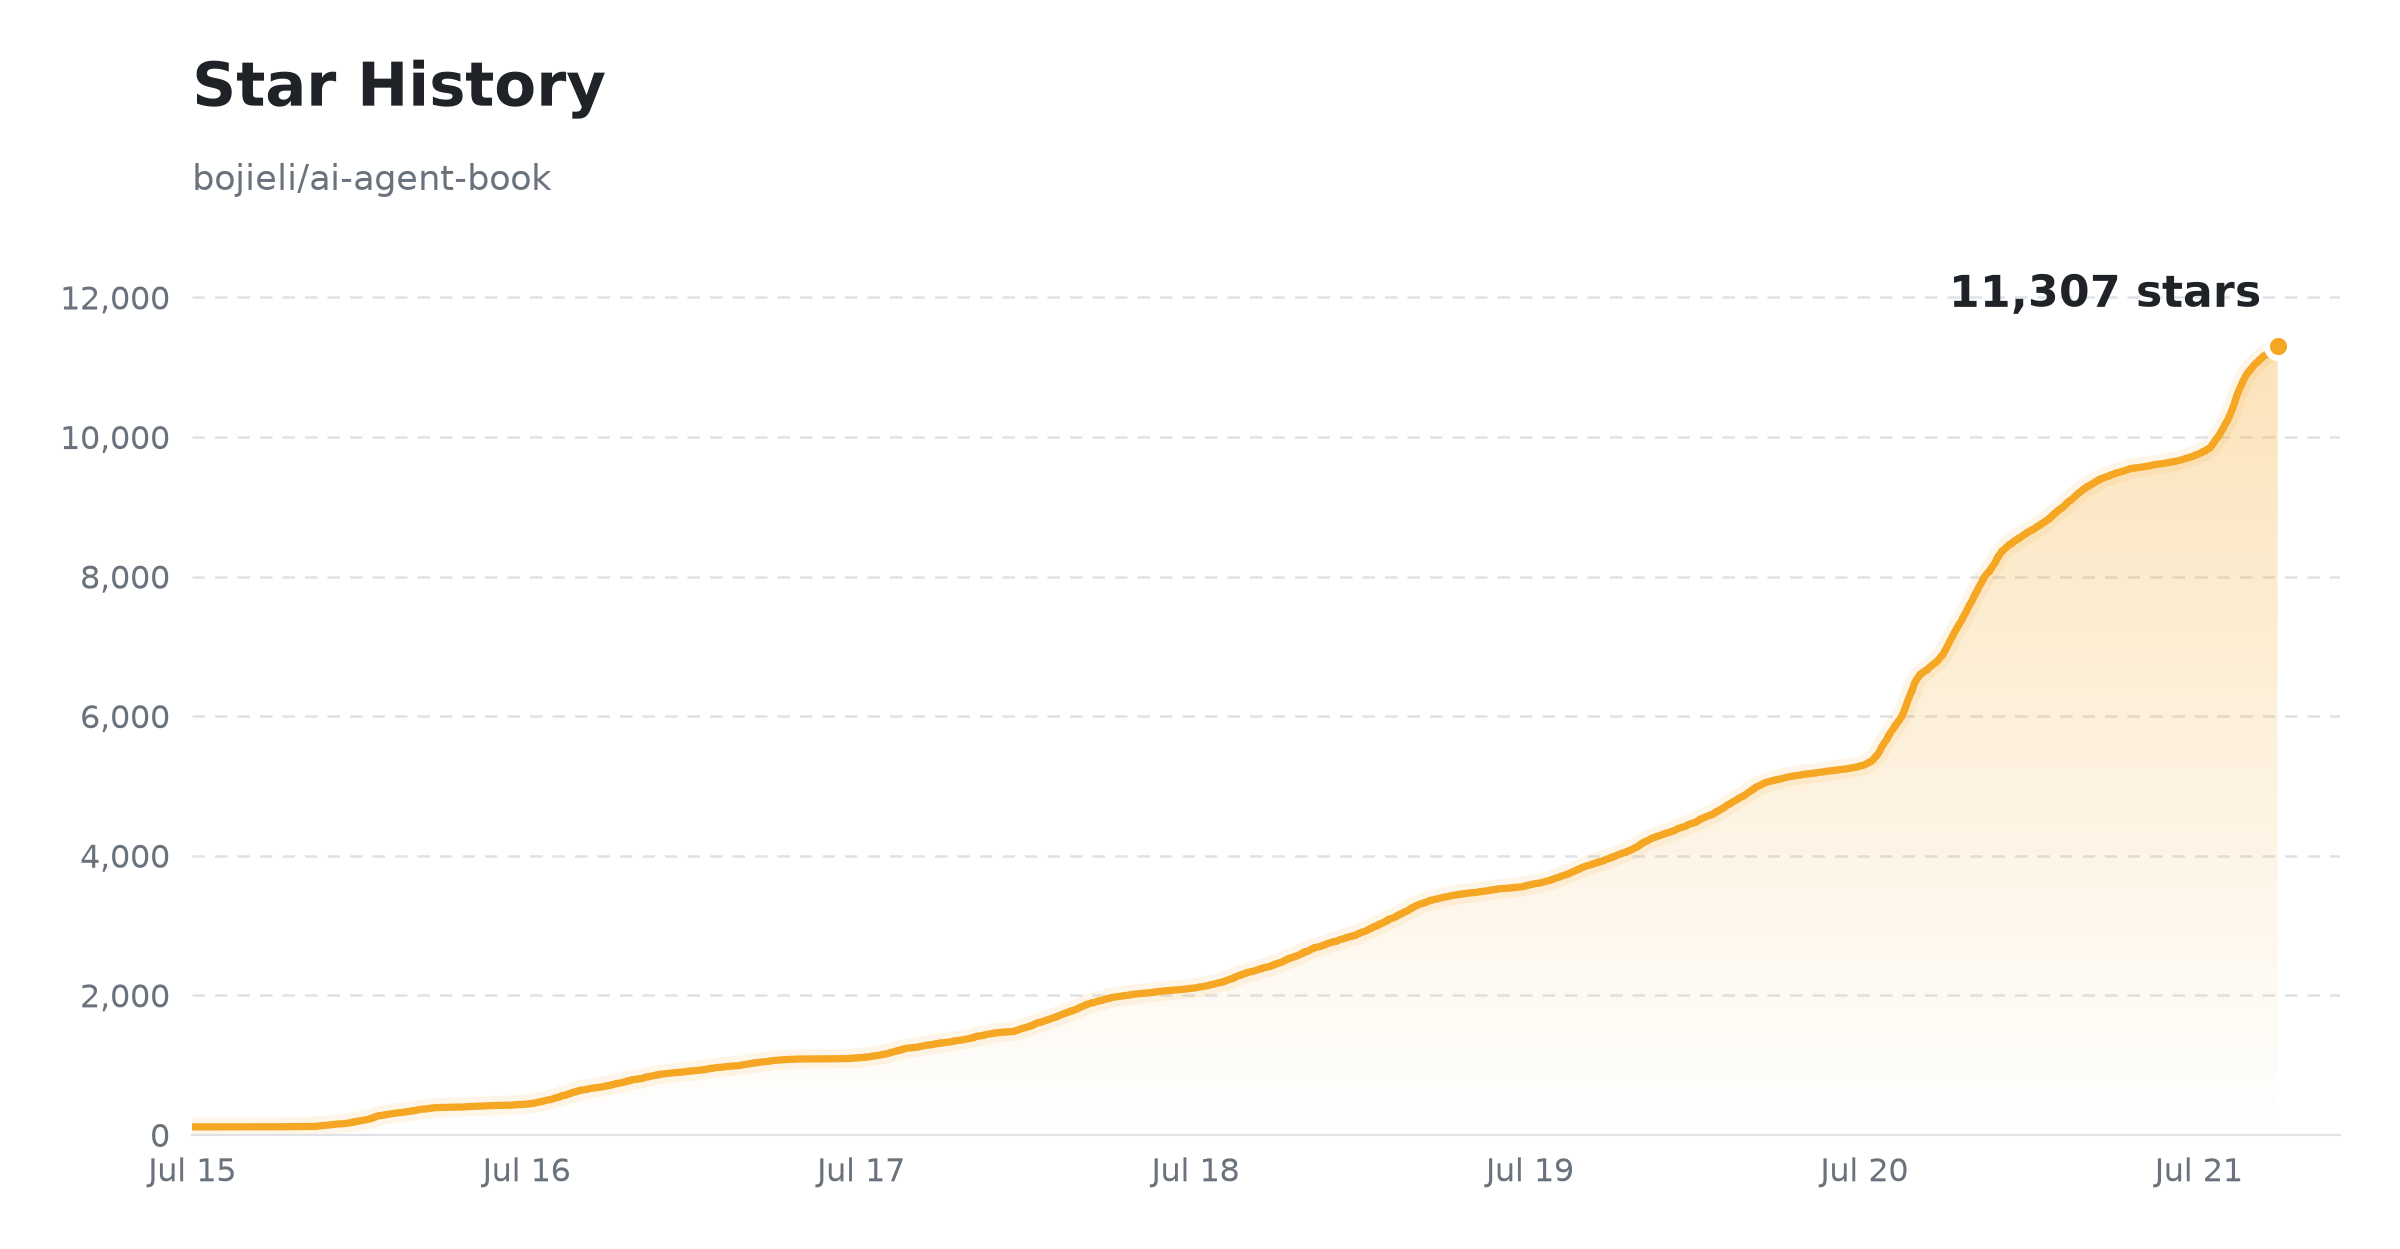
bojieli/ai-agent-book
‘AI 에이전트 심층 이해: 설계 원리 및 엔지니어링 실천’이라는 중국어 서적의 공식 오픈소스 저장소입니다. 책의 전체 본문과 컴파일된 PDF 파일은 물론, 각 장에 해당하는 예제 코드를 모두 제공하여 AI 에이전트 개발을 심도 있게 학습할 수 있습니다.
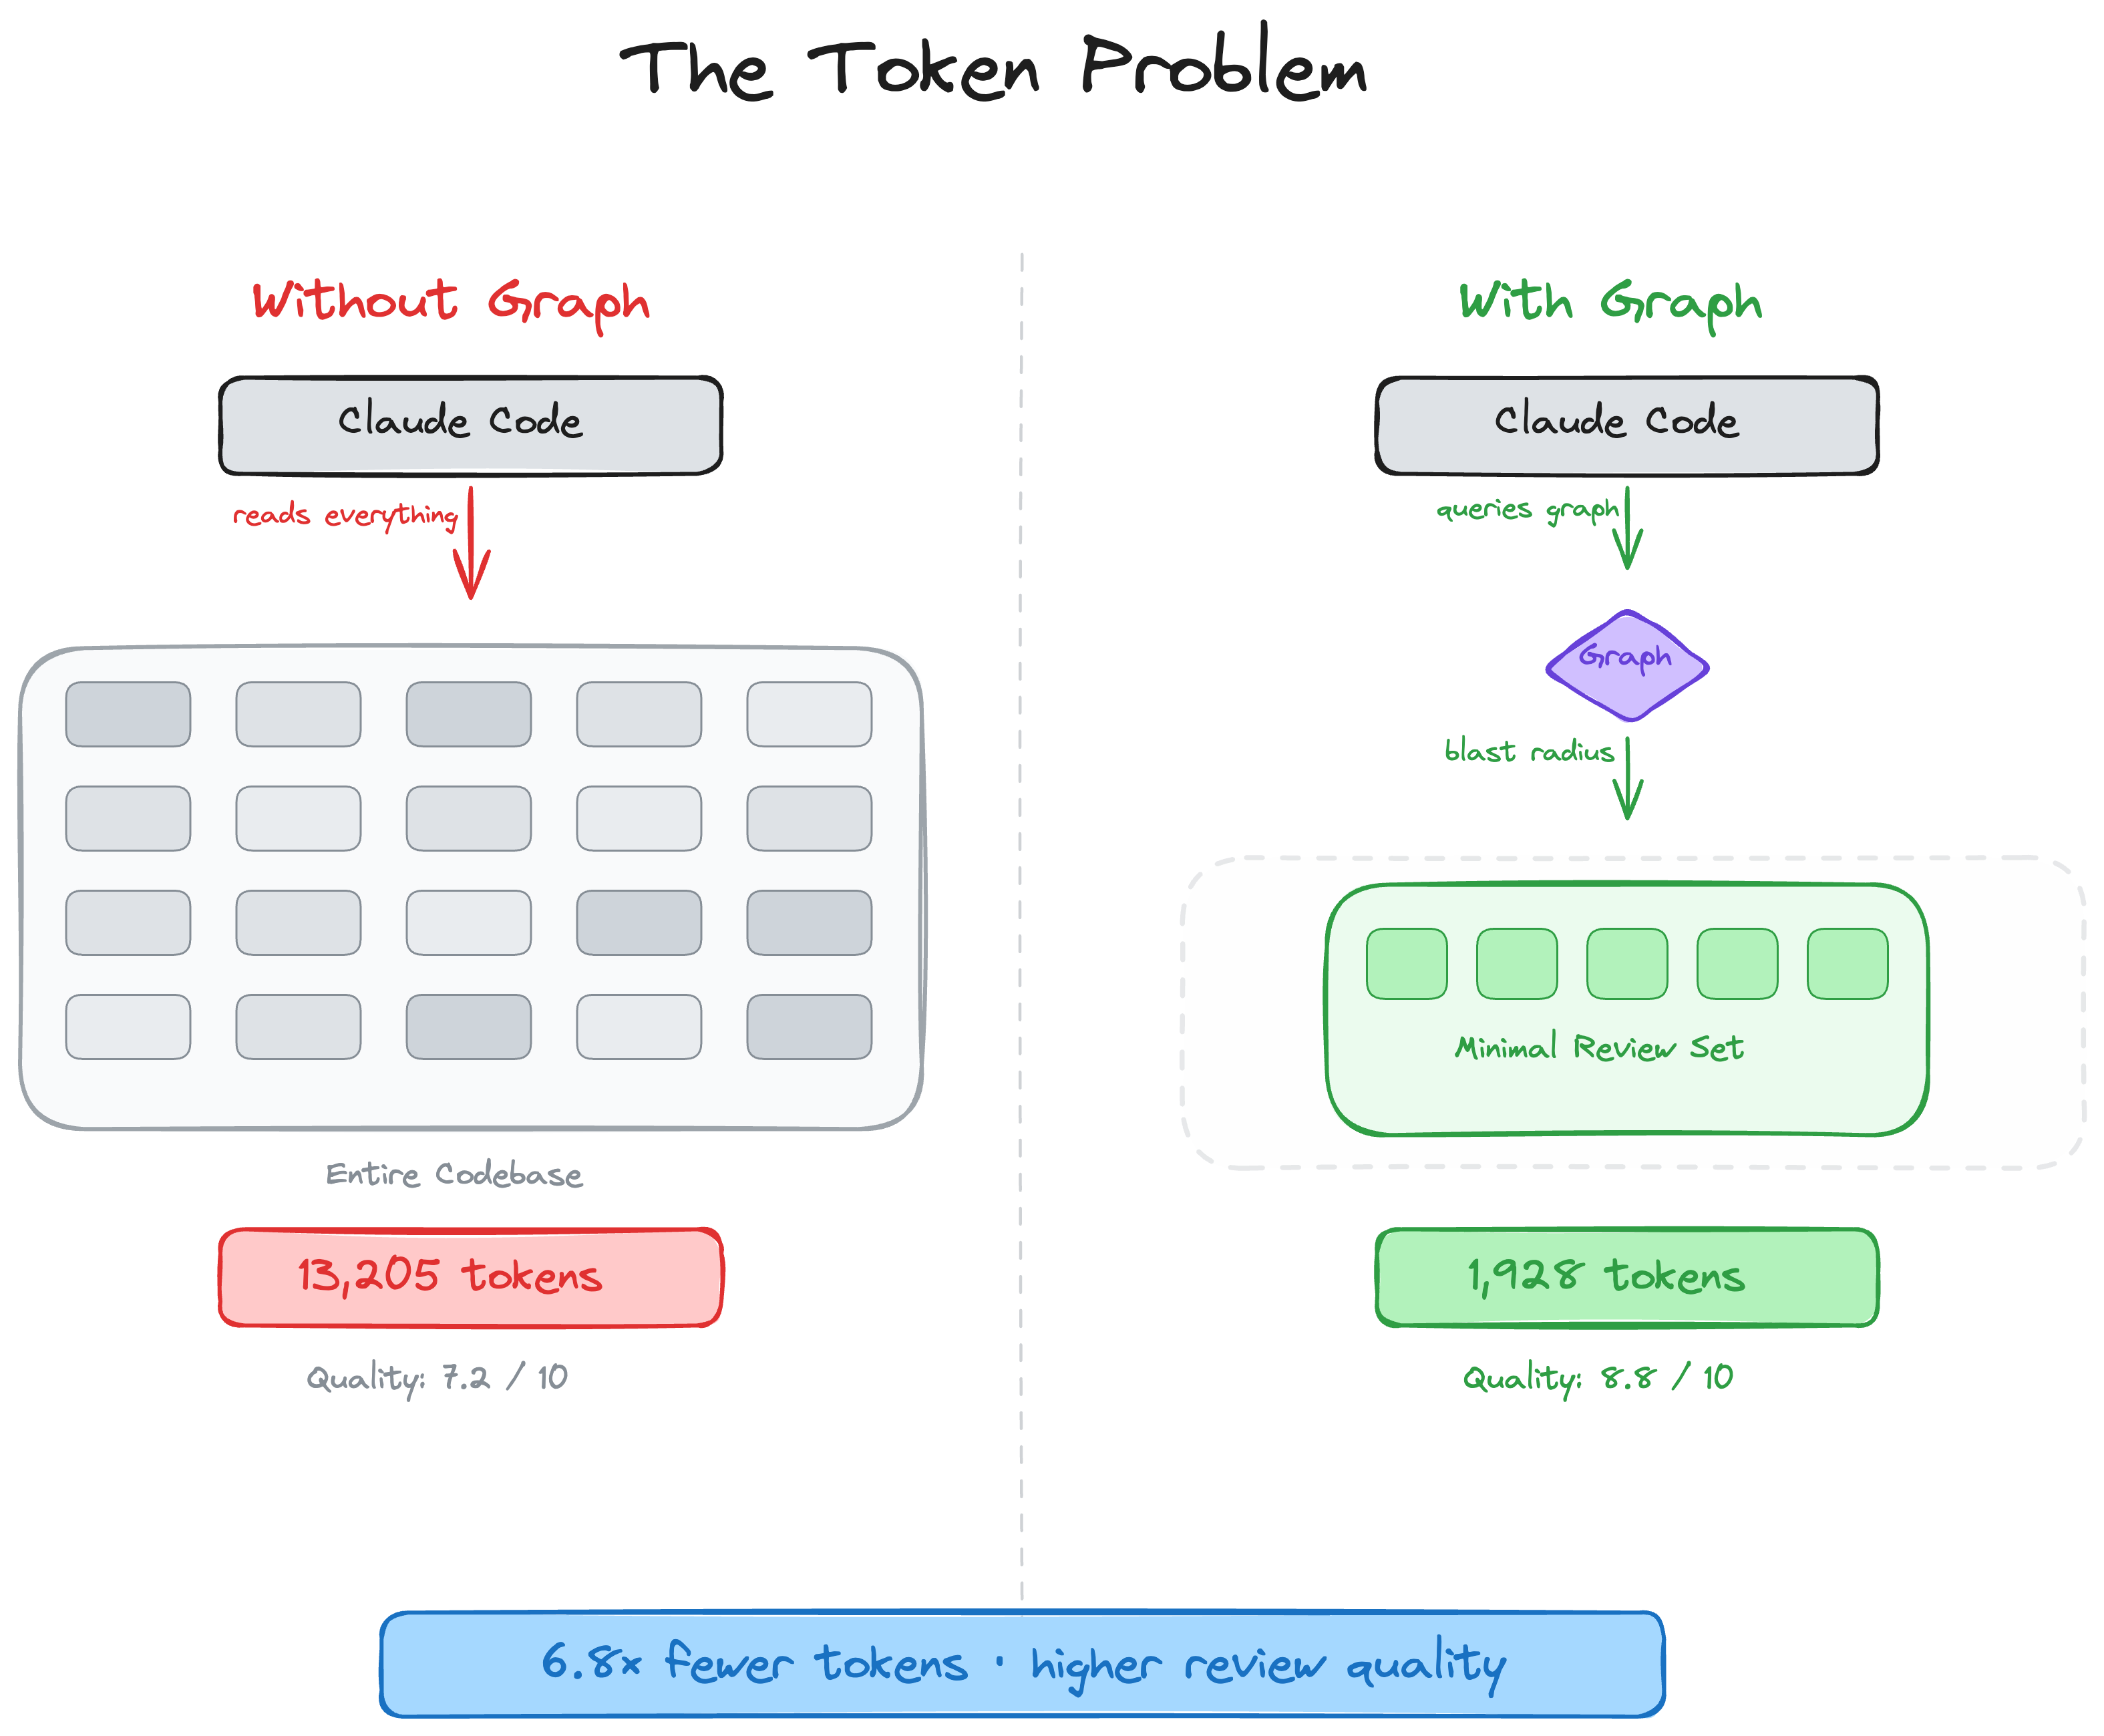
tirth8205/code-review-graph
code-review-graph는 로컬 우선 방식으로 동작하는 코드 인텔리전스 그래프 도구입니다. 코드베이스의 영구적인 지도를 구축하여 AI 코딩 도구가 코드 리뷰나 대규모 저장소 워크플로우에서 핵심적인 부분만 읽도록 함으로써 컨텍스트를 크게 줄여줍니다.
AstrBotDevs/AstrBot
AstrBot은 다양한 인스턴트 메시징(IM) 플랫폼, LLM, 플러그인을 통합한 AI 에이전트 비서이자 개발 프레임워크입니다. 사용자는 이를 통해 자신만의 AI 기능을 손쉽게 구축할 수 있으며, ‘openclaw’의 대안으로도 활용될 수 있습니다.
tradesdontlie/tradingview-mcp
트레이딩뷰(TradingView) 차트 분석을 AI로 보조하는 프로젝트입니다. 클로드(Claude)의 코드 생성 능력을 트레이딩뷰 데스크톱 앱에 연결하여 개인화된 분석 워크플로우를 자동화할 수 있습니다.
오늘의 키워드
LLM Grounding Multimodal Agent RAG Eval Benchmark Vision Fine-tuning Long Context