semantica — 컨텍스트와 책임성 AI를 위한 그래프 네이티브 인프라
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

Interpretable MEG Decoding of Perceived Speech: Cortical Sources and the Stimulus Features That Drive Retrieval
뇌자도(MEG) 기록에서 사람이 인지한 음성을 해독하는 새로운 딥러닝 아키텍처를 제안합니다. 이 모델은 기존 방식보다 해석 가능성이 높아, 음성 해독 과정에 어떤 대뇌 피질 영역과 음성 특징이 중요하게 작용하는지 명확히 밝혀냈습니다.

From Economic Agents to Agentic Economies: A Systems Blueprint for Economic World Models
이 논문은 개별 경제 주체들의 상호작용이 거시 경제 결과를 만들어내는 과정을 시뮬레이션하는 ‘경제 세계 모델(EWMs)’ 구축을 위한 청사진을 제시합니다. 이 생성형 모델은 다양한 주체, 시장, 제도가 함께 진화하는 복잡한 경제 시스템을 모델링하여 경제의 동적인 변화를 예측하고 분석하는 것을 목표로 합니다.

SFT Conflicts, RL Coexists: A Theoretical and Empirical Analysis of Multi-Task Learning for LLMs
대규모 언어 모델(LLM)을 여러 작업에 대해 학습시킬 때, 지도 미세조정(SFT)은 심각한 작업 간 충돌을 일으키는 반면 강화학습(RL)은 안정적인 공존을 가능하게 한다는 현상을 발견했습니다. 연구진은 RL이 각 작업에 대해 희소하고 직교에 가까운 파라미터 업데이트를 유도하기 때문에 이러한 차이가 발생한다는 이론적, 경험적 분석 결과를 제시합니다.

DataSpace: Benchmarking Data Agents for Verifiable Analytics over Heterogeneous Workspaces
데이터베이스, 파일, 문서 등 이기종 작업 공간에 흩어진 데이터를 자연어로 분석하는 ‘데이터 에이전트’의 성능을 종합적으로 평가하기 위한 새로운 벤치마크 ‘DataSpace’를 소개합니다. 기존 벤치마크와 달리 DataSpace는 다양한 데이터 소스에서 정보를 탐색하고, 검증 가능한 표 형식의 결과를 생성하는 능력을 결정론적으로 평가하는 데 중점을 둡니다.
Teaching Nemotron Greek: Mining a Corpus, Adapting Retrieval, and Grounding Generation for Modern Greek across Specialist Domains
이 연구는 법률, 의료 등 전문 분야의 RAG 시스템에 중요하지만 기존에 지원되지 않던 현대 그리스어를 NVIDIA의 Nemotron 검색 모델에 적용하는 전 과정을 다룹니다. 연구팀은 그리스어 말뭉치 수집부터 검색 모델 훈련, 새로운 벤치마크 HERA 개발까지 수행하여 특정 언어에 대한 검색 스택을 성공적으로 적용할 수 있음을 보여주었습니다.
Hugging Face Blog
SimWAM: A Simple World Action Model for End-to-End Autonomous Driving
기존 자율주행 월드-액션 모델(WAM)은 추론 시 비디오를 생성해야 해 비용이 많이 들었지만, SimWAM은 비디오 생성을 훈련에만 활용하여 효율성을 높였습니다. 추론 시에는 가벼운 액션 예측 모델만 사용함으로써, 비디오 동역학 지식을 행동 예측에 효과적으로 전달하면서도 실시간 주행 환경에 적용하기 용이해졌습니다.
Addressable Memory for Video World Models
비디오 월드 모델은 과거 프레임을 기억하기 위해 메모리를 사용하지만, 훈련 데이터보다 긴 영상을 생성할 때 위치 임베딩(RoPE)의 한계로 필요한 시각 정보를 제대로 찾지 못하는 문제가 발생합니다. 이 연구는 훈련 범위를 넘어서는 긴 시퀀스에서도 모델이 과거 정보를 안정적으로 참조하고 활용할 수 있는 새로운 ‘주소 지정 가능 메모리’ 구조를 제안하여 이 문제를 해결합니다.
SemBridge: Semantic Token Anchoring for Continuous-Latent Autoregressive Speech Generation
연속 잠재 공간 기반의 음성 생성 모델은 풍부한 음향 정보를 보존하지만, 명시적인 언어 단위가 없어 내용 정확도가 저하될 수 있습니다. SemBridge는 의미론적 토큰을 연속적인 음향 신호에 연결하는 ‘앵커링’ 기법을 도입하여, 언어 모델이 언어 구조를 더 명확하게 학습하고 생성된 음성의 내용 충실도를 높이도록 돕습니다.
토스 기술블로그
모노리포 희망편, 절망의 리포가 희망의 리포로 부활하기까지 걸린 1년
토스에서는 100명 이상의 엔지니어들이 사용하는 모노리포가 점차 관리하기 어려워지는 문제를 겪었습니다. 이 문제를 해결하기 위해 ‘카탈로그’라는 시스템을 도입하여, 모노리포의 장점만 효율적으로 활용할 수 있게 된 1년간의 경험을 공유합니다.
GitHub Trending
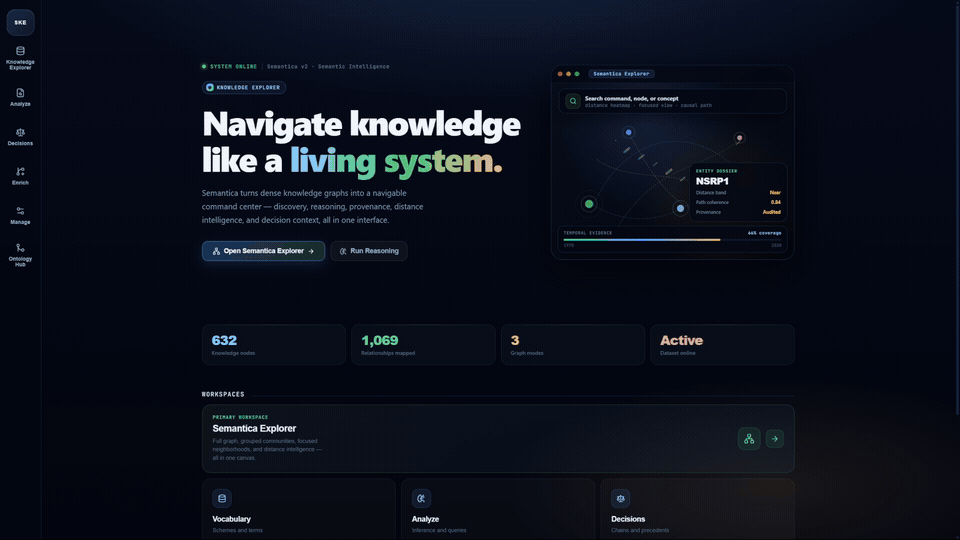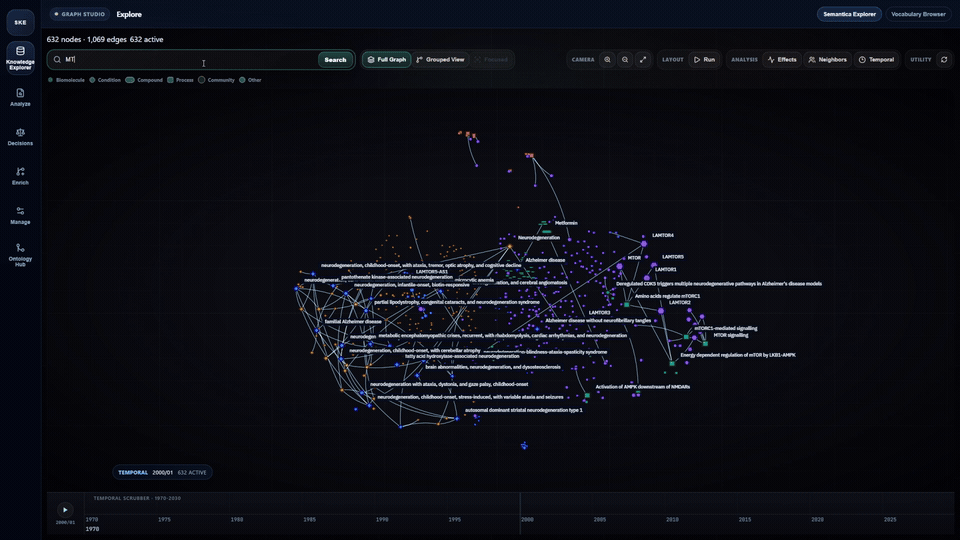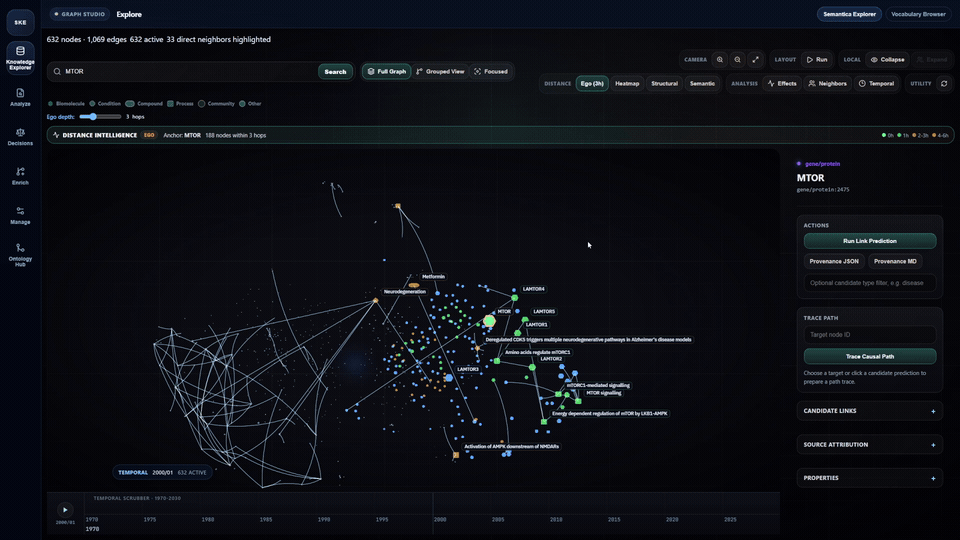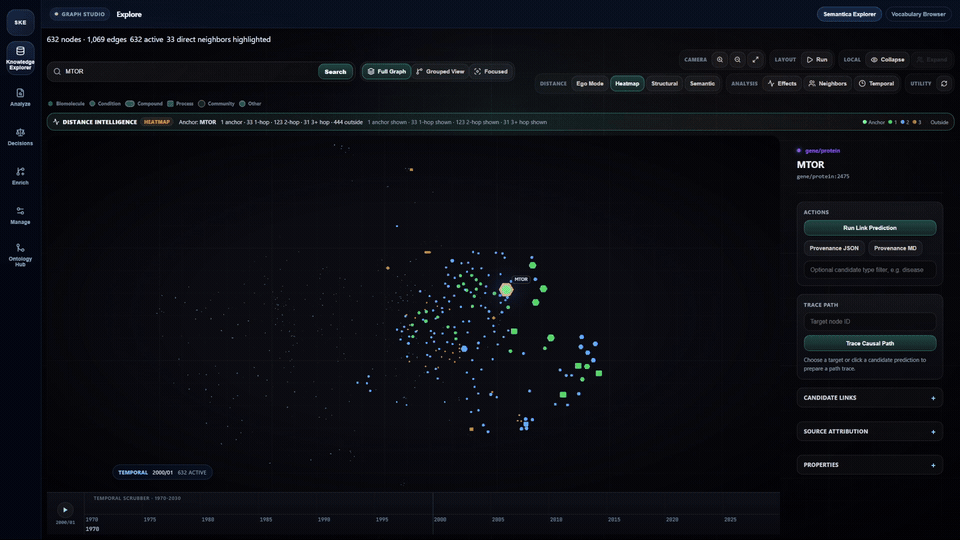
semantica-agi/semantica
semantica는 컨텍스트와 책임감 있는 AI 시스템을 위한 그래프 네이티브 인프라스트럭처입니다. 이 프로젝트는 그래프 구조를 활용하여 AI가 내리는 결정의 근거를 명확히 하고, 시스템의 투명성을 높이는 것을 목표로 합니다.
msitarzewski/agency-agents
agency-agents는 프론트엔드 개발부터 커뮤니티 관리까지 다양한 역할을 수행하는 AI 에이전트 모음입니다. 각 에이전트는 고유한 개성과 전문성을 갖추고 있어, 마치 하나의 완전한 AI 에이전시처럼 협업하며 결과물을 만들어냅니다.
addyosmani/agent-skills
agent-skills는 AI 코딩 에이전트에게 실제 상용 수준의 엔지니어링 기술을 부여하기 위한 프로젝트입니다. 단순한 코드 생성을 넘어, 실제 개발 현장에서 요구되는 고품질의 소프트웨어 개발 능력을 AI 에이전트가 갖추도록 돕습니다.
paperclipai/paperclip
paperclip은 업무 환경에서 여러 AI 에이전트를 효율적으로 관리하고 활용하기 위한 오픈소스 애플리케이션입니다. 사용자는 이 도구를 통해 다양한 에이전트의 작업을 조율하고, 복잡한 업무를 자동화할 수 있습니다.
PrimeIntellect-ai/prime-agent
prime-agent는 코딩 워크플로우나 장시간 자율 작업을 수행하며 스스로 성능을 개선하는 RLM 기반 에이전트입니다. 지속적인 학습을 통해 복잡하고 긴 작업을 사람의 개입 없이 안정적으로 처리하는 것을 목표로 합니다.
오늘의 키워드
Audio Retrieval Eval Agent LLM Fine-tuning Vision Grounding RAG Inference