MoneyPrinterTurbo, 키워드 하나로 HD 단편 비디오 자동 생성
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

Can We Defend Against AI-Generated Video Attacks on Real-World Crisis Events? A Systematic Evaluation of Detectors, Generators and Social Dissemination
AI가 생성한 전쟁이나 재난 영상은 심각한 허위 정보 위험을 야기하며, 기존 탐지 기술은 실제 위기 상황에서 한계를 보입니다. 이 연구는 새로운 벤치마크 ‘RA-Bench’를 도입하여, AI 영상 생성기와 탐지기의 성능을 체계적으로 평가하고 소셜 미디어 전파 과정에서 탐지 신뢰도가 어떻게 변하는지 분석합니다.

Self-Supervised Visual On-Policy Distillation
기존의 시각적 정책 증류(visual on-policy distillation)는 더 우월한 정보를 가진 ‘교사’ 모델에 크게 의존해왔습니다. 이 연구는 교사에게 정보를 더하는 대신 ‘학생’ 모델의 정보를 일부 제거하여 학습에 필요한 비대칭성을 만드는 역발상적 접근법을 제안하며, 이를 통해 별도의 특권 정보 없이도 효율적인 자기 지도 학습을 가능하게 합니다.

Beyond Final Scores: A Systematic Evaluation of Agents for Long-Horizon AI Research and Development
자율 에이전트가 장기적인 연구 개발 과제를 수행하는 능력이 향상되고 있지만, 최종 점수만으로는 그 성능을 제대로 평가하기 어렵습니다. 이 논문은 에이전트의 성공 및 실패 원인과 경험에 따른 학습 효과를 파악하기 위해, 36개의 장기 과제에 대한 7개 최신 모델의 수행 과정을 체계적으로 분석하는 새로운 평가 프레임워크를 제시합니다.

Intern-S2-Mobius: Foundation Model with Decoupled Knowledge and Reasoning
이 연구는 지식과 추론 기능을 분리한 새로운 파운데이션 모델 아키텍처 ‘Mobius’를 제안합니다. Mobius는 지식을 저장하는 공유 메모리(FFN)와 이 메모리에서 필요한 정보를 반복적으로 호출하여 추론을 수행하는 여러 추론기(Self-Attn)로 구성되어, 더 나은 지식 압축과 추론 효율성을 달성합니다.
Apodex Discovery: Reality Benchmarks and Environments for Evaluating and Building Discoverative Artificial Intelligence
현재 AI는 명확히 정의된 문제는 잘 해결하지만, 현실 세계의 모호하고 복잡한 과제를 다루는 데는 한계가 있습니다. 이 연구는 아폴로 프로젝트처럼 막연한 목표를 구체적인 과제로 전환하는 ‘발견적 AI’를 평가하고 구축하기 위한 새로운 벤치마크 및 환경인 ‘Apodex Discovery’를 소개합니다.
Hugging Face Blog
Marionette: Predicting World States, Rendering Geometry, Painting Appearance
기존 게임 월드 모델은 시각적 정보를 한 번에 처리하여 장기 예측 시 오류가 누적되는 한계가 있었습니다. ‘마리오네트’는 월드 상태 예측, 기하학적 렌더링, 외형 생성을 명확히 분리함으로써 더 길고 일관성 있는 시퀀스를 안정적으로 생성하고 제어 성능을 높입니다.
CPI-Bench: A Comprehensive,Practical and Intelligent Benchmark for Real-World Image Editing
이미지 편집 모델이 발전함에 따라 실제 환경에서의 성능 평가가 중요해졌지만, 기존 벤치마크는 단순한 작업에 머물러 한계가 있었습니다. ‘CPI-Bench’는 복잡하고 실용적인 시나리오를 제공하는 새로운 종합 벤치마크로, 다양한 모델의 성능을 현실적으로 비교하고 평가할 수 있게 해줍니다.
MathForm: Scaling Mathematical Autoformalization with Knowledge Retrieval and Verification-Guided Refinement
자연어 수학을 기계가 검증 가능한 언어로 변환하는 ‘자동 형식화’는 복잡한 라이브러리 이해가 필요하여 기존 모델에게 어려운 과제였습니다. ‘MathForm’은 지식 검색과 검증 기반의 정제 기술을 활용하여, 원본 명제의 의미를 보존하면서 더 정확하고 확장성 있는 형식화를 가능하게 합니다.
GitHub Trending
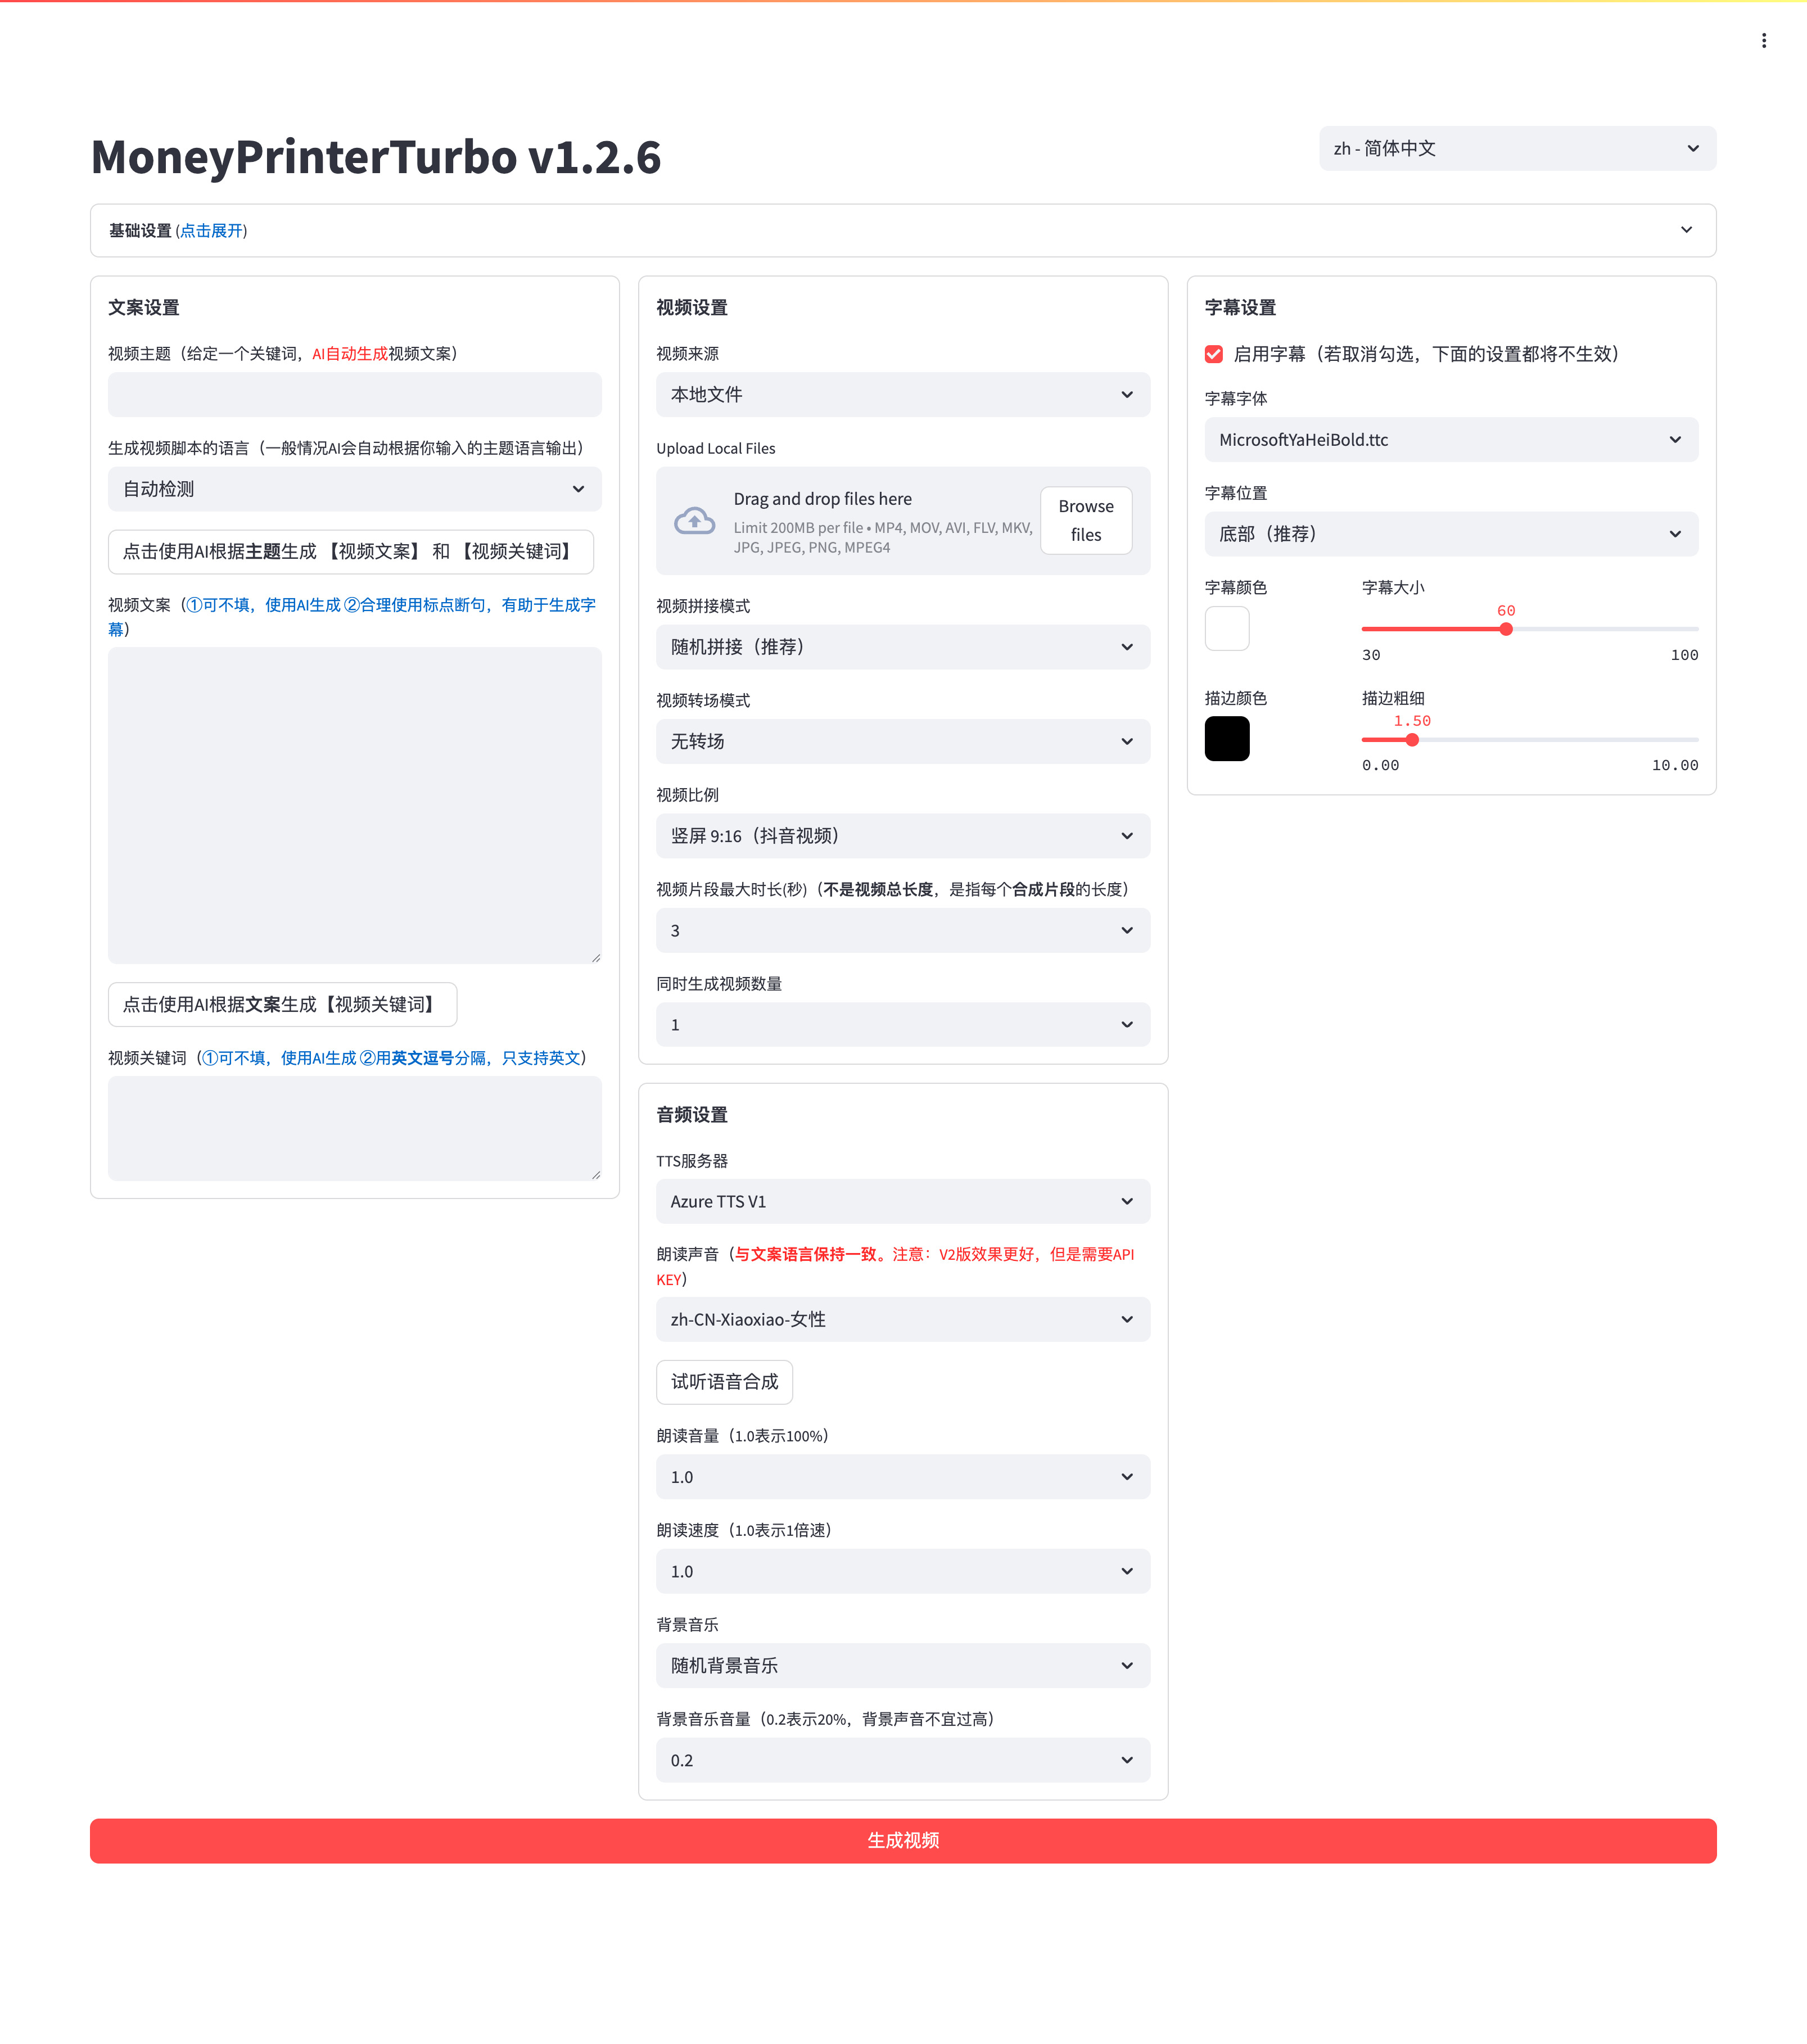
harry0703/MoneyPrinterTurbo
이 프로젝트는 AI 대규모 모델과 자동화된 워크플로우를 활용하여 고화질의 짧은 동영상을 제작합니다. 사용자는 주제나 키워드만 입력하면 클릭 한 번으로 손쉽게 동영상 콘텐츠를 생성할 수 있습니다.

usestrix/strix
Strix는 애플리케이션의 보안 취약점을 찾아내고 수정하는 것을 돕는 오픈소스 AI 침투 테스트 도구입니다. AI를 활용하여 자동으로 보안 문제를 분석하고 해결책을 제시함으로써 개발자들이 더 안전한 앱을 만들도록 지원합니다.
akitaonrails/ai-memory
이 프로젝트는 코딩 작업을 수행하는 AI 에이전트를 위한 장기 기억 솔루션을 제공합니다. 이를 통해 에이전트는 과거의 작업 내용을 기억하고, 서로 다른 공급업체의 에이전트 간에도 원활하게 작업 내용을 인계할 수 있습니다.
mukul975/Anthropic-Cybersecurity-Skills
AI 에이전트를 위해 817개의 사이버 보안 기술을 체계적으로 정리한 데이터셋입니다. MITRE ATT&CK, NIST 등 6개의 주요 보안 프레임워크와 연동되어 있으며, Claude, GitHub Copilot을 포함한 20개 이상의 플랫폼에서 활용 가능합니다.
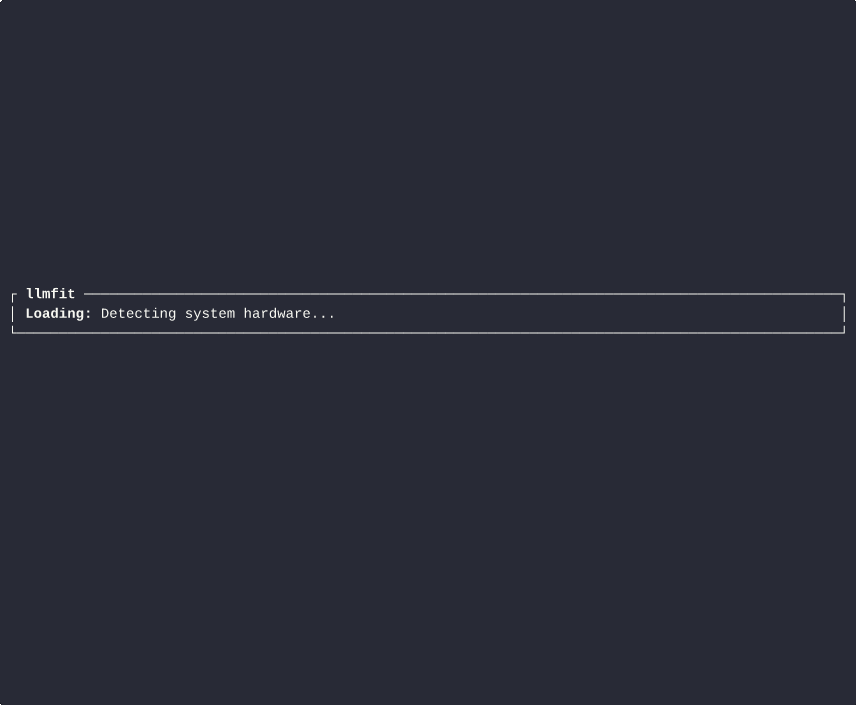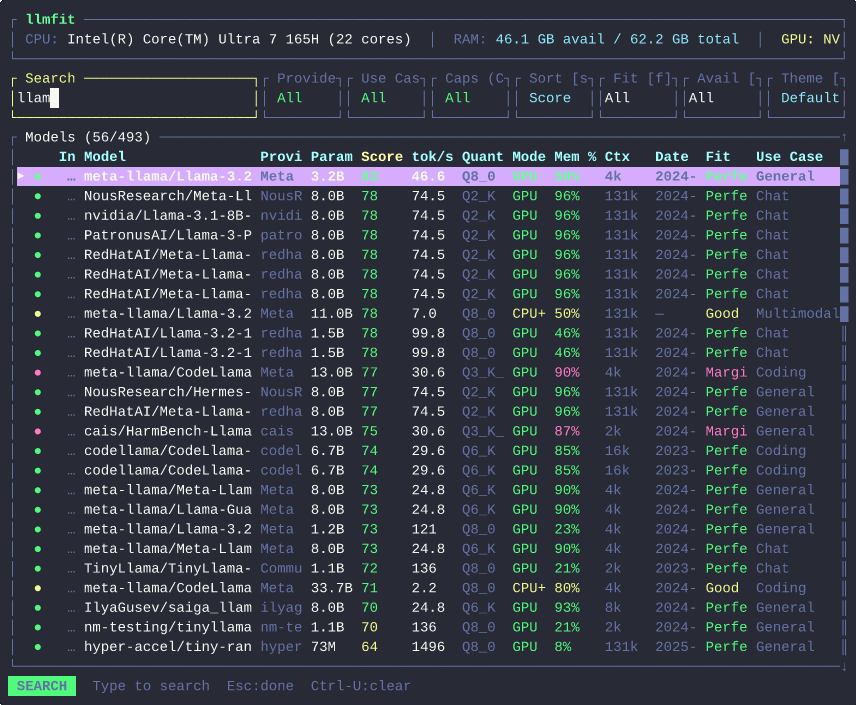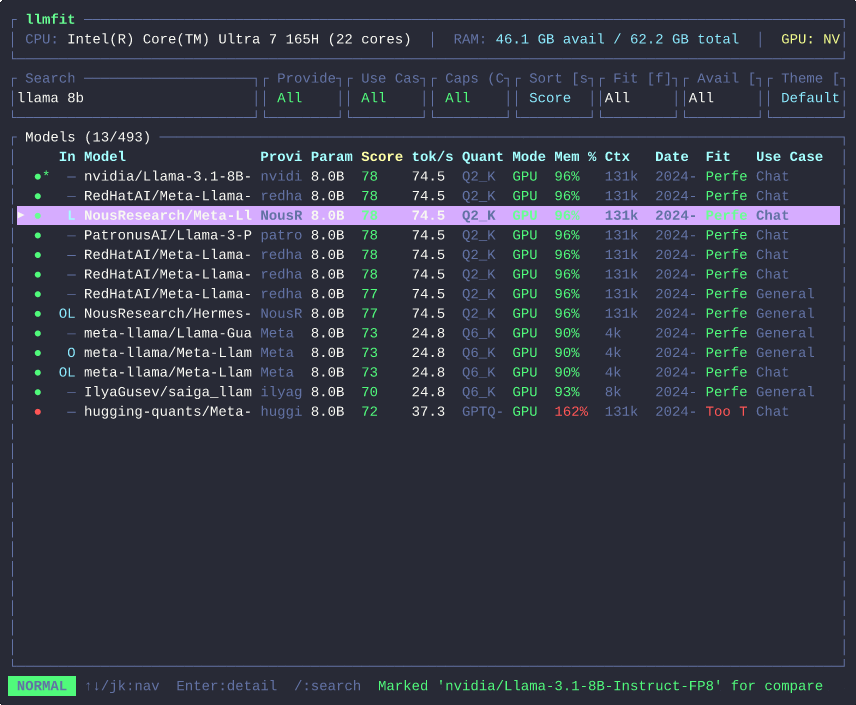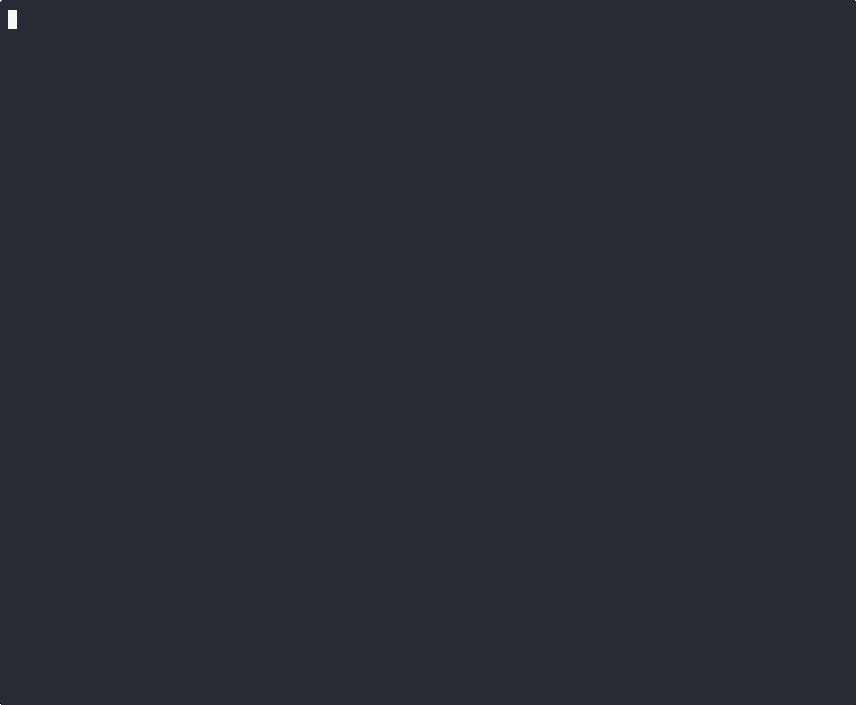
AlexsJones/llmfit
llmfit은 수백 개의 AI 모델과 제공업체 중에서 사용자의 하드웨어에서 실행 가능한 모델을 찾아주는 도구입니다. 단 하나의 명령어로 내 컴퓨터 사양에 맞는 최적의 모델을 쉽게 확인할 수 있습니다.
오늘의 키워드
Eval Vision Distillation Agent Reasoning RAG Retrieval Workflow Claude AI Agent