K-Dense-AI/scientific-agent-skills — AI Agent를 과학자로 만드는 스킬 라이브러리
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

VGI-Bench: Probing Visual Intelligence in Video Generation Models
최근 비디오 생성 모델이 보여주는 시각적 추론 능력을 신뢰성 있게 평가하기는 어렵습니다. VGI-Bench는 이러한 모델의 시각적 지능을 측정하기 위해 제안된 새로운 벤치마크로, 최종 결과의 그럴듯함을 넘어 과정의 타당성까지 평가하여 모델의 능력을 더 깊이 있게 분석합니다.

VoiceMem: Streaming Dual-Brain Memory for Real-Time Interaction
실시간 대화 시스템의 한계인 기억력 문제를 해결하기 위해 VoiceMem이라는 새로운 메모리 아키텍처가 제안되었습니다. 이 기술은 정보 처리를 담당하는 좌뇌와 감성적 맥락을 파악하는 우뇌처럼 이중 구조로 작동하여, 보다 정확하고 공감 능력 있는 장기적 대화를 가능하게 합니다.

WarpSAC: Towards the Pinnacle of Scalable Off-policy RL by Rethinking Exploration and Exploitation
대규모 병렬 시뮬레이션 환경에서 생성되는 방대한 데이터는 기존의 오프-정책(off-policy) 강화학습(RL) 알고리즘에 새로운 과제를 제기합니다. WarpSAC은 데이터가 풍부한 환경에 맞춰 탐험과 활용의 균형을 재정의함으로써, 기존 안정화 기법들의 한계를 극복하고 확장 가능한 강화학습의 새로운 방향을 제시합니다.

Agentic Game Development as a Verifiable Trajectory Data Engine for Scaling World Models
월드 모델(world model)을 확장하기 위해 단순히 비디오 데이터를 늘리는 것은 비효율적이라는 주장이 제기되었습니다. 이 논문은 에이전트를 활용한 게임 개발 과정을 검증 가능한 데이터 생성 엔진으로 사용하여, 월드 모델 학습에 필요한 명확한 보상 신호와 고품질 데이터를 제공하는 새로운 확장 전략을 제안합니다.

JIT-Agent: Scaling Harness Intelligence via Just-in-Time Harness Evolution
AI 에이전트의 성능은 기반 모델뿐만 아니라 메모리, 계획, 도구 사용을 포함하는 ‘하네스(harness)’에 크게 좌우됩니다. JIT-Agent는 특정 과제에 맞춰 최적의 하네스를 실시간으로 자동 생성하는 지능형 모델로, 수동적이고 비확장적이던 기존 하네스 설계의 한계를 극복합니다.
Hugging Face Blog
UrbanGround: From Local Perception to Spatial Agency in a Real-Scale City
멀티모달 대규모 언어 모델(MLLM)이 거리 풍경을 인식하는 능력을 넘어, 실제 도시 환경에서 얼마나 효과적으로 행동할 수 있는지 검증하는 연구입니다. 이를 위해 홍콩을 3D 지리공간 데이터로 복제한 ‘UrbanGround’라는 샌드박스를 제안하며, MLLM 에이전트가 지역적 인식을 신뢰성 있는 행동으로 전환하는 능력을 최초로 시험합니다.
TTPO: Test-Time Policy Optimization
대규모 언어 모델의 수학적 추론 능력을 향상시키기 위한 새로운 후속 학습 방법인 TTPO(Test-Time Policy Optimization)를 제안합니다. 기존 방식과 달리 정답 데이터 없이 테스트 시점에 바로 모델을 최적화할 수 있으며, 다수결 투표 방식의 취약점을 보완하여 더 안정적으로 성능을 개선합니다.
WikiSkill: Compiling Agent Experience into Persistent Knowledge for Skill Evolution
AI 에이전트가 상호작용을 통해 얻은 경험을 체계적으로 재사용하여 기술을 발전시키는 ‘WikiSkill’ 프레임워크를 소개합니다. 이 프레임워크는 에이전트의 경험에서 얻은 통찰력을 분산시키지 않고 지속적인 지식 베이스로 축적하여, 기술을 더욱 효율적으로 개선하고 진화시킬 수 있도록 돕습니다.
토스 기술블로그
1%가 겪은 버그 고쳐야할까요?
소프트웨어 개발 과정에서 소수의 사용자만 겪는 버그를 발견했을 때 어떻게 대응해야 할지 결정하는 것은 어려운 문제입니다. 특히 점진적 배포 중인 상황에서 핫픽스를 적용하는 것은 전체 릴리즈 일정을 지연시킬 수 있어, 사용자 경험과 개발 효율성 사이에서 신중한 판단이 요구됩니다. 이 글은 상충하는 가치 속에서 최적의 결정을 내리는 과정에 대한 깊이 있는 고민을 공유합니다.
GitHub Trending
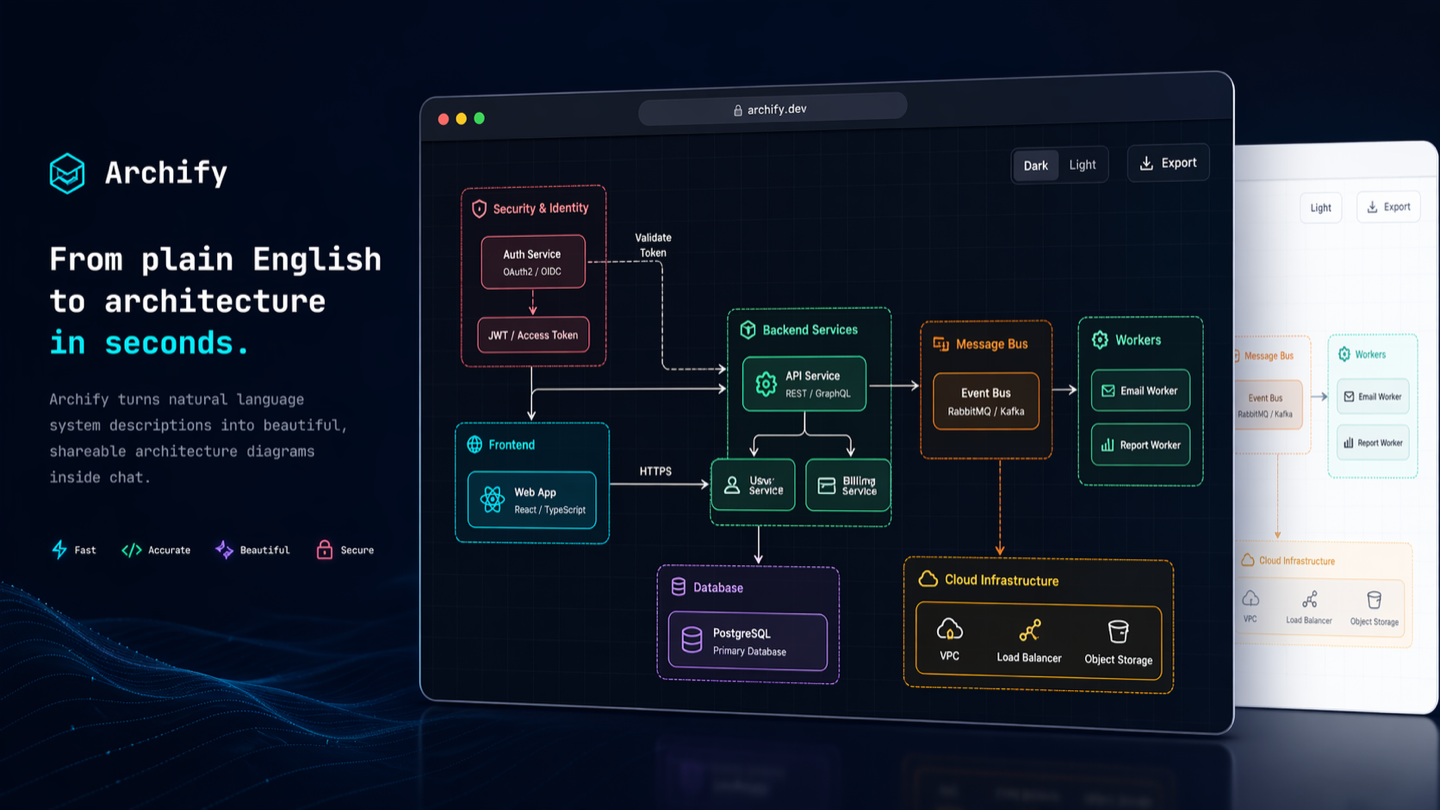
tt-a1i/archify
Archify는 아키텍처, 워크플로우, 시퀀스 다이어그램 등을 아름답고 검증 가능하게 만들어주는 AI 에이전트 스킬입니다. 이 도구를 사용하면 모션이 포함된 독립적인 HTML 파일을 생성할 수 있으며, 선명한 이미지로 내보내는 기능도 지원합니다.
K-Dense-AI/scientific-agent-skills
scientific-agent-skills는 모든 AI 에이전트를 과학자처럼 활용할 수 있게 해주는 최고의 에이전트 스킬 라이브러리입니다. 생물학, 화학, 의학 등 다양한 분야를 포괄하는 163개의 검증된 스킬과 100개 이상의 과학 데이터베이스를 제공하여 전 세계 17만 5천 명 이상의 과학자들이 사용하고 있습니다.
anthropics/claude-plugins-official
이 저장소는 Anthropic이 직접 관리하는 Claude Code용 고품질 플러그인의 공식 디렉토리입니다. 사용자들은 이곳에서 Anthropic이 검증한 신뢰도 높은 플러그인들을 찾아 Claude의 기능을 확장할 수 있습니다.
abhigyanpatwari/GitNexus
GitNexus는 별도의 서버 없이 브라우저에서 직접 실행되는 코드 인텔리전스 엔진입니다. Git 저장소나 ZIP 파일을 업로드하면 상호작용 가능한 지식 그래프를 생성해주며, 내장된 Graph RAG 에이전트를 통해 코드 구조를 효과적으로 탐색할 수 있습니다.
JetBrains/go-modern-guidelines
이 프로젝트는 AI 코딩 에이전트가 최신 스타일의 현대적인 Go 코드를 작성하도록 돕기 위한 가이드라인입니다. JetBrains가 제공하는 이 지침을 통해 AI가 생성하는 Go 코드의 품질과 일관성을 높일 수 있습니다.
오늘의 키워드
Reasoning Eval SLM LoRA RAG Benchmark LLM Agent Distillation AI Agent