OpenMAIC — 클릭 한 번으로 경험하는 멀티 에이전트 학습 교실
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

Agentic Game Development as a Verifiable Trajectory Data Engine for Scaling World Models
기존의 월드 모델 확장 방식은 단순히 더 많은 비디오 데이터를 학습시켜 비효율적이라는 문제가 있습니다. 이 연구는 코드 컴파일러가 명확한 보상 신호를 제공하듯, ‘에이전트 기반 게임 개발’을 통해 검증 가능한 궤적 데이터와 보상 신호를 생성하여 월드 모델을 효과적으로 확장하는 새로운 데이터 엔진을 제안합니다.

VGI-Bench: Probing Visual Intelligence in Video Generation Models
최근 비디오 생성 모델의 시각적 추론 능력을 신뢰성 있게 평가하기 어려운 문제를 해결하기 위해 새로운 벤치마크 VGI-Bench를 제안합니다. VGI-Bench는 27개의 태스크를 통해 모델이 단순히 그럴듯한 최종 결과물이 아닌, 논리적으로 타당한 과정의 영상을 생성하는지 심도 있게 평가하여 모델의 시각적 지능을 측정합니다.

VoiceMem: Streaming Dual-Brain Memory for Real-Time Interaction
실시간 대화형 AI 시스템에는 스트리밍 방식의 정확하고 공감 능력 있는 메모리 시스템이 필수적입니다. 이 연구는 정보 처리를 위한 좌뇌와 감성 처리를 위한 우뇌 구조를 모방한 VoiceMem 아키텍처를 제안하여, 실시간 상호작용을 지원하고 메모리를 인식하는 SLM 학습 및 배포 파이프라인을 구축합니다.

WarpSAC: Towards the Pinnacle of Scalable Off-policy RL by Rethinking Exploration and Exploitation
대규모 병렬 시뮬레이션 환경에서는 데이터가 풍부해져 기존의 오프-폴리시 강화학습(RL) 안정화 기법들이 오히려 성능을 저해할 수 있습니다. 이 연구는 데이터 처리량이 높은 환경에 맞춰 탐색과 활용의 균형을 재설계함으로써, 뛰어난 확장성을 보이는 새로운 알고리즘 WarpSAC을 제안합니다.

PAWBench: How Far Are We from Probabilistically Aligned World Modeling?
진정한 월드 모델이라면 하나의 그럴듯한 결과가 아닌, 발생 가능한 모든 결과의 분포를 재현하는 ‘확률적 정렬’이 중요합니다. 이 연구는 기존 평가 방식의 한계를 지적하며, 동일한 조건에서 반복 생성된 결과물이 실제 세계의 확률적 분포와 일치하는지 평가하는 새로운 벤치마크 PAWBench를 제안합니다.
Hugging Face Blog
UrbanGround: From Local Perception to Spatial Agency in a Real-Scale City
멀티모달 대규모 언어 모델(MLLM)이 거리 풍경을 이해하는 능력을 실제 도시 환경에서 검증하는 연구입니다. 이를 위해 홍콩의 3D 공간 데이터를 기반으로 구축된 ‘UrbanGround’라는 테스트 환경을 제안하여, 에이전트가 주변 환경 인식 능력을 복잡한 실제 도시에서의 행동으로 얼마나 잘 전환하는지 평가합니다.
TTPO: Test-Time Policy Optimization
대규모 언어 모델의 수학적 추론 능력을 향상시키는 기존 후속 학습 방법들은 정답 레이블이 필요하여 테스트 시점에는 적용하기 어렵습니다. 이 논문은 정답 없이 테스트 시점에 정책을 최적화하는 새로운 방법론인 ‘TTPO(Test-Time Policy Optimization)’를 제안하여, 다수결 투표 방식의 취약점을 보완하고 모델 성능을 안정적으로 향상시킵니다.
WikiSkill: Compiling Agent Experience into Persistent Knowledge for Skill Evolution
AI 에이전트가 상호작용을 통해 새로운 기술을 습득할 때 그 과정에서 얻은 지식이 체계적으로 재사용되지 못하고 흩어지는 문제가 있습니다. 이 연구는 에이전트의 경험을 지속적인 지식 베이스로 축적하고 발전시키는 ‘WikiSkill’ 프레임워크를 제안하여, 습득한 노하우를 체계적으로 재사용하고 기술을 점진적으로 발전시킬 수 있도록 돕습니다.
GitHub Trending
THU-MAIC/OpenMAIC
단 한 번의 클릭으로 몰입감 넘치는 다중 에이전트 학습 경험을 제공하는 오픈소스 가상 교실입니다. 여러 AI 에이전트가 상호작용하는 환경을 통해 새로운 방식의 학습을 체험할 수 있습니다.
K-Dense-AI/scientific-agent-skills
모든 AI 에이전트를 AI 과학자로 만들어주는 과학 분야 에이전트 스킬 라이브러리입니다. 생물학, 화학, 의학 등 100개 이상의 과학 데이터베이스와 연동된 165개의 검증된 스킬을 즉시 사용할 수 있어, 전 세계 19만 명 이상의 과학자들이 활용하고 있습니다.
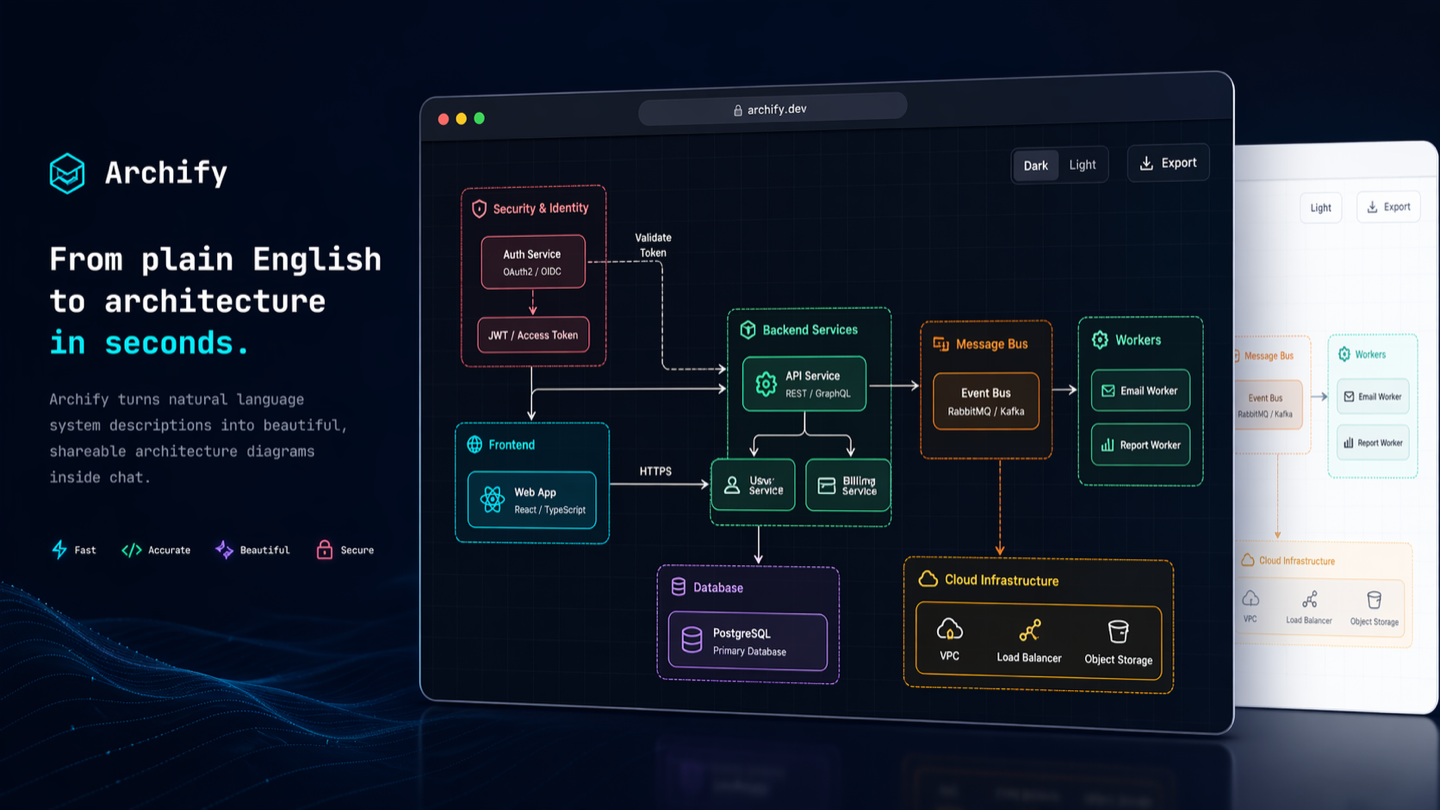
tt-a1i/archify
아름답고 검증 가능한 아키텍처, 워크플로우, 시퀀스 다이어그램 등을 생성하는 AI 에이전트 스킬입니다. 생성된 다이어그램은 애니메이션 효과가 포함된 단일 HTML 파일로 제공되며, 선명한 이미지로도 내보낼 수 있습니다.
p-e-w/heretic
언어 모델에 적용된 검열(censorship)을 완전 자동으로 제거하는 도구입니다. 이 프로젝트를 통해 모델의 응답 제한을 해제하여 더 자유로운 결과물을 얻을 수 있습니다.
unclecode/crawl4ai
LLM(거대 언어 모델)이 활용하기 좋은 형태로 데이터를 수집하는 오픈소스 웹 크롤러 및 스크레이퍼입니다. AI 모델 학습이나 RAG 시스템 구축에 필요한 웹 데이터를 효율적으로 수집할 수 있도록 설계되었습니다.
AI Weekly
AI Weekly Issue #527: Schools are choosing opposite futures for AI
교육계에서 AI 도입을 두고 서로 상반된 미래를 그리고 있습니다. 시카고 대학처럼 AI 활용 작문을 금지하며 전통적 교육을 고수하는 흐름이 있는가 하면, 알파 스쿨처럼 AI 기반 적응형 소프트웨어를 교육의 핵심으로 삼는 혁신적인 모델도 확산되고 있습니다.
오늘의 키워드
LLM Agent Reasoning Eval SLM LoRA RAG Benchmark Alignment Distillation