impeccable — AI 하네스의 디자인을 개선하는 디자인 언어
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

OneStreamer: Unifying Perception, Memory, and Proactive Response in Streaming Video Interaction
스트리밍 비디오 LLM을 위한 새로운 모델 ‘OneStreamer’를 소개합니다. 이 모델은 실시간 인식과 재사용 가능한 사실적 메모리 형성을 동시에 수행하며, 충분한 정보가 모이면 선제적으로 대응하는 능력을 갖추었습니다.
On-Policy or Off-Policy Learning? A Systematic Study of Distillation Dynamics
온-정책(On-policy) 학습과 오프-정책(Off-policy) 학습의 효과를 체계적으로 비교 분석한 연구입니다. 기존 연구들이 여러 요인을 동시에 변경해 비교가 어려웠던 점을 지적하며, 이 연구는 ‘롤아웃 정책’이라는 단일 변수만을 통제하여 지식 증류 과정에서의 동역학을 정밀하게 분석합니다.
Transformers Stop Thinking Too Early, and a Tiny LoRA Fixes It
사전 학습된 트랜스포머 모델이 문맥 속 정보를 처리할 때 깊은 레이어를 충분히 활용하지 않고 초반에 사고를 멈추는 경향이 있음을 발견했습니다. 이 문제를 해결하기 위해 단일 초기 레이어에 작은 LoRA를 적용하는 간단한 방법을 제안하며, 이를 통해 전체 모델 가중치를 고정한 상태에서도 긴 논리적 연결 고리를 정확하게 따라가는 성능 향상을 보였습니다.

E-MoE: Enhanced Mixture-of-Experts for Non-Factorized Diffusion Language Models
마스크 확산 모델(MDM)은 생성 속도가 빠르지만, 적은 스텝으로 생성할 때 토큰 간의 상관관계를 고려하지 못해 품질이 저하되는 문제가 있었습니다. 본 논문은 이를 해결하기 위해 ‘E-MoE’라는 새로운 전문가 혼합(Mixture-of-Experts) 구조를 제안하여, 토큰 위치 간의 상호 의존성을 효과적으로 포착하고 샘플 품질을 크게 향상시킵니다.
Make Sparse Rewards Count: Density-Aware Reward Aggregation for Multi-Reward RL
여러 개의 보상 목표를 동시에 학습하는 다중 보상 강화학습(RL)에서 특정 목표만 집중적으로 학습되고 희소한 보상은 무시되는 불균형 문제가 발생합니다. 이 연구는 ‘밀도 인식 보상 집계’라는 새로운 방법을 제안하여, 보상의 희소성을 고려해 학습 가중치를 동적으로 조절함으로써 모든 보상 목표가 균형 있게 학습 과정에 기여하도록 만듭니다.
Hugging Face Blog
ROWBench: Do Video Models Render What the Program Specifies?
프로그래밍 가능한 월드 모델은 차세대 게임 엔진의 기반으로 주목받지만, 프로그램의 규칙을 시각적으로 정확히 구현하는지에 대한 평가는 부족했습니다. 이를 해결하기 위해, 프로그램이 지정한 세밀한 월드 이벤트를 비디오 모델이 제대로 렌더링하는지 검증하는 새로운 벤치마크 PROWBench를 제안합니다.
ActiveSaddler: Automated Curriculum Learning for Agent Harness Optimization
기존의 LLM 에이전트 최적화는 주로 피드백을 통한 업데이트 방식에만 집중하여, 어떤 학습 시나리오가 가장 효과적인지에 대한 고려는 부족했습니다. ActiveSaddler는 에이전트가 발전함에 따라 가장 유용한 학습 시나리오를 동적으로 선택하고 조정하는 자동화된 커리큘럼 학습 방법을 제안하여 최적화 효율을 극대화합니다.
InterEvolve: Test-Time Evolution of Reward Programs for Humanoid Loco-Manipulation
이 연구는 휴머노이드 로봇이 훈련받지 않은 새로운 작업을 재훈련 없이 해결하도록 하는 ‘테스트 시간 진화(test-time evolution)’ 방법을 제안합니다. 로봇이 이미 가진 능력을 새로운 작업에 맞게 재구성하고, 시도를 통해 스스로 학습하며 보상 프로그램을 발전시켜 복잡한 상호작용이 필요한 문제까지 해결할 수 있게 합니다.
GitHub Trending
DietrichGebert/ponytail
AI 에이전트가 마치 ‘게으른 시니어 개발자’처럼 생각하고 행동하게 만드는 프로젝트입니다. 불필요한 코드를 작성하지 않는 것을 최선으로 여기며, 가장 효율적인 방식으로 문제를 해결하도록 유도합니다.
pbakaus/impeccable
AI 하네스(harness)가 더 나은 디자인 결과물을 만들 수 있도록 돕는 디자인 언어 시스템입니다. 이 프레임워크를 통해 AI 에이전트의 디자인 능력을 향상시킬 수 있습니다.
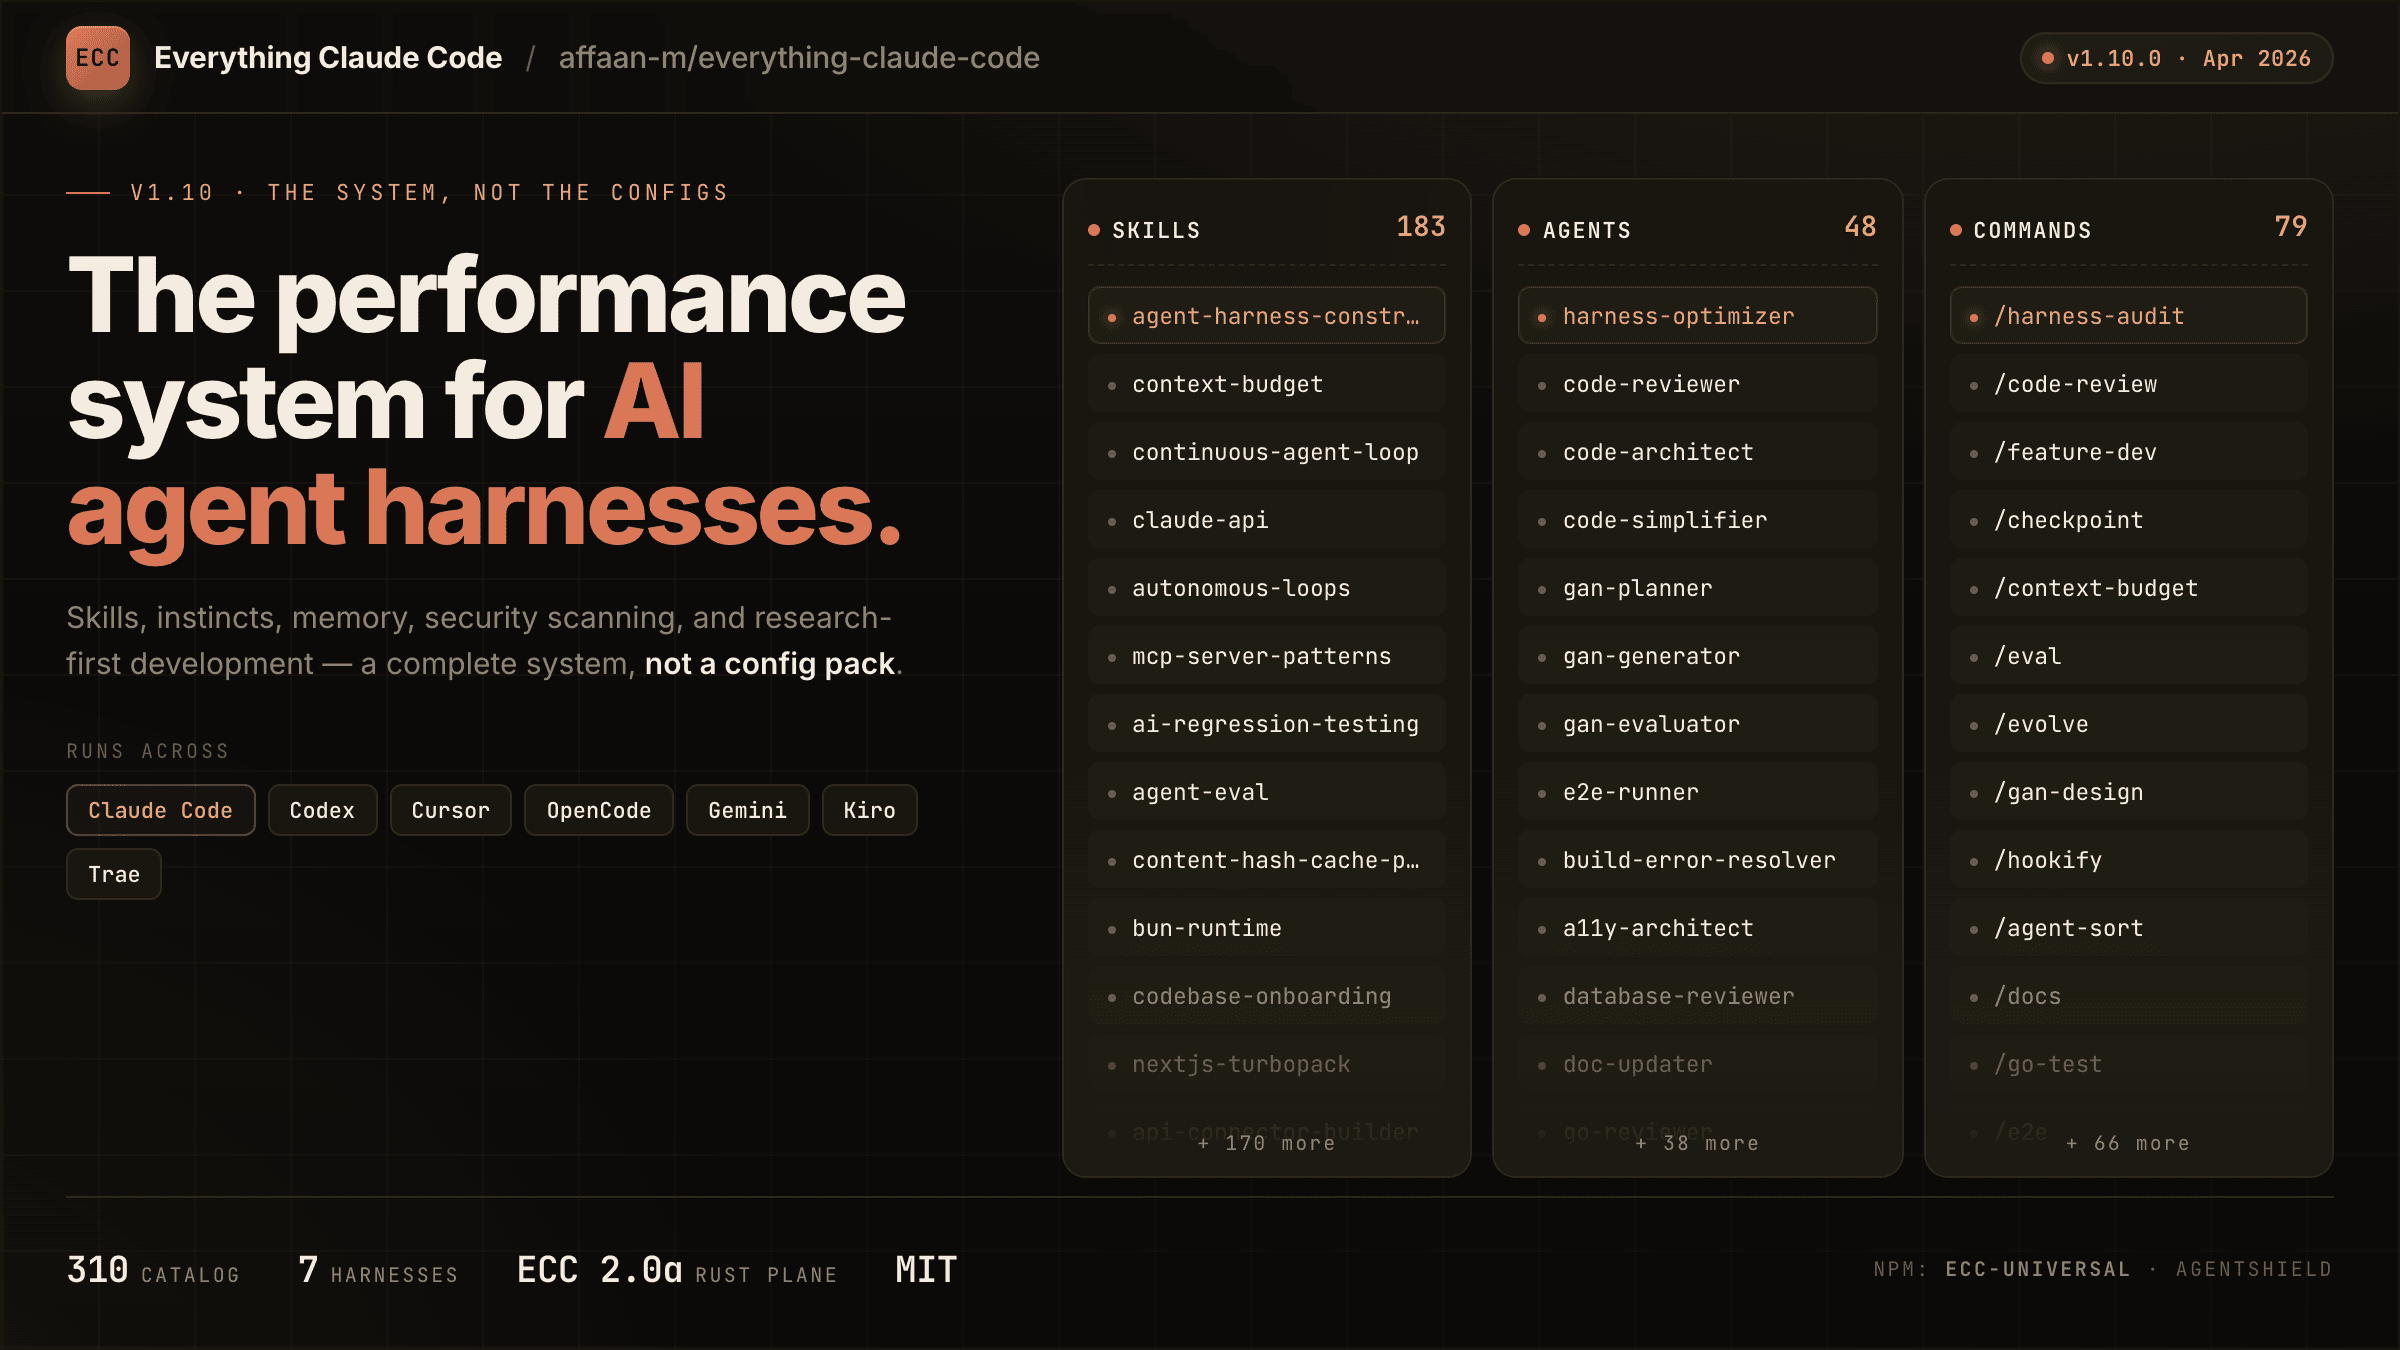
affaan-m/ECC
에이전트 하네스의 성능을 최적화하기 위한 시스템입니다. Claude Code, Codex 등 다양한 모델을 위해 기술, 메모리, 보안과 같은 핵심 기능을 강화하여 에이전트의 전반적인 능력을 향상시킵니다.
Panniantong/Agent-Reach
AI 에이전트가 인터넷 전체를 보고 검색할 수 있는 능력을 부여하는 도구입니다. 별도의 API 비용 없이 단일 CLI 명령어로 트위터, 레딧, 유튜브 등 다양한 플랫폼의 정보를 실시간으로 읽고 활용할 수 있게 해줍니다.
thedotmack/claude-mem
AI 에이전트가 여러 세션에 걸쳐 대화 내용을 기억하게 해주는 지속성 컨텍스트 시스템입니다. 이전 세션의 활동을 AI로 압축하여 저장하고, 다음 대화에서 관련성 높은 맥락을 자동으로 주입하여 에이전트의 연속성을 보장합니다.
오늘의 키워드
LLM Fine-tuning Transformer LoRA MoE DPO Eval Agent Prompt AI Agent