ECC — Claude, Codex 등을 위한 에이전트 성능 최적화 시스템
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
기존의 정책 증류 방식은 강화학습 전후의 최종적인 정책 변화만을 학생 모델에게 전달했습니다. 이 논문은 학습 과정 전반에 걸쳐 교사 모델의 정책 변화가 일관적인지를 확인함으로써, 더 효과적으로 학생 모델을 학습시키는 새로운 방법론인 Waypoint-OPD를 제안합니다. 이 방식은 교사 모델의 학습 초기와 후기 정책 변화의 일치 여부를 분석하여 학습 효율을 높입니다.

OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use
인간처럼 GUI와 프로그래밍 인터페이스를 모두 활용하여 컴퓨터 작업을 수행하는 범용 컴퓨터 사용 에이전트(GCUA)의 시대가 다가오고 있습니다. 하지만 최신 기술은 대부분 비공개로 연구에 한계가 있었는데, 이 논문은 GCUA의 설계와 연구를 촉진하기 위한 완전한 오픈소스 스택인 OpenGCUA를 소개합니다.

FDE-Gym: The Last Mile of AI Delivery
기존 AI 에이전트 벤치마크는 명확하게 정의된 작업만을 평가하여 실제 고객 환경의 복잡성을 반영하지 못했습니다. 이 논문은 실제 산업 전문가들이 설계한 95개의 과제를 포함하는 FDE-Gym을 제안하여, 모호한 요구사항을 명확히 하고 실제 시스템에서 발생하는 예기치 않은 제약 조건을 해결하는 에이전트의 능력을 평가합니다.

RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
비전-언어 모델이 2D 이미지만 보고 3D 공간을 이해하여 정교한 행동을 할 수 있는지 평가하는 것은 중요한 과제입니다. 이 논문은 모델이 3D 객체를 회전시켜 목표 실루엣과 일치시켜야 하는 RoTA-Bench를 제안하여, 모델의 3D 공간 추론 능력과 시각적 피드백을 통한 행동 보정 능력을 측정합니다.

Self-Evolving Agent Harness
이 연구는 AI 에이전트의 핵심 모델은 그대로 유지하면서, 에이전트의 작동을 돕는 프롬프트, 메모리, 워크플로우 같은 외부 소프트웨어 구성 요소를 스스로 개선하는 ‘자가 진화 하네스’ 개념을 제안합니다. 이 프레임워크는 피드백을 통해 성공적인 수정 사항을 다음 실행에 영구적으로 반영하는 프로세스를 공식화하여, 에이전트가 점진적으로 성능을 향상시키도록 돕습니다.
Hugging Face Blog
Each Reward to Its Relevant Tokens: Reward-Specific Token-Level Credit Assignment for Multi-Reward RL
다중 보상 강화학습은 각 보상 신호를 응답 전체에 고르게 분배하여 특정 부분만 수정해야 할 때 비효율적인 문제가 있었습니다. 이 논문은 MRTPO라는 새로운 기법을 제안하여, 각 보상이 연관된 특정 토큰에만 정확하게 할당되도록 함으로써 학습 효율을 크게 향상시킵니다.
CoDA: Co-Evolution of Data Engines and Action Policies
로봇 학습을 위한 생성형 시뮬레이션은 정책의 약점을 보완하는 데 효과적인 환경을 만드는 데 어려움이 있습니다. CoDA는 데이터 엔진과 행동 정책이 함께 진화하는 프레임워크로, 정책의 실패와 학습 과정을 공유하여 더 유용한 학습 환경을 자동으로 생성합니다.
Gen4P: Video Generators are 4D Perceivers
Gen4P는 단일 영상으로부터 4D 기하학 정보와 움직임을 복원하는 새로운 통합 프레임워크입니다. 이 기술은 사전 학습된 비디오 생성 모델을 4D 인식기로 재활용하여, 단 한 번의 인코더 패스로 비디오의 잠재 공간을 처리하고 요청된 4D 속성을 효율적으로 예측합니다.
토스 기술블로그
실행은 도메인별로, 문맥은 한 레포에
토스는 중앙 집중형 데이터 웨어하우스(DW)를 9개월에 걸쳐 도메인별 DW로 성공적으로 분리했습니다. 이 과정에서 서비스 중단 없이 점진적인 마이그레이션을 진행했으며, 실행은 각 도메인에서 독립적으로 하되 전체적인 문맥은 하나의 레포지토리에서 관리하는 구조를 채택했습니다.
토스뱅크가 패키지를 관리하는 방식 #2: 토스뱅크 패키지의 세 가지 기준
토스뱅크는 패키지 관리의 핵심 기준으로 안정성, 예측 가능성, 디버깅 편의성이라는 세 가지 원칙을 제시합니다. 이러한 기준을 충족하기 위해 패키지는 순수한 기능에만 집중하고, 문법 변환이나 번들링 같은 복잡한 빌드 과정은 패키지를 사용하는 서비스의 책임으로 분리하여 관리합니다.
GitHub Trending
anthropics/claude-plugins-official
앤트로픽이 공식적으로 관리하는 고품질 클로드(Claude) 코드 플러그인 디렉토리입니다. 개발자들은 이 공식 저장소를 통해 검증되고 신뢰할 수 있는 플러그인을 찾아 클로드의 기능을 손쉽게 확장할 수 있습니다.
K-Dense-AI/scientific-agent-skills
모든 AI 에이전트를 AI 과학자로 변모시키는 것을 목표로 하는 과학 분야 에이전트 스킬 라이브러리입니다. 생물학, 화학 등 다양한 분야를 아우르는 177개 이상의 검증된 스킬과 100개 이상의 과학 데이터베이스를 제공하여 복잡한 과학 연구의 자동화를 지원합니다.
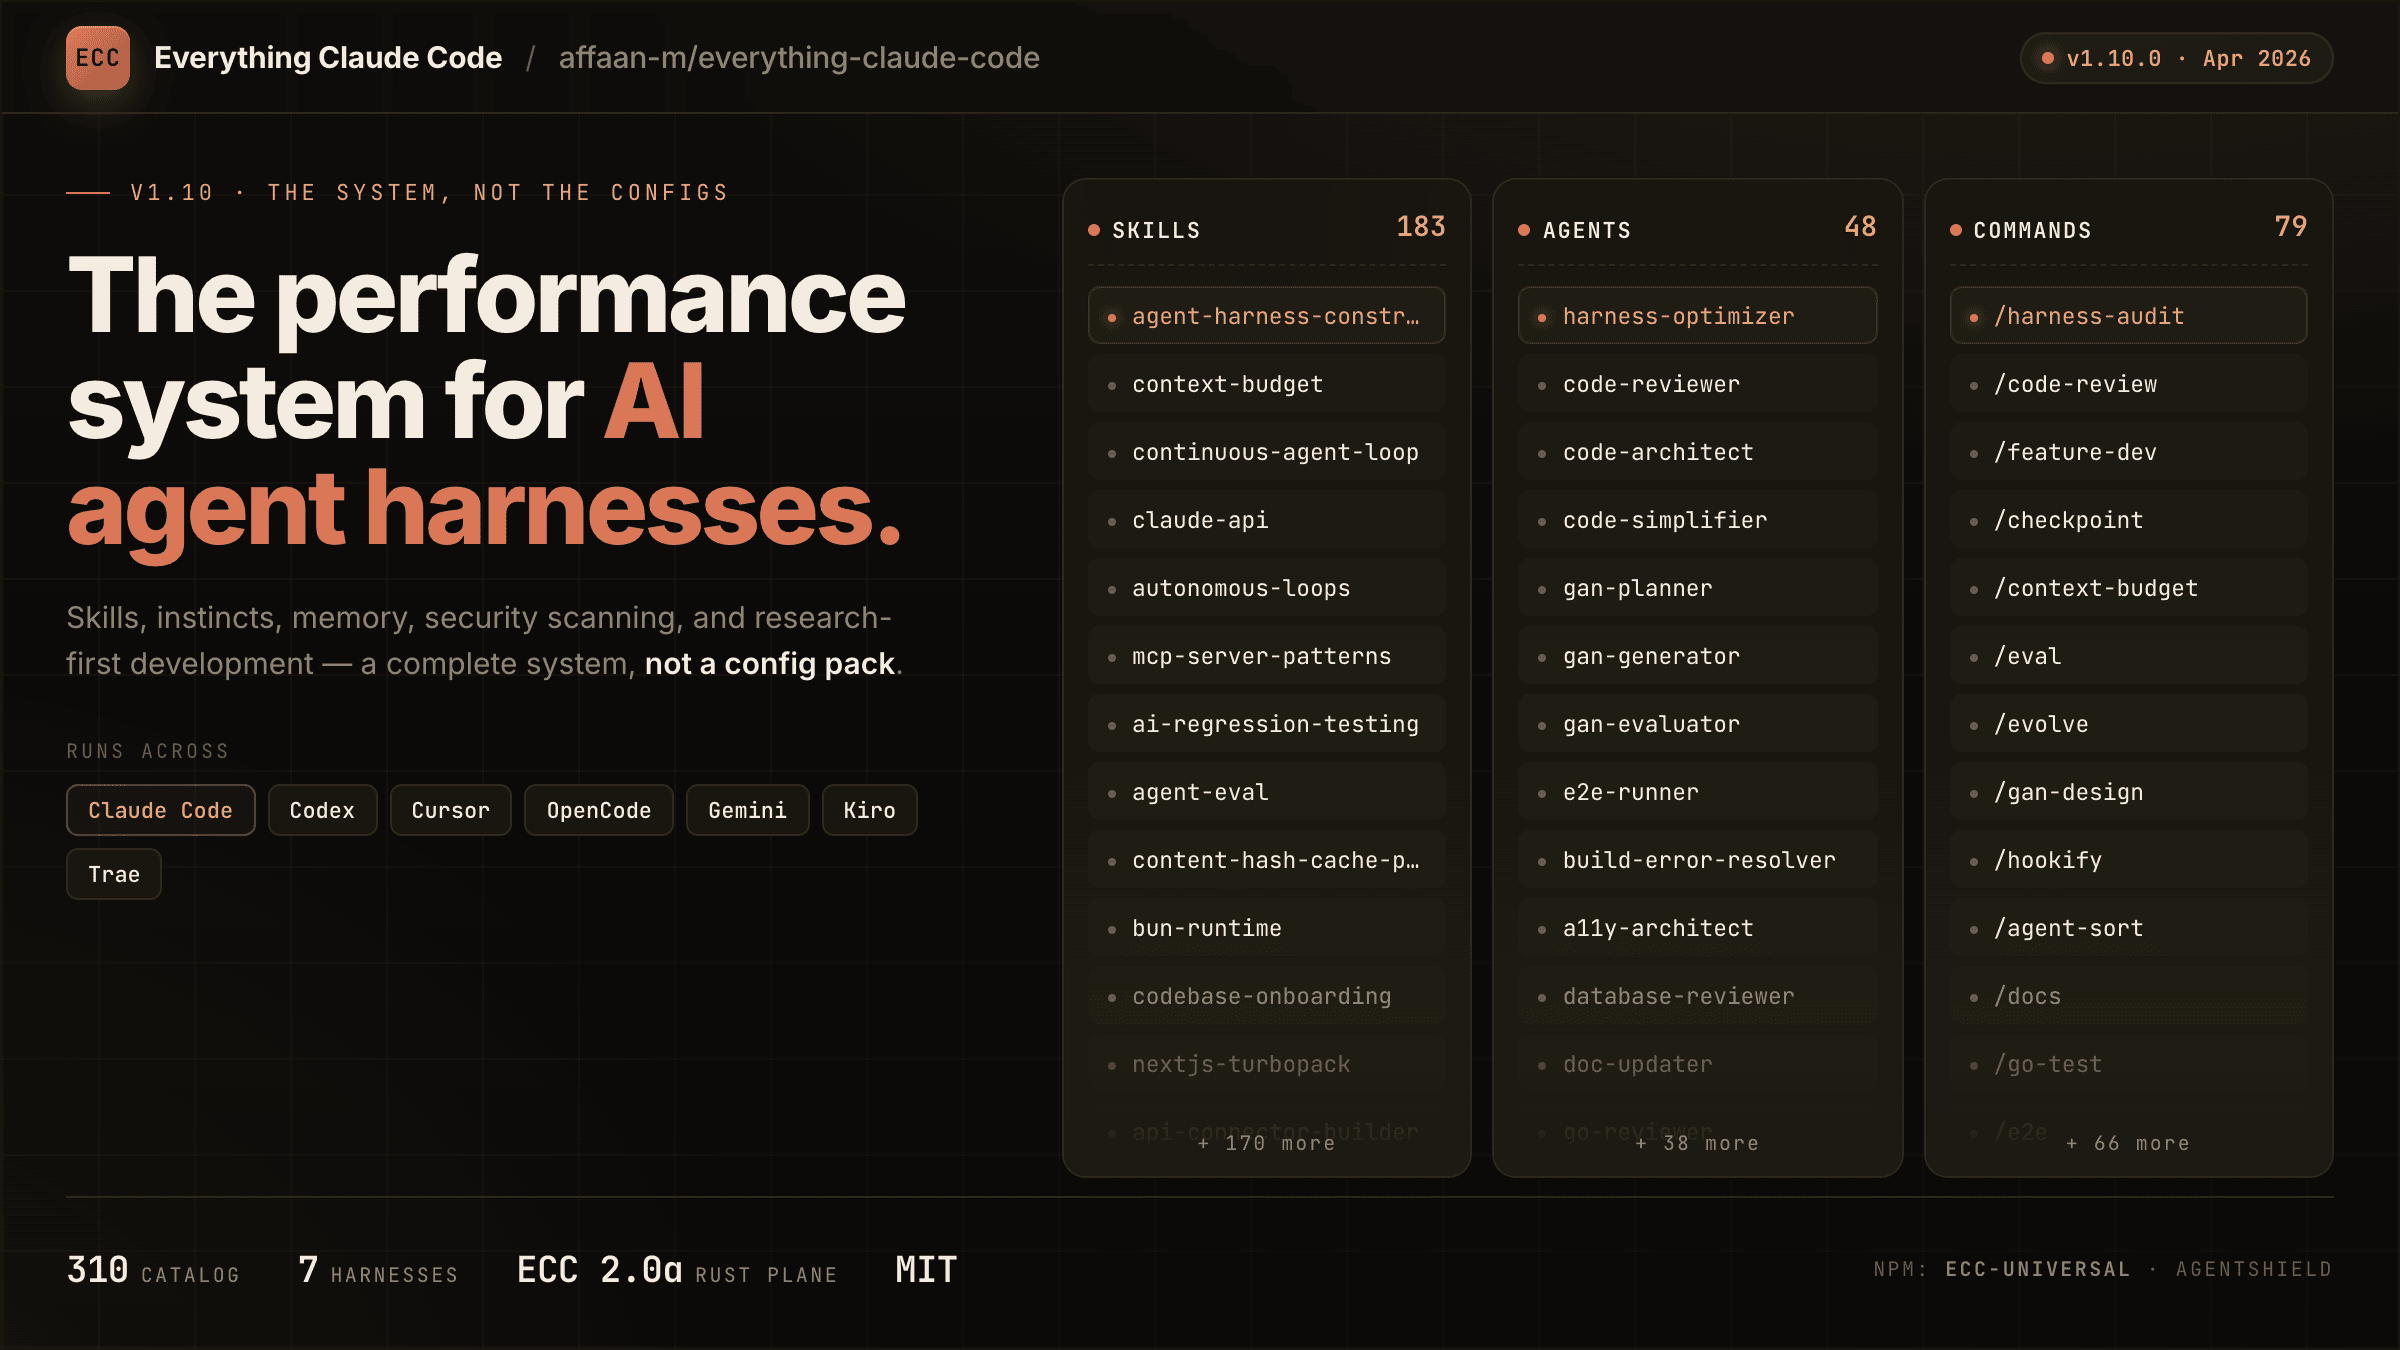
affaan-m/ECC
AI 에이전트의 성능을 최적화하기 위해 설계된 에이전트 하네스 시스템입니다. 스킬, 메모리, 보안 등을 종합적으로 관리하고 연구 중심의 개발 방식을 적용하여 클로드 코드(Claude Code), 코덱스(Codex)와 같은 다양한 에이전트의 효율성과 안정성을 극대화합니다.
mksglu/context-mode
AI 코딩 에이전트의 컨텍스트 창(Context window) 사용을 최적화하는 기술입니다. 도구의 출력물을 샌드박스 환경에서 처리하여 컨텍스트 크기를 크게 줄이고, 세션 간 메모리를 유지하여 여러 플랫폼에 걸쳐 일관되고 효율적인 에이전트 작동을 보장합니다.
ruvnet/ruflo
지능형 다중 에이전트 시스템과 자율 워크플로우를 구축하고 배포하기 위한 원조 에이전트 하네스(agent harness)입니다. 적응형 메모리, 자가 학습, 벡터 RAG 통합과 같은 고급 기능을 제공하여 여러 에이전트가 협력하는 복잡한 작업을 효율적으로 관리하고 실행할 수 있습니다.
오늘의 키워드
Vision DPO GPT Agent Eval Alignment Prompt Claude Claude Code AI Agent