NVIDIA OpenShell — 안전하고 프라이빗한 AI 에이전트 런타임
· #AI #LLM #트렌드 #기술블로그
arXiv 논문

WeVisOne-VL: Unified Visual Perception from Objects to Pixels
기존 비전-언어 모델(VLM)은 세밀한 시각적 인식 능력이 부족했습니다. WeVisOne-VL은 객체 수준부터 픽셀 수준까지의 인식을 통합하여 이 문제를 해결하는 강력한 VLM입니다. 이 모델은 구조화된 다음 토큰 예측 방식을 통해 객체 탐지, 분할, OCR 등 다양한 시각적 작업을 지원하며, 사용자가 원하는 어떤 세분화된 수준에서도 정확한 위치 파악을 가능하게 합니다.

Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation
영화 같은 고품질 영상을 생성하려면 적은 입력 정보로 시간적 흐름을 추론하고 캐릭터, 장면, 카메라 등 여러 요소를 정교하게 제어해야 합니다. 이 연구는 멀티모달 대규모 언어 모델(MLLM)의 잠재 표현을 비디오 생성에 효과적으로 활용하는 ‘요소 인식 예측 학습’ 기법을 제안합니다. 이를 통해 비디오 생성 모델이 MLLM의 깊은 이해도를 바탕으로 다양한 요소를 분리하여 제어하며 고품질 영상을 만들 수 있도록 돕습니다.

Deep Search in Real-World Web Environments
기존의 딥 서치 에이전트들은 실제 웹 환경처럼 복잡하고 다양한 정보 소스를 다루는 능력에 대한 평가가 부족했습니다. 실제 웹에서는 에이전트가 자율적으로 정보를 검색하고 통합하는 복잡한 상호작용이 필요하기 때문입니다. 이 연구는 이러한 한계를 극복하기 위해, 에이전트가 실제 웹 환경에서 엔드투엔드로 연구를 수행하는 능력을 평가하는 새로운 방법을 제시합니다.

Editing Images into Reusable Layers via Compositional Edit-Prior Distillation
기존 이미지 편집 모델은 결과물을 단일 이미지로 출력하여 재사용이나 정교한 부분 수정이 어려웠습니다. 이 연구는 지시에 따라 이미지를 편집함과 동시에 재사용 가능한 RGBA 레이어를 생성하는 통합 프레임워크 ‘LayerEditor’를 제안합니다. 이를 통해 사용자는 특정 영역만 정밀하게 수정하고, 생성된 레이어를 다른 작업에 다시 활용하는 등 유연한 편집이 가능해집니다.

IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems
IQuest-Q1은 명령어 기반 인터페이스(CLI) 시스템을 위한 새로운 에이전트 파운데이션 모델입니다. 이 모델은 3200억 개의 파라미터를 가진 희소 전문가 혼합(MoE) 구조를 특징으로 하며, 안정적인 사전 학습과 데이터 확장 등 3단계 개발 과정을 거쳤습니다. IQuest-Q1은 특히 코딩 데이터 비중을 높인 학습 전략을 통해 CLI 환경에서 복잡한 작업을 수행하는 에이전트의 핵심 역량을 발전시키는 것을 목표로 합니다.
Hugging Face Blog
Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation
시네마틱 영상 생성은 제한된 입력으로 시간적 추론을 하고 캐릭터, 장면, 카메라 등 다양한 요소를 제어해야 하는 과제입니다. 이 연구는 멀티모달 대규모 언어 모델(MLLM)의 잠재 표현을 영상 확산 모델이 효과적으로 활용하도록 만드는 ‘요소 인식 예측 학습’ 기법을 제안하여, 각 요소를 정교하게 제어하는 고품질 영상 생성을 가능하게 합니다.
Rethinking Sequence Compression with Test-time Regression
효율적인 언어 및 멀티모달 모델에서 시퀀스 압축은 중요한 병목 지점이지만 기존 방식은 성능이 부족합니다. 이 논문은 ‘테스트 시점 회귀’라는 새로운 접근법을 제안하는데, 입력 토큰을 회귀 문제로 정의하고 그 계수를 압축된 표현으로 사용하여 기존 방식보다 뛰어난 성능을 보여줍니다.
Inherited, Not Invented: Tracing the Provenance of Wait in Reasoning Models
추론 모델이 답변 전 ‘{wait}’를 출력하며 재고하는 행동은 강화학습(RL)을 통해 학습된 것으로 알려져 왔습니다. 하지만 이 연구는 해당 행동이 강화학습의 발명이 아닌, 사전 학습 데이터로부터 물려받은 ‘유산’임을 밝혀냈으며, 모델의 학습 이력 추적을 통해 이를 증명합니다.
토스 기술블로그
머릿속에 있던 로그 정의 기준을 모두의 AI 스킬로 만들기
토스는 개발자 개인의 암묵적인 지식에 의존하던 로그 정의 기준을 AI를 활용해 시스템화했습니다. 이 시스템은 도구가 규칙을 검사하고 AI가 초안을 제안하면 사람이 최종 확정하는 방식으로, 누구나 일관된 고품질의 로그를 손쉽게 작성할 수 있도록 지원합니다.
GitHub Trending
anthropics/knowledge-work-plugins
앤트로픽이 공개한 오픈소스 플러그인 저장소입니다. 이 플러그인들은 주로 지식 근로자들이 ‘클로드 코워크(Claude Cowork)’ 환경에서 생산성을 높일 수 있도록 설계되었습니다.
NVIDIA/OpenShell
엔비디아가 공개한 OpenShell은 자율 AI 에이전트를 위한 런타임 환경입니다. 이 프로젝트는 AI 에이전트가 안전하고 프라이빗한 공간에서 독립적으로 작동할 수 있도록 지원하는 데 중점을 둡니다.
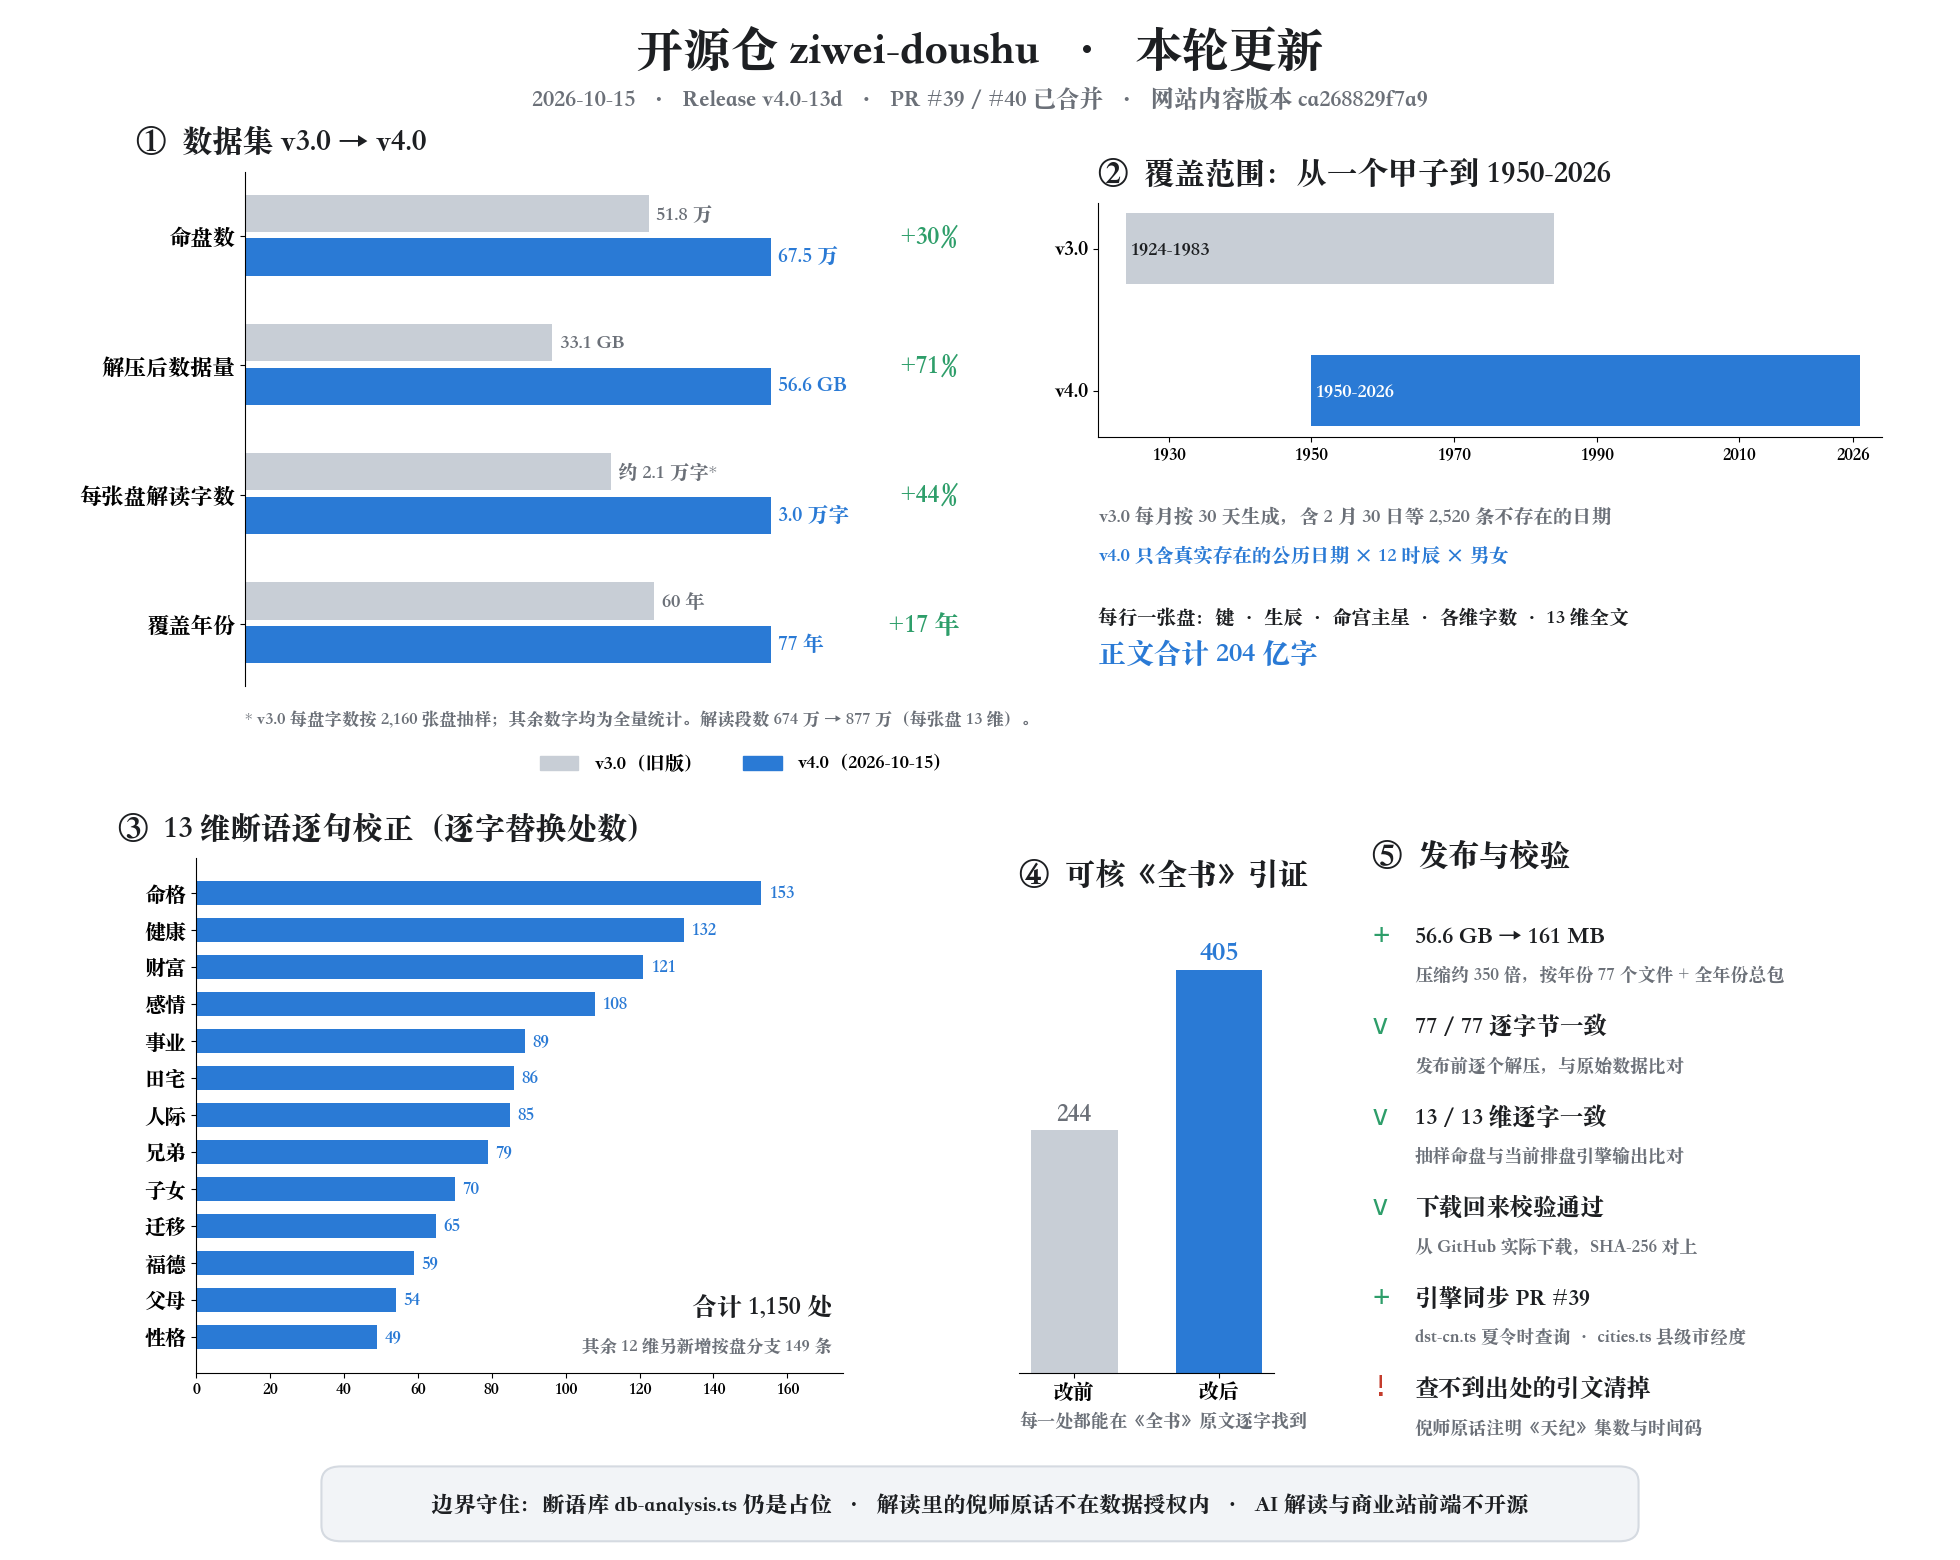
Renhuai123/ziwei-doushu
자미두수(紫微斗数)를 위한 오픈소스 운세 분석 엔진입니다. 특정 학파의 체계를 기반으로 완전한 풀이 알고리즘, 지식 베이스, 고서 원문 데이터까지 포함하고 있어 관련 시스템 구축에 활용할 수 있습니다.
SnailSploit/Claude-Red
Claude-Red는 앤트로픽의 클로드(Claude) 모델을 위해 설계된 공격적 보안 기술 라이브러리입니다. SQL 인젝션부터 익스플로잇 개발까지 특정 공격에 대한 전문가 수준의 방법론을 클로드에게 학습시키는 구조화된 파일들로 구성되어 있습니다.
anthropics/knowledge-work-plugins
앤트로픽이 공개한 오픈소스 플러그인 저장소입니다. 이 플러그인들은 주로 지식 근로자들이 ‘클로드 코워크(Claude Cowork)’ 환경에서 생산성을 높일 수 있도록 설계되었습니다.
오늘의 키워드
Vision LLM Inference Retrieval Agent Eval Distillation MoE Multimodal Reasoning