<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" xml:lang="ko"><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://joyuno.github.io/ai-tech-digest/feed.xml" rel="self" type="application/atom+xml" /><link href="https://joyuno.github.io/ai-tech-digest/" rel="alternate" type="text/html" hreflang="ko" /><updated>2026-10-28T10:56:24+09:00</updated><id>https://joyuno.github.io/ai-tech-digest/feed.xml</id><title type="html">AI Tech</title><subtitle>매일 아침의 AI 기술 트렌드 — 자동 수집, 한국어 요약</subtitle><author><name>joyuno</name></author><entry><title type="html">AMBIT — ScenePlans 기반의 직관적인 공간 음향 생성 및 편집</title><link href="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/28/ai-tech-digest.html" rel="alternate" type="text/html" title="AMBIT — ScenePlans 기반의 직관적인 공간 음향 생성 및 편집" /><published>2026-10-28T00:00:00+09:00</published><updated>2026-10-28T00:00:00+09:00</updated><id>https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/28/ai-tech-digest</id><content type="html" xml:base="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/28/ai-tech-digest.html"><![CDATA[<h2 id="-arxiv-논문"><i data-lucide="book-open"></i> arXiv 논문</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.34415v1/teaser.png" alt="Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.34415" target="_blank">Spatial Audio Generation and Editing with Executable Plans and Self-Distilling Transfusion</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <p>공간 음향을 생성하고 편집하는 통합 프레임워크 AMBIT을 제안합니다. 이 기술은 실행 가능한 ‘ScenePlans’를 통해 음원의 내용, 활동, 3D 위치 등을 지정하여, 자동 회귀적 계획과 렌더링을 결합함으로써 직관적인 공간 음향 저작을 가능하게 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 42</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.33413v1/pipeline.png" alt="AV-FABLE: Audio-Visual Manipulation Forensics in Long-Form Videos" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.33413" target="_blank">AV-FABLE: Audio-Visual Manipulation Forensics in Long-Form Videos</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Eval</span> 
</div>

  <p>긴 영상 속 짧게 삽입된 AI 조작을 탐지하는 것은 기존 방법으로 어렵다는 문제를 해결하기 위해 새로운 벤치마크 AV-FABLE을 공개합니다. 이 데이터셋은 긴 영상에 소리나 화면이 국소적으로 조작된 사례들을 포함하여, 실제와 유사한 환경에서 딥페이크 탐지 기술의 성능을 평가하고 발전시키는 데 기여합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 39</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.33512v1/overview_v5.png" alt="Eat Your Precision: Precision Objective Mitigates Reward Hacking in Rubric-based RL" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.33512" target="_blank">Eat Your Precision: Precision Objective Mitigates Reward Hacking in Rubric-based RL</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#RAG</span> 
</div>

  <p>루브릭 기반 보상으로 강화학습(RL)을 진행할 때, 모델이 보상을 극대화하기 위해 불필요하거나 부정확한 내용을 길게 생성하는 ‘보상 해킹’ 문제가 발생합니다. 이 문제를 해결하기 위해 기존의 재현율(recall) 목표에 정밀도(precision) 목표를 추가하여, 모델이 더 간결하고 정확한 결과물을 생성하도록 유도하는 새로운 학습 방법을 제안합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 33</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.31635v1/teaser.png" alt="HiP3R: Hierarchical Pose Graphs for Long-Horizon 3D Reconstruction" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.31635" target="_blank">HiP3R: Hierarchical Pose Graphs for Long-Horizon 3D Reconstruction</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <p>수천 프레임에 달하는 긴 영상으로부터 3D 모델을 재구성할 때 발생하는 계산 비용과 데이터 불일치 문제를 해결하는 계층적 포즈 그래프(HiP3R) 기법을 제시합니다. 이 방법은 영상을 여러 조각으로 나누어 처리한 뒤, 계층적 그래프를 이용해 각 조각을 효율적으로 정렬하고 병합하여 전역적으로 일관된 3D 재구성을 가능하게 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 24</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.35193v1/main_figure.png" alt="Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.35193" target="_blank">Trustworthy Recursive Self-Improvement in the Era of Large Models: Foundation, Risks, Evaluation and Open Challenges</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Eval</span> 
</div>

  <p>대형 모델이 스스로를 개선하는 재귀적 자기 개선(RSI) 기술이 발전하고 있지만, 이러한 과정이 신뢰할 수 있는 방향으로 이루어질지는 보장되지 않습니다. 본 논문은 RSI의 개념적 기반과 잠재적 위험을 분석하고, 신뢰성 있는 평가 방법론과 향후 과제를 제시하며 안전한 AI 개발의 중요성을 강조합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 22</span> 


</div>

</div>

<hr />

<h2 id="-hugging-face-blog"><i data-lucide="cpu"></i> Hugging Face Blog</h2>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.36456" target="_blank">LociArt: A Unified Paradigm for Free-Style Local Video Stylization</a></h3>

  <p>LociArt는 영상의 특정 영역에만 원하는 스타일을 자유롭게 적용하는 새로운 패러다임을 제시합니다. 이 기술은 GRN(Generative Refinement Networks)을 기반으로 스타일을 적용할 위치와 종류를 명시적으로 지정하여, 목표가 아닌 콘텐츠는 그대로 보존하면서 시공간적 일관성을 유지하는 정교한 로컬 편집을 가능하게 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Yuxuan Chen, Feng Xie, Jiagao Hu</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.36068" target="_blank">Rollback: Experience Backtracking in World Models for Policy Improvement</a></h3>

  <p>Rollback은 월드 모델을 단순한 순방향 시뮬레이터를 넘어, 과거의 결정 시점으로 되돌아가 다른 행동의 결과를 탐색하는 새로운 로봇 정책 개선 패러다임입니다. 이 ‘경험 백트래킹’ 기능을 통해 물리적 환경에서는 불가능한 가상 시나리오 분석을 수행하여 정책을 효율적으로 향상시킬 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Jiayi Luo, Yang Zhang, Liliang Chen</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.36420" target="_blank">SO-101 Bench: Accessible Spatial Manipulation</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Eval</span> 
</div>

  <p>SO-101 Bench는 로봇 학습 입문에 널리 사용되는 저비용 로봇 팔을 위한 새로운 시뮬레이션 벤치마크입니다. 실제 로봇의 디지털 트윈 환경을 기반으로 언어 지시에 따른 공간 조작 능력을 평가하는 과제들을 제공하여, 기존 물리적 하드웨어 벤치마크의 한계를 극복하고 접근성 높은 연구 환경을 조성합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Truman Hickok</span>
</div>

</div>

<hr />

<h2 id="-토스-기술블로그"><i data-lucide="credit-card"></i> 토스 기술블로그</h2>

<div class="digest-item">

  <h3><a href="https://toss.tech/article/snap-llm-cost-reduction" target="_blank">손가락 튕기기로 LLM 비용 줄이기</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <p>토스는 급증하는 LLM 운영 비용을 절감하기 위한 효율적인 해결책을 모색했습니다. 이 글은 복잡한 과정 없이 간단한 아이디어로 LLM API 호출 비용을 신속하게 최적화한 토스팀의 경험과 노하우를 공유하며, 누구나 쉽게 적용할 수 있는 비용 절감 팁을 제공합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> 토스</span>
</div>

</div>

<hr />

<h2 id="-github-trending"><i data-lucide="star"></i> GitHub Trending</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/elayadesign/ai-design-skills" alt="elayadesign/ai-design-skills" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/elayadesign/ai-design-skills" target="_blank">elayadesign/ai-design-skills</a></h3>

  <p>AI를 활용한 디자인 기술을 모아놓은 저장소입니다. 디자이너가 AI를 효과적으로 사용하여 창의적인 결과물을 만들어내는 데 필요한 다양한 기술과 노하우를 제공합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1395 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/Nutlope/hallmark/main/site/OG-hallmark.png" alt="Nutlope/hallmark" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/Nutlope/hallmark" target="_blank">Nutlope/hallmark</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#AI Coding</span> 
</div>

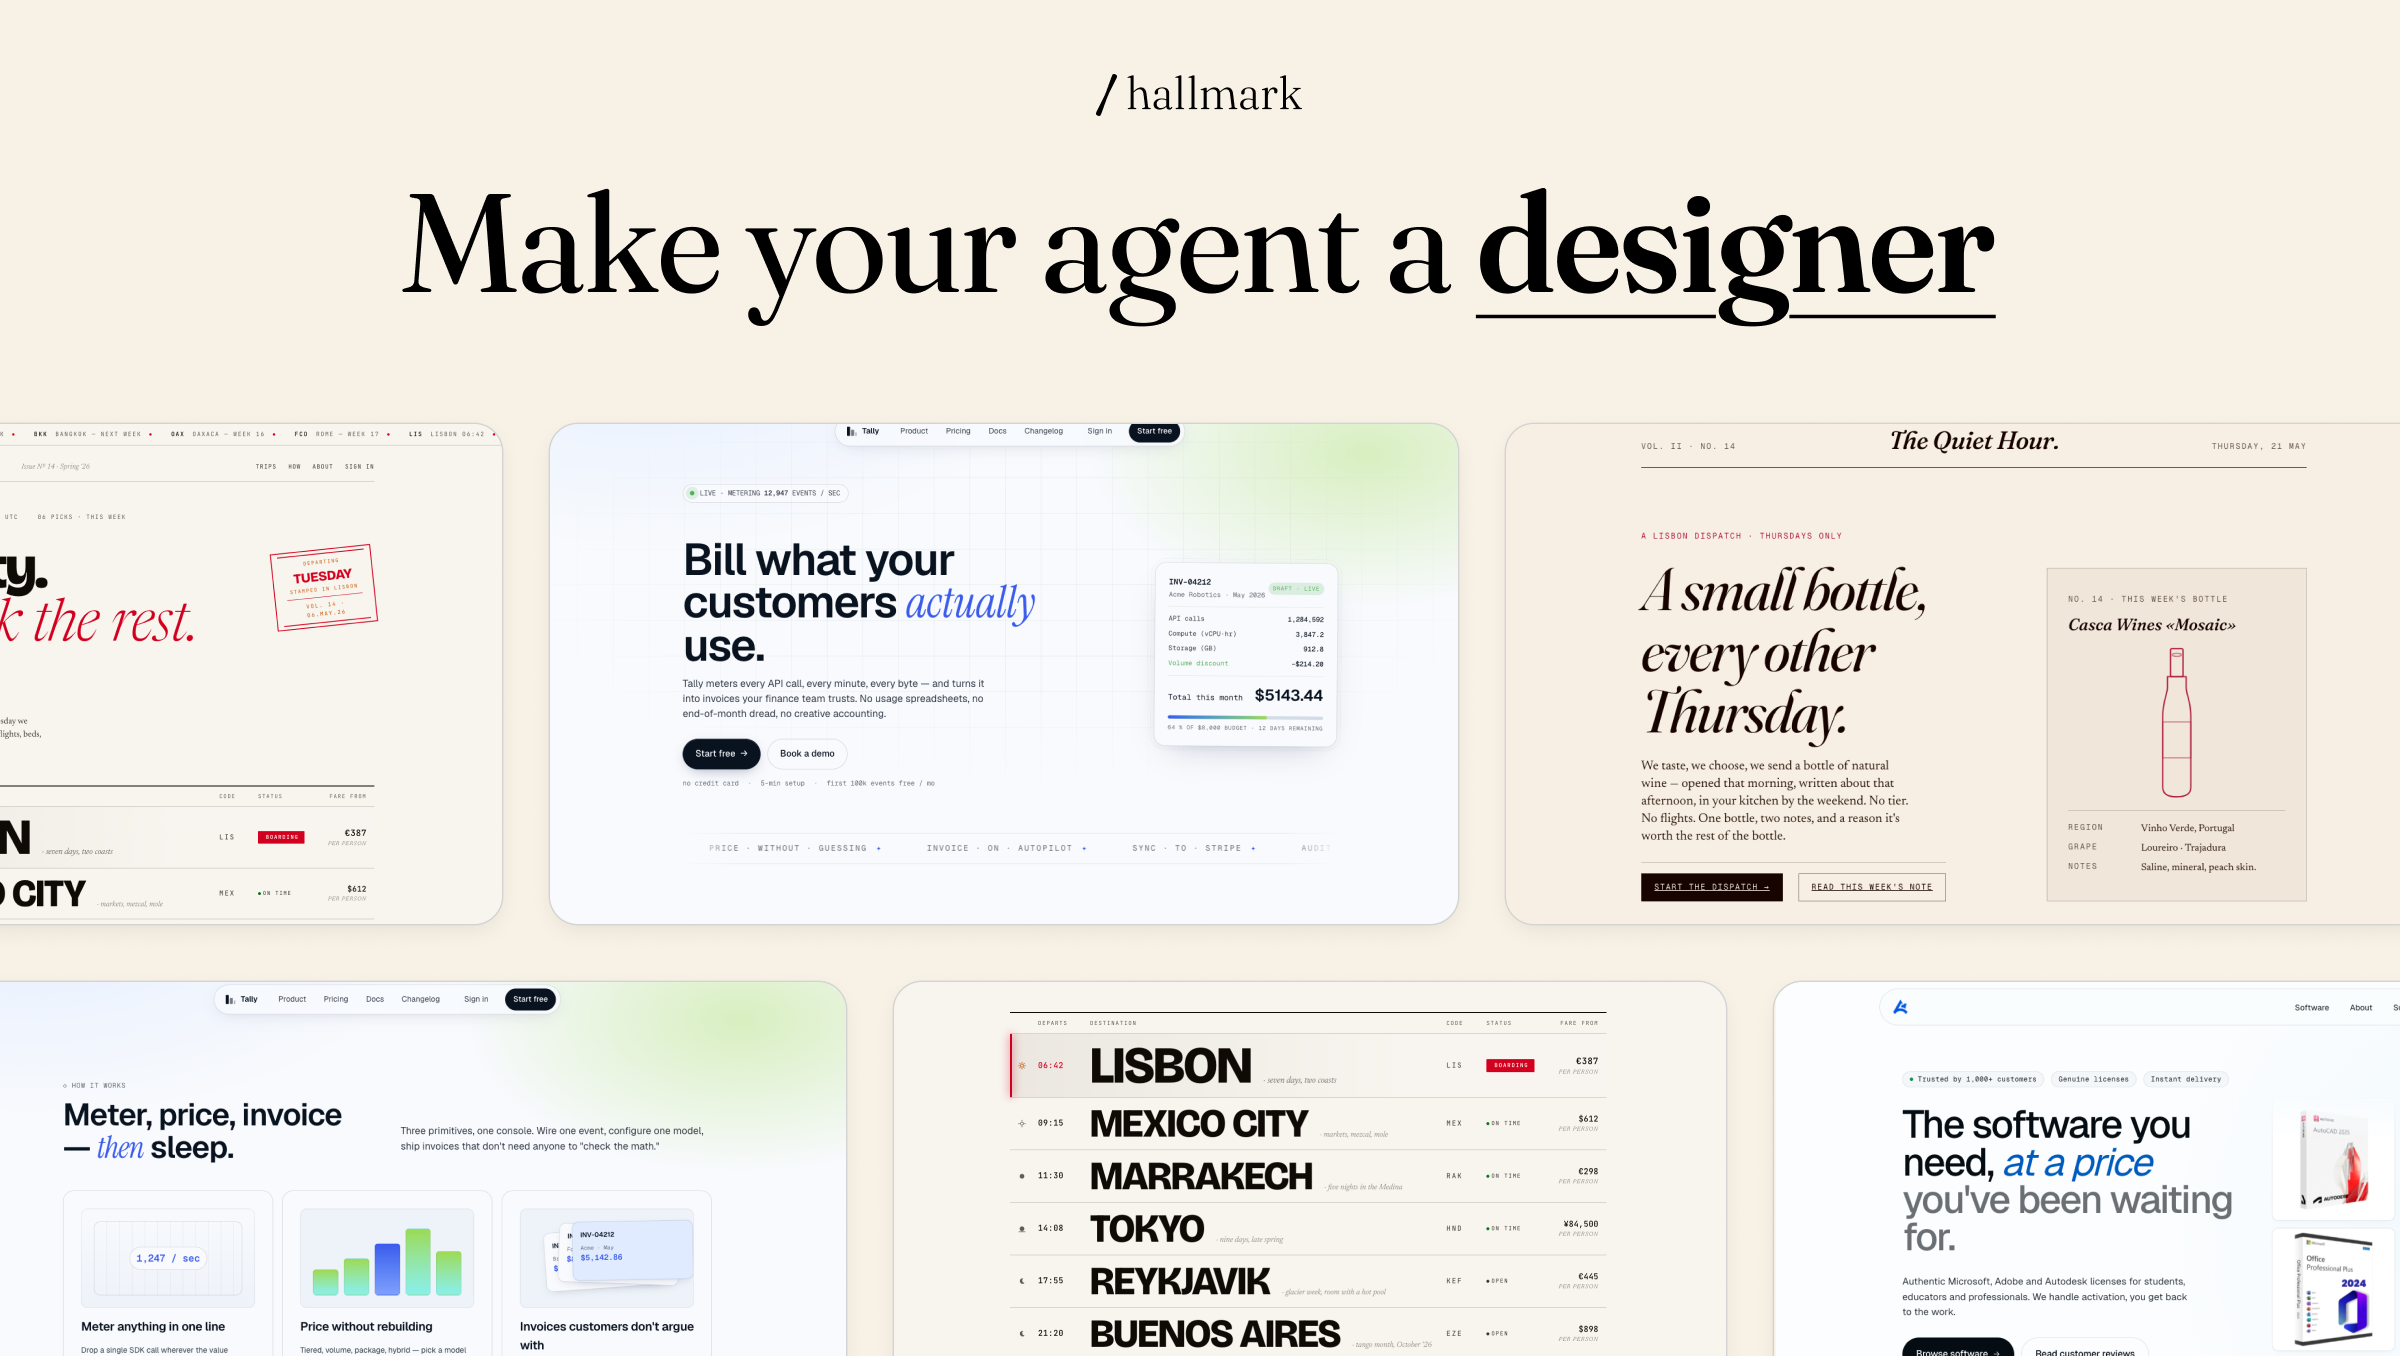
  <p>이 프로젝트는 AI가 생성하는 저품질 결과물을 방지하기 위한 디자인 기술을 제공합니다. Claude Code, Cursor, Codex와 같은 AI 모델을 사용하여 더 정교하고 품질 높은 디자인 결과물을 얻도록 돕습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 2830 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/nightly-labs/openbot" alt="nightly-labs/openbot" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/nightly-labs/openbot" target="_blank">nightly-labs/openbot</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>Openbot은 로컬 우선 방식으로 구동되는 데스크톱 AI 협업 공간입니다. 여러 AI 에이전트를 지속적인 팀원처럼 활용하며, 전용 작업 공간, 파일 공유, 브라우저 제어 등의 기능을 통해 복잡한 작업을 자동화하고 협업할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 777 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/pbakaus/impeccable" alt="pbakaus/impeccable" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/pbakaus/impeccable" target="_blank">pbakaus/impeccable</a></h3>

  <p>Impeccable은 AI가 더 나은 디자인 결과물을 만들도록 돕는 디자인 언어 시스템입니다. 이 가이드라인을 활용하면 AI에게 디자인 작업을 더 효과적으로 지시하고 고품질의 결과물을 얻을 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1449 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/makecindy/cindy" alt="makecindy/cindy" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/makecindy/cindy" target="_blank">makecindy/cindy</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>Cindy는 ‘생각한 대로 이루어지는’ 것을 목표로 하는 오픈소스 AI 에이전트입니다. 별도의 복잡한 설정 없이 바로 사용할 수 있도록 설계되어, 사용자가 원하는 작업을 즉시 자동화하고 처리할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1465 today</span> 

</div>

</div>

<hr />

<h2 id="-오늘의-키워드"><i data-lucide="bar-chart-3"></i> 오늘의 키워드</h2>

<div class="keywords">
<code>Audio</code> <code>Benchmark</code> <code>RAG</code> <code>Vision</code> <code>Inference</code> <code>Workflow</code> <code>Prompt</code> <code>LLM</code> <code>Cursor</code> <code>Claude</code> 
</div>]]></content><author><name>joyuno</name></author><category term="AI" /><category term="Tech" /><category term="AI" /><category term="LLM" /><category term="트렌드" /><category term="기술블로그" /><summary type="html"><![CDATA[arXiv 논문]]></summary></entry><entry><title type="html">Nutlope/hallmark — Claude Code 등 AI 슬롭 방지 디자인 스킬</title><link href="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/27/ai-tech-digest.html" rel="alternate" type="text/html" title="Nutlope/hallmark — Claude Code 등 AI 슬롭 방지 디자인 스킬" /><published>2026-10-27T00:00:00+09:00</published><updated>2026-10-27T00:00:00+09:00</updated><id>https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/27/ai-tech-digest</id><content type="html" xml:base="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/27/ai-tech-digest.html"><![CDATA[<h2 id="-arxiv-논문"><i data-lucide="book-open"></i> arXiv 논문</h2>
<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.31668v1/cover_teaser.png" alt="Reading, Writing, Sharing, and Interacting with the World through Video" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.31668" target="_blank">Reading, Writing, Sharing, and Interacting with the World through Video</a></h3>

  <p>비디오 파운데이션 모델과 월드 모델의 발전을 ‘월드 모델링’이라는 통일된 관점으로 조망하는 연구입니다. 이 논문은 관찰된 비디오를 잠재적인 시공간 세계의 불완전하고 손실된 투영으로 간주하며, 이를 통해 비디오와 실제 세계 간의 관계를 탐구합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 224</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.30932v1/fig_cross_session_case.png" alt="UserArena: Benchmarking Interactive User Simulation for Long-Horizon Shopping Agents" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.30932" target="_blank">UserArena: Benchmarking Interactive User Simulation for Long-Horizon Shopping Agents</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Eval</span> 
</div>

  <p>장기적인 쇼핑 목표를 달성하는 에이전트의 개발 및 평가를 위한 새로운 벤치마크 ‘UserArena’를 소개합니다. UserArena는 실제 사용자의 장기적이고 세분화된 행동 데이터를 제공하여, 긴 상호작용에 걸친 에이전트의 성능을 충실하게 검증할 수 있도록 지원합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 47</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.31162v1/Harness_cropped.png" alt="HiSTEVE 1.0: Harnessing Human-Interface VLA Agents for Open-World Games" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.31162" target="_blank">HiSTEVE 1.0: Harnessing Human-Interface VLA Agents for Open-World Games</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>마인크래프트와 같은 오픈월드 게임에서 인간처럼 행동하는 가상 에이전트를 구축하기 위한 ‘HiSTEVE 1.0’을 제안합니다. 이 에이전트는 기존 에이전트들과 달리 장기적인 자율성과 네이티브 인터페이스 제어 능력을 결합하여, API나 사전 정의된 기술 없이도 복잡한 작업을 수행할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 38</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.32253v1/RSIHub-agent-workflow.png" alt="RSIHub: A Composable Framework for Agent-Evolution Methods" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.32253" target="_blank">RSIHub: A Composable Framework for Agent-Evolution Methods</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Orchestration</span> <span class="sub-tag">#Eval</span> 
</div>

  <p>실행 피드백을 통해 에이전트의 프롬프트, 스킬, 도구 등을 개선하는 ‘에이전트 진화’ 방법론을 위한 오픈소스 프레임워크 ‘RSIHub’를 소개합니다. RSIHub는 반복적인 실험 기반을 공통 인프라로 제공하여, 연구자들이 진화 정책 자체에만 집중할 수 있도록 개발 및 비교, 확장을 용이하게 만듭니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 34</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.32965v1/RynnUnify_Teaser_v15_cropped.png" alt="RynnUnify: Towards Unified Embodied Brain" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.32965" target="_blank">RynnUnify: Towards Unified Embodied Brain</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="target"></i> 신뢰성/안전</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>강력한 물리 세계 이해 능력과 장기적인 시각적 계획 능력을 결합한 16B 규모의 통합 체화 모델 ‘RynnUnify’를 제안합니다. 이 모델은 공간 추론, 물리적 예측 등의 능력을 바탕으로 강화학습을 통해 에이전트로 확장되어, 연속적인 하위 작업을 시각적으로 예측하고 실행할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 33</span> 


</div>

</div>

<hr />

<h2 id="-hugging-face-blog"><i data-lucide="cpu"></i> Hugging Face Blog</h2>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.32965" target="_blank">RynnUnify: Towards Unified Embodied Brain</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="target"></i> 신뢰성/안전</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>RynnUnify는 160억 개의 파라미터를 가진 통합된 구체화(embodied) 모델로, 비디오-언어 추론을 통해 물리적 세계에 대한 깊은 이해와 장기적인 시각적 계획 능력을 결합합니다. 이 모델은 공간 추론, 물리적 예측, 그라운딩(grounding)과 같은 능력을 바탕으로 강화학습을 통해 에이전트로서의 기능까지 확장됩니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Minghao Zhu, Bohan Hou, Kun Xiang</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.33135" target="_blank">WorldCast: World-Consistent Character Video Generation with Large-Angle Camera Control</a></h3>

  <p>WorldCast는 영화 같은 캐릭터 영상을 생성하기 위한 기술로, 큰 각도의 카메라 제어에 특화되어 있습니다. 기존 모델들이 회전, 이동 등 큰 시점 변화에서 겪던 기하학적 왜곡이나 외형 변질 문제를 해결하여 일관성 있는 캐릭터 영상을 만들어냅니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Lei Cao, Yu Liu, Wenhua Liao</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.32909" target="_blank">HoloBoxing: A Simple Recipe for Humanoid Boxing with 7 Minutes of Single-GPU Training</a></h3>

  <p>HoloBoxing은 단일 GPU로 7분 만에 휴머노이드 복싱 동작을 학습시키는 간단한 방법을 제시합니다. 이 기술은 사전 훈련된 전신 컨트롤러를 기반으로 재사용 가능한 운동 기술과 실제 과제 수행 결정을 분리하며, 모방 학습으로 초기화한 뒤 강화학습으로 상호작용 행동을 미세 조정하여 효율적인 학습을 가능하게 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Xihan Ma, Bo Zhang, Boxiong Li</span>
</div>

</div>

<hr />

<h2 id="-무신사-기술블로그"><i data-lucide="shirt"></i> 무신사 기술블로그</h2>

<div class="digest-item">

  <h3><a href="https://techblog.musinsa.com/%EB%8C%80ai%EC%8B%9C%EB%8C%80%EC%97%90-%EC%9D%BC%ED%95%98%EB%8A%94-%EB%B0%A9%EC%8B%9D%EC%9D%98-%EB%B3%80%ED%99%94%EC%97%90-%EB%8C%80%ED%95%9C-%EA%B3%A0%EC%B0%B0-6d11e0b1fead?source=rss----f107b03c406e---4" target="_blank">대AI시대에 일하는 방식의 변화에 대한 고찰</a></h3>

  <p>AI 코딩 에이전트의 등장으로 개발자의 업무 방식이 한 번에 하나의 작업을 처리하던 것에서 여러 AI 에이전트를 동시에 관리하는 방식으로 변화했습니다. 이로 인해 작업의 병목 현상이 코딩 자체에서 인간의 판단과 지시로 옮겨가게 되었으며, 이는 AI 시대에 인간의 역할이 어떻게 변하는지에 대한 고찰을 이끌어냅니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Sangho Lee</span>
</div>

</div>

<hr />

<h2 id="-github-trending"><i data-lucide="star"></i> GitHub Trending</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/Nutlope/hallmark/main/site/OG-hallmark.png" alt="Nutlope/hallmark" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/Nutlope/hallmark" target="_blank">Nutlope/hallmark</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#AI Coding</span> 
</div>

  <p>이 프로젝트는 Claude Code, Cursor, Codex와 같은 AI 코드 생성 도우미의 결과물 품질을 향상시키기 위한 디자인 스킬입니다. AI가 생성하는 불필요하거나 질 낮은 코드를 방지하여 더 깔끔하고 효율적인 코드를 작성하도록 돕습니다.</p>
  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 2244 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/TauricResearch/TradingAgents/main/assets/schema.png" alt="TauricResearch/TradingAgents" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/TauricResearch/TradingAgents" target="_blank">TauricResearch/TradingAgents</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Multi-Agent</span> 
</div>

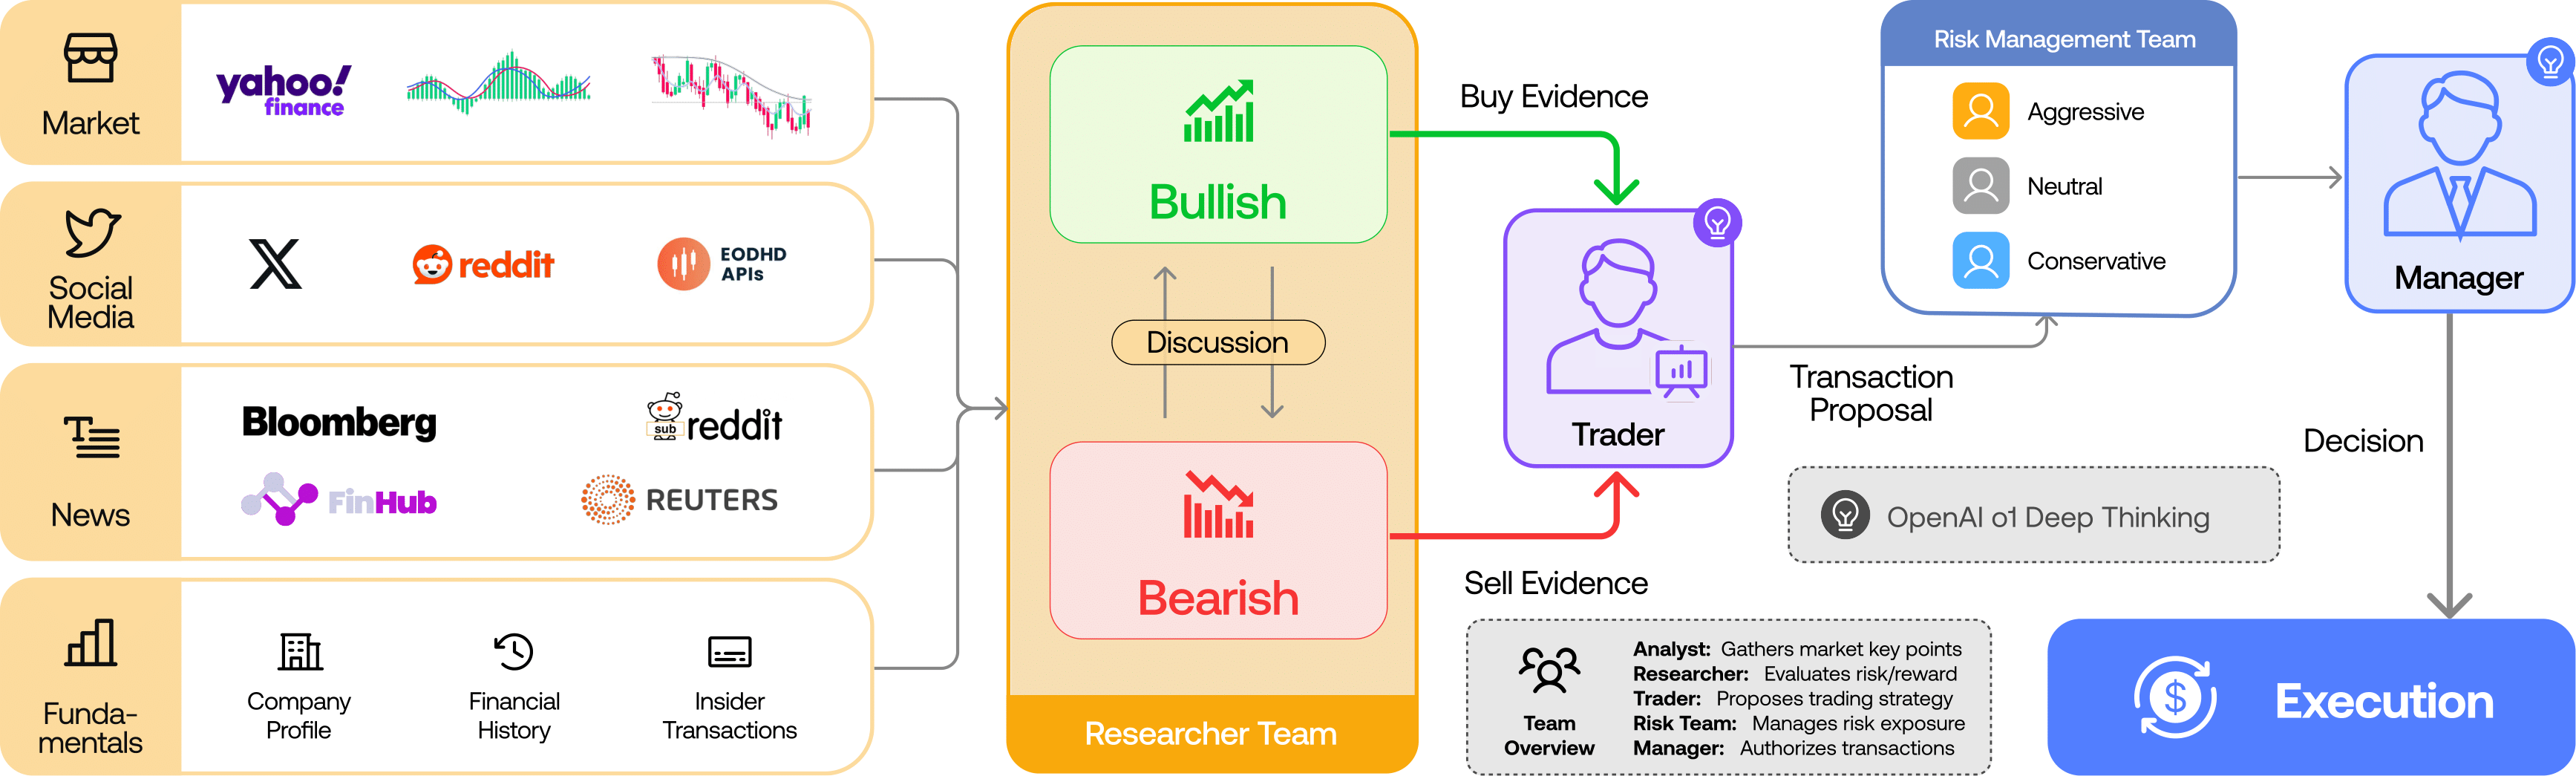
  <p>TradingAgents는 여러 LLM 에이전트를 활용하는 금융 트레이딩 프레임워크입니다. 다수의 AI 에이전트가 협력하여 복잡한 금융 시장 데이터를 분석하고 트레이딩 전략을 수행하도록 설계되었습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1395 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/JetBrains/thinkrail" alt="JetBrains/thinkrail" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/JetBrains/thinkrail" target="_blank">JetBrains/thinkrail</a></h3>

  <p>JetBrains가 개발한 thinkrail은 사용자의 작업 방식에 맞춰 스스로를 최적화하는 경량 통합 개발 환경(IDE)입니다. 이 IDE는 개발자 개인의 스타일에 맞게 커스터마이징되어 최적의 코딩 환경을 제공하는 것을 목표로 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1173 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/makecindy/cindy" alt="makecindy/cindy" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/makecindy/cindy" target="_blank">makecindy/cindy</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>cindy는 별도의 복잡한 설정 없이 바로 사용할 수 있는 오픈소스 AI 에이전트입니다. 사용자가 생각하는 작업을 곧바로 실행에 옮길 수 있도록 설계된 범용 인공지능 도구입니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1296 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/affaan-m/ECC/main/assets/hero.png" alt="affaan-m/ECC" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/affaan-m/ECC" target="_blank">affaan-m/ECC</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#AI Coding</span> 
</div>

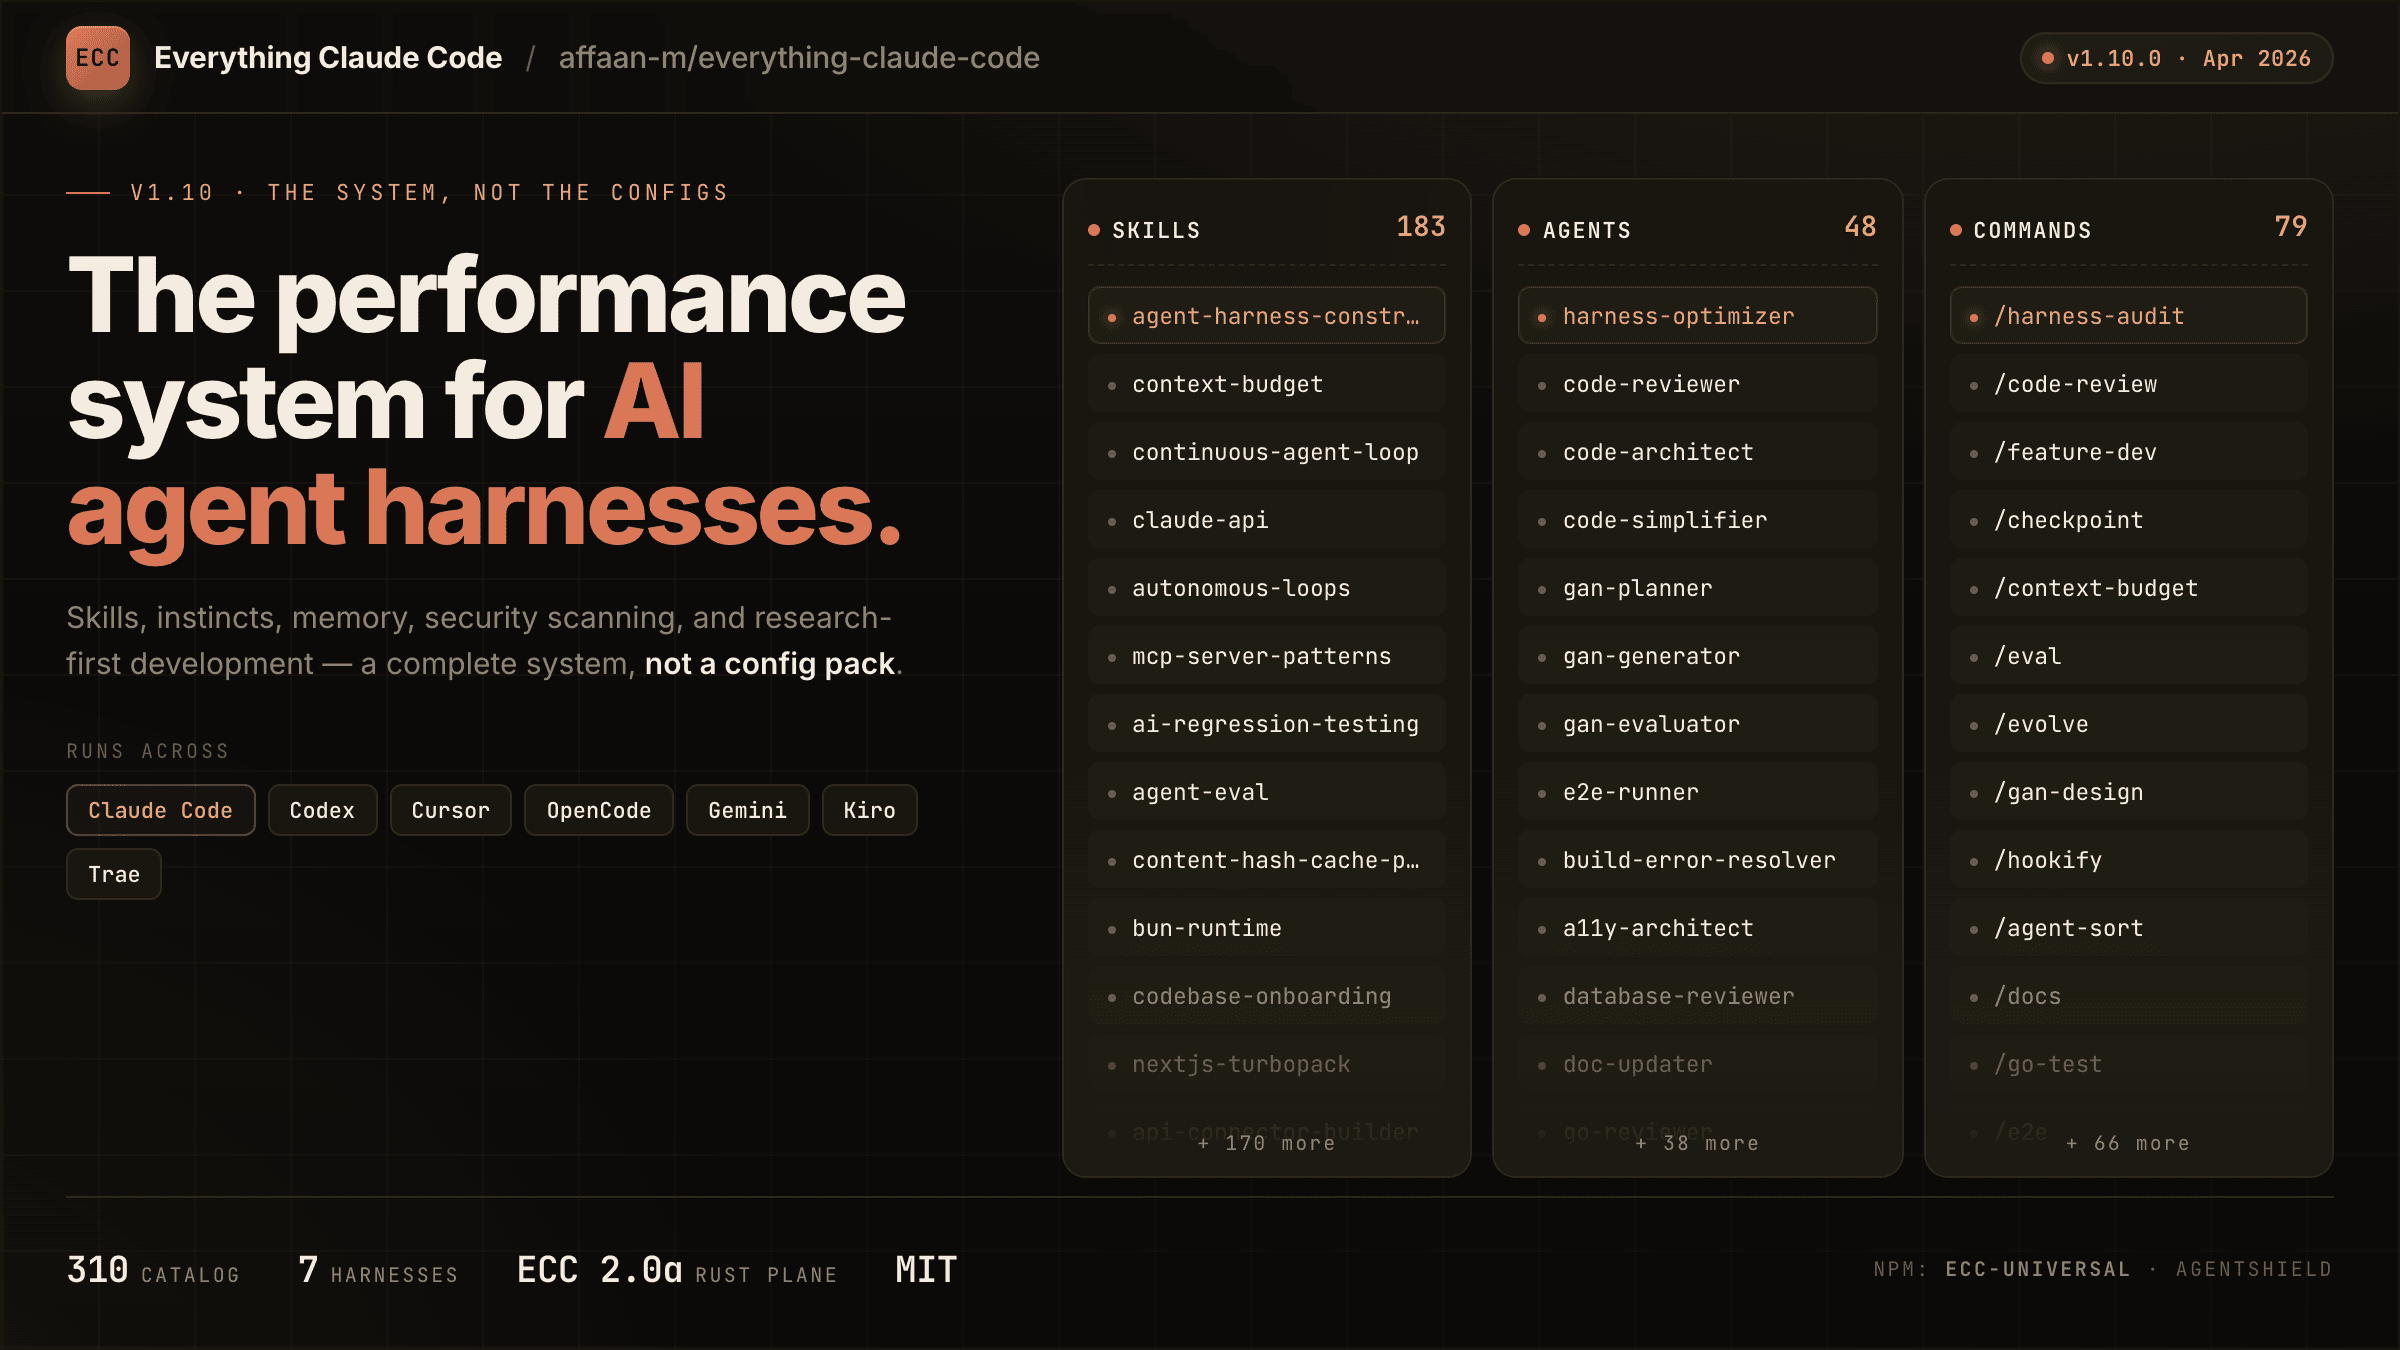
  <p>ECC는 AI 에이전트의 성능을 최적화하는 시스템입니다. Claude Code, Codex와 같은 코드 생성 AI의 기술, 메모리, 보안 등을 강화하여 전반적인 능력을 향상시키는 것을 목표로 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 896 today</span> 

</div>

</div>

<hr />

<h2 id="-오늘의-키워드"><i data-lucide="bar-chart-3"></i> 오늘의 키워드</h2>

<div class="keywords">
<code>Agent</code> <code>Eval</code> <code>Prompt</code> <code>Reasoning</code> <code>Grounding</code> <code>LLM</code> <code>Cursor</code> <code>AI Agent</code> <code>Claude</code> 
</div>]]></content><author><name>joyuno</name></author><category term="AI" /><category term="Tech" /><category term="AI" /><category term="LLM" /><category term="트렌드" /><category term="기술블로그" /><summary type="html"><![CDATA[arXiv 논문]]></summary></entry><entry><title type="html">cindy — 오픈소스, 개방형 AI 에이전트의 즉각적 활용</title><link href="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/26/ai-tech-digest.html" rel="alternate" type="text/html" title="cindy — 오픈소스, 개방형 AI 에이전트의 즉각적 활용" /><published>2026-10-26T00:00:00+09:00</published><updated>2026-10-26T00:00:00+09:00</updated><id>https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/26/ai-tech-digest</id><content type="html" xml:base="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/26/ai-tech-digest.html"><![CDATA[<h2 id="-arxiv-논문"><i data-lucide="book-open"></i> arXiv 논문</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.31329v1/data_engine.png" alt="WeVisOne-VL: Unified Visual Perception from Objects to Pixels" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.31329" target="_blank">WeVisOne-VL: Unified Visual Perception from Objects to Pixels</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#VLM</span> 
</div>

  <p>기존 비전-언어 모델의 세밀한 시각 인식 능력 한계를 극복하기 위한 WeVisOne-VL 모델을 소개합니다. 이 모델은 객체 수준부터 픽셀 수준까지의 인식을 통합하여, 사용자가 지정하는 다양한 정밀도(점, 박스, 마스크 등)로 객체 탐지, 분할, OCR 등 여러 시각적 작업을 수행할 수 있습니다. 구조화된 다음 토큰 예측 방식을 통해 이러한 통합적 인식을 가능하게 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 243</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.24738v1/teaser.png" alt="Editing Images into Reusable Layers via Compositional Edit-Prior Distillation" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.24738" target="_blank">Editing Images into Reusable Layers via Compositional Edit-Prior Distillation</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="wrench"></i> 학습/최적화</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Distillation</span> 
</div>

  <p>LayerEditor는 지시에 따라 이미지를 편집하면서 동시에 재사용 가능한 RGBA 레이어를 생성하는 새로운 통합 프레임워크입니다. 기존 편집 도구들이 단일 이미지로 결과를 출력하여 부분 수정이나 재사용이 어려웠던 문제를 해결하고, 사용자가 각 레이어를 독립적으로 제어하며 정교한 편집을 할 수 있도록 지원합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 184</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.30926v1/teaser_task.png" alt="Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.30926" target="_blank">Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Transformer</span> <span class="sub-tag">#Diffusion</span> 
</div>

  <p>영화 같은 고품질 영상 생성 시 캐릭터, 장면, 카메라 등을 세밀하게 제어하기 위한 새로운 기법을 제안합니다. 이 연구는 멀티모달 대규모 언어 모델(MLLM)이 가진 잠재적 표현을 영상 생성 모델이 효과적으로 활용하도록 만들어, 적은 입력 정보만으로도 요소별 제어가 가능한 영상을 생성하는 것을 목표로 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 174</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.30181v1/logo.png" alt="Deep Search in Real-World Web Environments" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.30181" target="_blank">Deep Search in Real-World Web Environments</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Eval</span> 
</div>

  <p>기존 딥 서치 에이전트들이 실제 웹 환경에서 복잡한 연구를 수행하는 능력이 부족하다는 문제점을 지적합니다. 이 연구는 정적인 환경이 아닌, 다양한 형식과 상호작용이 존재하는 실제 웹에서 에이전트가 자율적으로 정보를 검색하고 통합하는 능력을 평가하고 개선하기 위한 새로운 접근법을 제시합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 164</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.30949v1/my_benchmark_report_inter_gradient.png" alt="IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.30949" target="_blank">IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#MoE</span> 
</div>

  <p>IQuest-Q1은 명령어 라인 인터페이스(CLI) 시스템을 위한 새로운 에이전트 기반 파운데이션 모델입니다. 3200억 개의 파라미터를 가진 전문가 혼합(MoE) 희소 모델로, 안정적인 사전 학습, 세분화된 중간 학습, 특화된 미세 조정의 3단계 과정을 통해 개발되었습니다. 이 모델은 복잡한 CLI 작업을 자율적으로 수행하는 에이전트의 핵심 역량을 발전시키는 것을 목표로 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 99</span> 


</div>

</div>

<hr />

<h2 id="-hugging-face-blog"><i data-lucide="cpu"></i> Hugging Face Blog</h2>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.30926" target="_blank">Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Transformer</span> <span class="sub-tag">#Diffusion</span> 
</div>

  <p>영화 같은 비디오를 생성하려면 캐릭터, 장면, 카메라 등 다양한 요소를 정교하게 제어해야 합니다. 이 연구는 멀티모달 대규모 언어 모델(MLLM)의 잠재 표현을 비디오 생성 모델이 효과적으로 활용하도록 만드는 ‘요소 인식 예측 학습’ 기법을 제안하여, 제한된 정보만으로도 고품질의 시네마틱 비디오를 만들 수 있게 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Songlin Yang, Zhe Wang, Xiaotong Zhao</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.31574" target="_blank">Rethinking Sequence Compression with Test-time Regression</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <p>언어 모델의 효율성을 높이기 위한 핵심 과제인 시퀀스 압축 성능을 개선하기 위해 새로운 접근법을 제시합니다. 이 연구는 기존의 풀링 방식 대신, 입력 토큰을 회귀 문제로 정의하고 그 계수를 압축된 표현으로 사용하는 ‘테스트-타임 회귀’ 기법을 제안하여 정보 손실을 최소화합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Sihan Yang, Jie Huang, Hanxuan Li</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.30882" target="_blank">Inherited, Not Invented: Tracing the Provenance of Wait in Reasoning Models</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Reasoning Model</span> 
</div>

  <p>추론 모델이 생각할 시간을 벌기 위해 사용하는 <code class="language-plaintext highlighter-rouge">{wait}</code> 같은 단어는 강화학습(RL)이 발명한 것이 아니라는 주장을 제기합니다. 이 연구는 모델의 학습 이력을 추적하여, 이러한 기능이 강화학습을 통해 새로 학습된 것이 아니라 사전 학습 데이터로부터 이미 물려받은 속성임을 밝혀냈습니다. 이는 모델의 특정 능력이 RL의 발견이 아닌 데이터 유산일 수 있음을 시사합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Zhizhuo Kou, Sizai Hou, Long Chen</span>
</div>

</div>

<hr />

<h2 id="-github-trending"><i data-lucide="star"></i> GitHub Trending</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/makecindy/cindy" alt="makecindy/cindy" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/makecindy/cindy" target="_blank">makecindy/cindy</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>cindy는 복잡한 설정 없이 바로 사용할 수 있는 오픈소스 AI 에이전트 프로젝트입니다. 사용자가 생각하는 작업을 곧바로 실행에 옮기는 것을 목표로 개발되었습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 675 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/Nutlope/hallmark/main/site/OG-hallmark.png" alt="Nutlope/hallmark" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/Nutlope/hallmark" target="_blank">Nutlope/hallmark</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#AI Coding</span> 
</div>

  <p>hallmark는 Claude나 Cursor 같은 AI 코딩 도우미가 생성하는 코드의 품질 저하를 방지하기 위한 디자인 스킬셋입니다. AI가 만들어내는 조잡하고 일관성 없는 결과물을 개선하여 더 나은 디자인의 코드를 작성하도록 돕습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1317 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/pbakaus/impeccable" alt="pbakaus/impeccable" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/pbakaus/impeccable" target="_blank">pbakaus/impeccable</a></h3>

  <p>impeccable은 AI 시스템이 디자인 관련 작업을 더 잘 수행하도록 돕는 일종의 디자인 언어입니다. 이 프로젝트를 활용하면 AI 기반 애플리케이션의 디자인 역량을 강화하고 보다 정교한 결과물을 생성할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1092 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/TauricResearch/TradingAgents/main/assets/schema.png" alt="TauricResearch/TradingAgents" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/TauricResearch/TradingAgents" target="_blank">TauricResearch/TradingAgents</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Multi-Agent</span> 
</div>

  <p>TradingAgents는 여러 LLM 에이전트를 활용하는 금융 트레이딩 프레임워크입니다. 다수의 자율적인 AI 에이전트들이 협력하여 금융 시장 데이터를 분석하고 트레이딩 전략을 수행하도록 설계되었습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 381 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/Renhuai123/ziwei-doushu/main/docs/update-20261015.png" alt="Renhuai123/ziwei-doushu" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/Renhuai123/ziwei-doushu" target="_blank">Renhuai123/ziwei-doushu</a></h3>

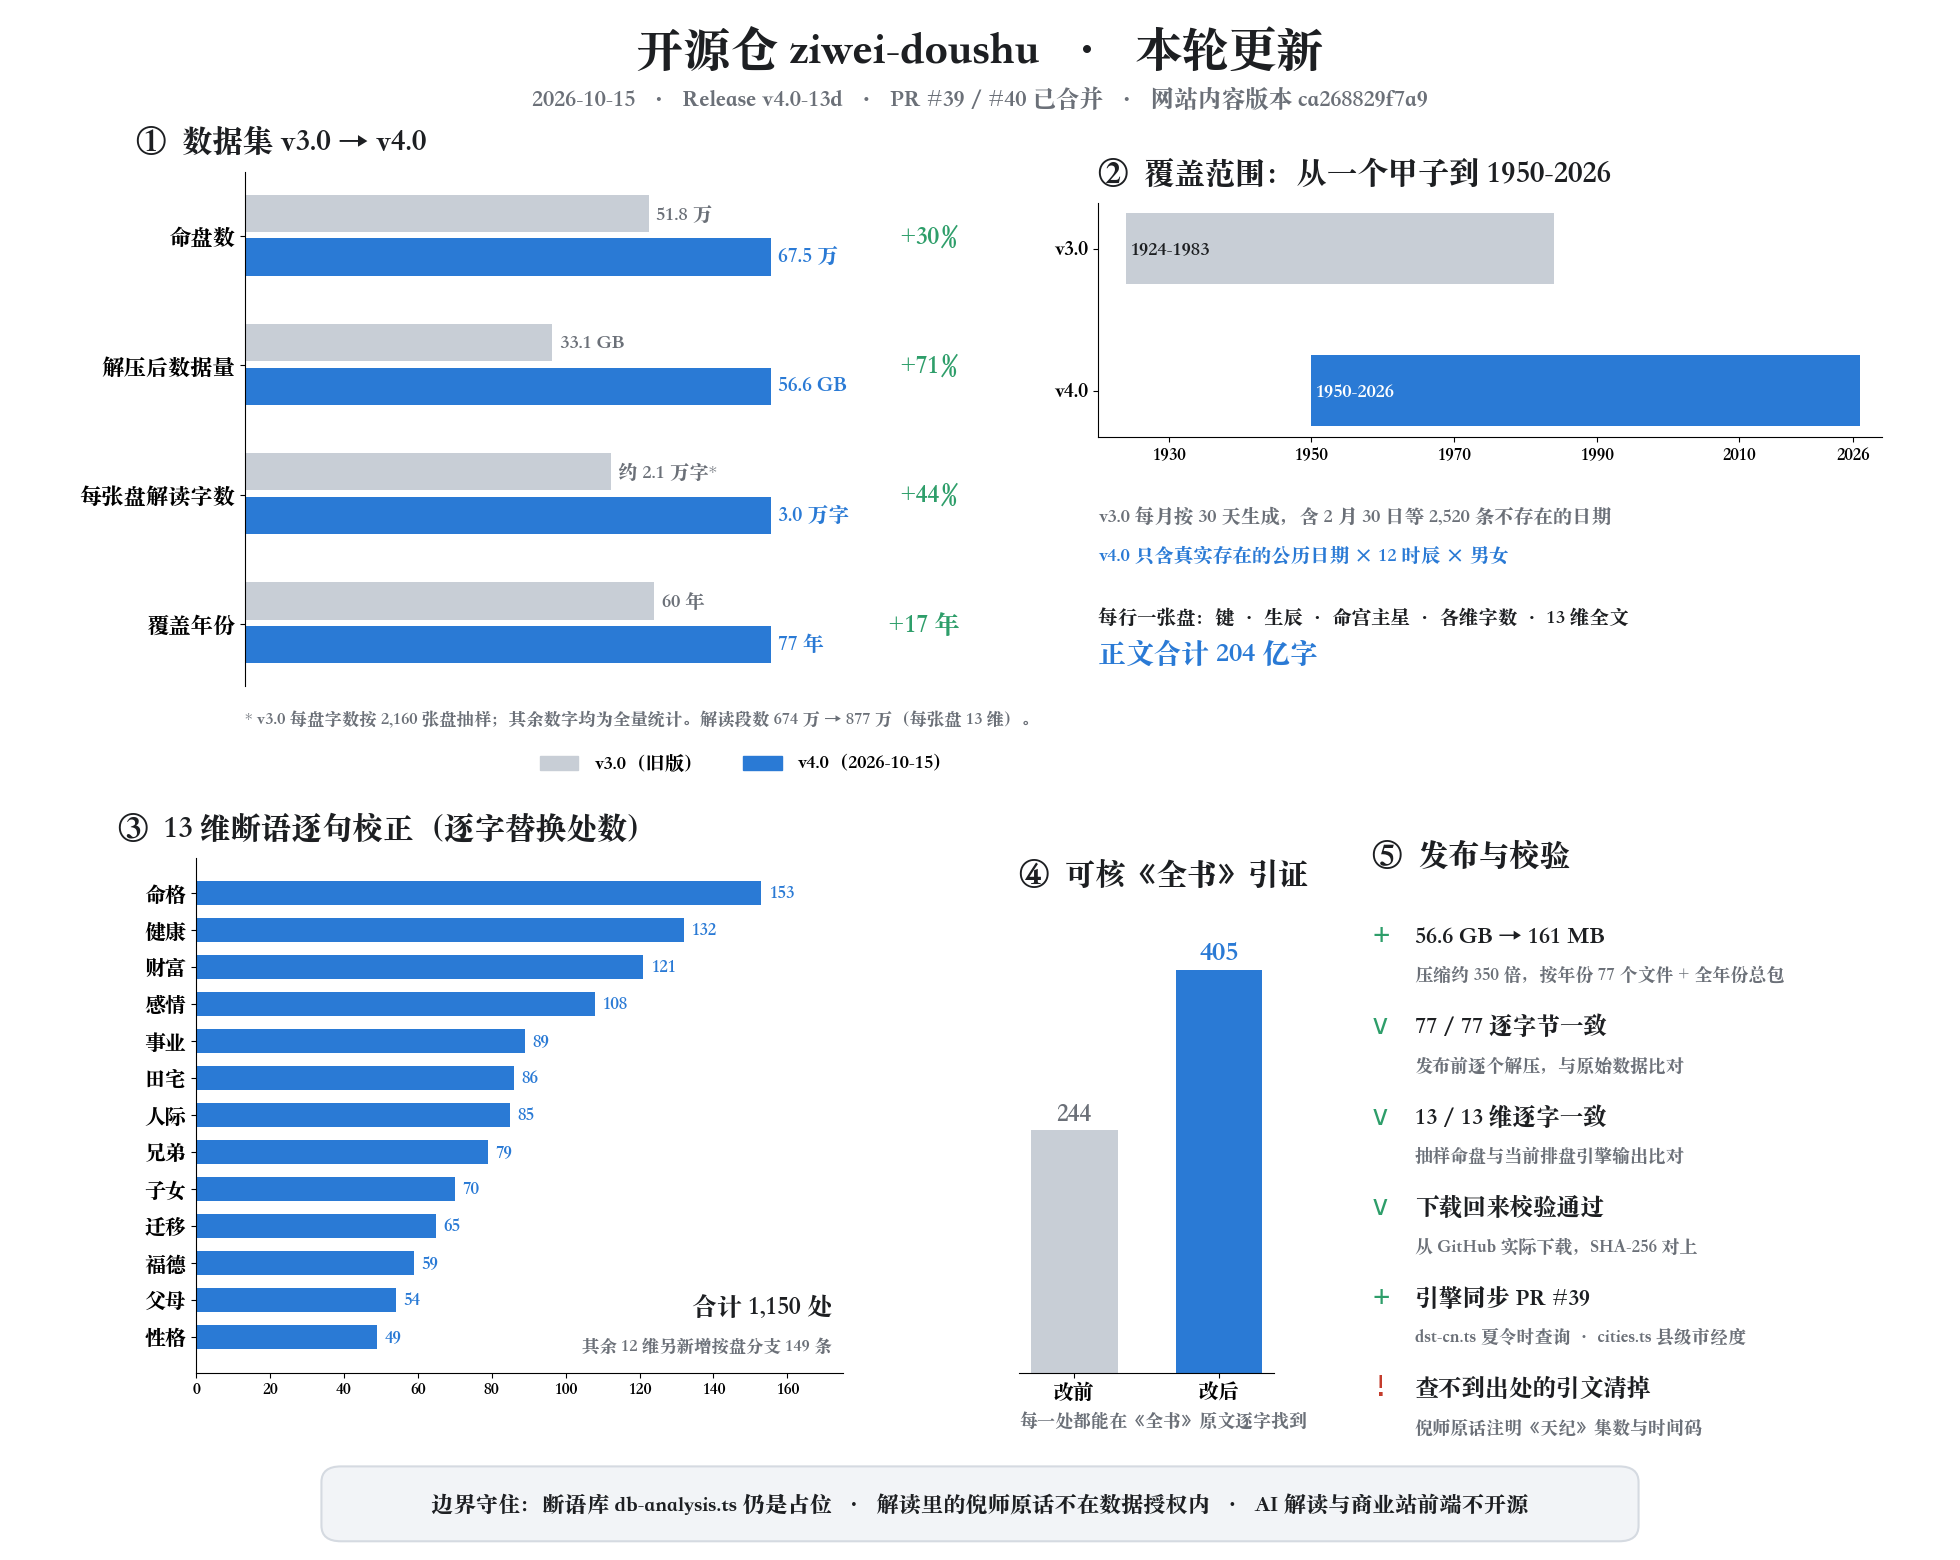
  <p>ziwei-doushu는 중국의 점성술인 자미두수 명반을 생성하는 오픈소스 엔진입니다. 특정 학파의 이론을 기반으로 완전한 명반 계산 알고리즘과 관련 지식 데이터베이스를 포함하고 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 199 today</span> 

</div>

</div>

<hr />

<h2 id="-ai-weekly"><i data-lucide="newspaper"></i> AI Weekly</h2>

<div class="digest-item">

  <h3><a href="https://aiweekly.co/issues/big-tech-reports-ai-spending-wednesday-as-coreweave-debt" target="_blank">AI Weekly Issue #541: Big Tech reports AI spending Wednesday as CoreWeave debt hits distress</a></h3>

  <p>이번 주 마이크로소프트, 알파벳 등 빅테크 기업들의 실적 발표를 앞두고, 시장은 막대한 AI 투자가 실제 수익으로 이어지고 있는지 예의주시하고 있습니다. 특히 AI 인프라 공급업체인 코어위브(CoreWeave)의 부도 위험 비용이 급증하면서, AI 산업의 재정 건전성에 대한 신용 시장의 우려도 함께 커지고 있습니다.</p>

  <div class="item-meta">


</div>

</div>

<hr />

<h2 id="-오늘의-키워드"><i data-lucide="bar-chart-3"></i> 오늘의 키워드</h2>

<div class="keywords">
<code>Vision</code> <code>Distillation</code> <code>LLM</code> <code>Inference</code> <code>Retrieval</code> <code>Agent</code> <code>Eval</code> <code>MoE</code> <code>Multimodal</code> <code>Reasoning</code> 
</div>]]></content><author><name>joyuno</name></author><category term="AI" /><category term="Tech" /><category term="AI" /><category term="LLM" /><category term="트렌드" /><category term="기술블로그" /><summary type="html"><![CDATA[arXiv 논문]]></summary></entry><entry><title type="html">WeVisOne-VL — 객체부터 픽셀까지 통합 시각 인지 VLM</title><link href="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/25/ai-tech-digest.html" rel="alternate" type="text/html" title="WeVisOne-VL — 객체부터 픽셀까지 통합 시각 인지 VLM" /><published>2026-10-25T00:00:00+09:00</published><updated>2026-10-25T00:00:00+09:00</updated><id>https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/25/ai-tech-digest</id><content type="html" xml:base="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/25/ai-tech-digest.html"><![CDATA[<h2 id="-arxiv-논문"><i data-lucide="book-open"></i> arXiv 논문</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.31329v1/data_engine.png" alt="WeVisOne-VL: Unified Visual Perception from Objects to Pixels" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.31329" target="_blank">WeVisOne-VL: Unified Visual Perception from Objects to Pixels</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#VLM</span> 
</div>

  <p>기존 시각 언어 모델의 한계인 세밀한 시각 인지 능력을 개선한 WeVisOne-VL 모델을 소개합니다. 이 모델은 객체 수준부터 픽셀 수준까지의 인식을 통합하여, 사용자가 원하는 어떤 세분화된 단위로도 객체 탐지, 분할, OCR 등 다양한 시각 작업을 수행할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 238</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.24738v1/teaser.png" alt="Editing Images into Reusable Layers via Compositional Edit-Prior Distillation" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.24738" target="_blank">Editing Images into Reusable Layers via Compositional Edit-Prior Distillation</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="wrench"></i> 학습/최적화</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Distillation</span> 
</div>

  <p>LayerEditor는 지시에 따라 이미지를 편집하면서 동시에 재사용 가능한 RGBA 레이어를 생성하는 새로운 통합 프레임워크입니다. 기존 편집 모델이 결과물을 단일 이미지로 만들어 재사용이 어려웠던 문제를 해결하고, 특정 영역만 정밀하게 수정하거나 여러 요소를 독립적으로 제어할 수 있게 해줍니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 181</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.30926v1/teaser_task.png" alt="Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.30926" target="_blank">Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Transformer</span> <span class="sub-tag">#Diffusion</span> 
</div>

  <p>영화 같은 고품질 영상 생성 시 캐릭터, 장면, 카메라 등을 세밀하게 제어하기 위해 멀티모달 대규모 언어 모델(MLLM)의 잠재 표현을 효과적으로 활용하는 새로운 방법을 제안합니다. 이 기술은 영상 생성 모델이 MLLM의 유용한 정보를 무시하던 문제를 해결하고, 적은 입력만으로도 시간적 흐름을 추론하며 다양한 요소를 독립적으로 제어할 수 있도록 돕습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 171</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.30181v1/logo.png" alt="Deep Search in Real-World Web Environments" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.30181" target="_blank">Deep Search in Real-World Web Environments</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Eval</span> 
</div>

  <p>기존 딥 서치 에이전트들이 통제된 환경에서만 평가되던 한계를 넘어, 실제 웹 환경에서 복잡한 리서치를 수행하는 능력을 평가하고 개선하는 연구를 소개합니다. 이 연구는 정보가 다양한 형식으로 흩어져 있고 복잡한 상호작용이 필요한 실제 웹에서 에이전트가 스스로 정보를 검색, 접근, 통합하는 종단간 연구 능력을 측정하는 새로운 기준을 제시합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 160</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.30949v1/my_benchmark_report_inter_gradient.png" alt="IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.30949" target="_blank">IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#MoE</span> 
</div>

  <p>IQuest-Q1은 명령어 기반 인터페이스(CLI) 시스템을 위한 새로운 에이전트 파운데이션 모델로, 3200억 개의 파라미터를 가진 전문가 혼합(MoE) 아키텍처를 사용합니다. 이 모델은 안정적인 사전 학습, 코딩 데이터 비중을 높이는 커리큘럼, 다양한 도메인에 걸친 미세 조정 등 3단계의 체계적인 개발 과정을 통해 복잡한 CLI 작업을 수행하는 능력을 고도화했습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 91</span> 


</div>

</div>

<hr />

<h2 id="-hugging-face-blog"><i data-lucide="cpu"></i> Hugging Face Blog</h2>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.30926" target="_blank">Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Transformer</span> <span class="sub-tag">#Diffusion</span> 
</div>

  <p>시네마틱 영상 생성은 캐릭터나 카메라 등을 세밀하게 제어해야 하지만, 기존 MLLM의 표현력은 영상 생성 모델에 제대로 활용되지 못하는 문제가 있습니다. 이 연구는 MLLM의 잠재 표현(latent)이 영상 생성 과정에 실질적인 영향을 미치도록 하는 ‘요소 인식 예측 학습’ 기법을 제안합니다. 이를 통해 제한된 입력만으로도 다양한 요소를 제어하며 고품질의 시네마틱 영상을 생성할 수 있게 됩니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Songlin Yang, Zhe Wang, Xiaotong Zhao</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.31574" target="_blank">Rethinking Sequence Compression with Test-time Regression</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <p>효율적인 언어 및 멀티모달 모델에서 시퀀스 압축은 중요한 병목 현상이지만, 기존 방식들은 성능이 부족했습니다. 이 연구는 시퀀스 압축 문제를 ‘테스트 시점 회귀(test-time regression)’라는 새로운 관점으로 접근하여 해결책을 제시합니다. 입력 토큰을 회귀 문제로 정의하고, 이 문제를 푸는 과정에서 얻어지는 계수들을 압축된 표현으로 사용함으로써 기존 방식의 한계를 극복합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Sihan Yang, Jie Huang, Hanxuan Li</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.30882" target="_blank">Inherited, Not Invented: Tracing the Provenance of Wait in Reasoning Models</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Reasoning Model</span> 
</div>

  <p>추론 모델이 생각할 시간을 벌기 위해 사용하는 <code class="language-plaintext highlighter-rouge">{wait}</code> 같은 단어는 강화학습(RL)을 통해 학습된 능력으로 알려져 왔습니다. 하지만 이 연구는 해당 능력이 강화학습으로 발명된 것이 아니라, 초기 학습 데이터로부터 물려받은 것임을 밝혀냈습니다. 오픈 모델의 학습 이력을 추적한 결과, <code class="language-plaintext highlighter-rouge">{wait}</code>의 사용 패턴은 강화학습이 아닌 사전 훈련 데이터에서 비롯되었음을 증명합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Zhizhuo Kou, Sizai Hou, Long Chen</span>
</div>

</div>

<hr />

<h2 id="-github-trending"><i data-lucide="star"></i> GitHub Trending</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/NVIDIA/OpenShell/main/docs/brand/assets/openshell-banner-light.png" alt="NVIDIA/OpenShell" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/NVIDIA/OpenShell" target="_blank">NVIDIA/OpenShell</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>NVIDIA가 공개한 OpenShell은 자율 AI 에이전트를 위한 안전하고 프라이빗한 런타임 환경입니다. 이를 통해 개발자들은 보안과 개인정보를 보호하면서 AI 에이전트를 실행하고 관리할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 896 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/aws/agent-toolkit-for-aws" alt="aws/agent-toolkit-for-aws" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/aws/agent-toolkit-for-aws" target="_blank">aws/agent-toolkit-for-aws</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#MCP</span> 
</div>

  <p>AWS에서 공식적으로 지원하는 AI 에이전트 개발용 툴킷입니다. 이 툴킷은 AWS 기반으로 AI 에이전트를 구축하는 데 필요한 서버, 스킬, 플러그인 등을 제공하여 개발을 용이하게 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 13 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/Nutlope/hallmark/main/site/OG-hallmark.png" alt="Nutlope/hallmark" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/Nutlope/hallmark" target="_blank">Nutlope/hallmark</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#AI Coding</span> 
</div>

  <p>Hallmark는 Claude Code, Cursor, Codex와 같은 AI 코드 생성 도우미를 위한 디자인 스킬입니다. 이 프로젝트는 AI가 생성하는 코드의 품질이 저하되는 것을 방지하고 더 정제된 결과물을 만들도록 돕습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 455 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/luongnv89/claude-howto" alt="luongnv89/claude-howto" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/luongnv89/claude-howto" target="_blank">luongnv89/claude-howto</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#AI Coding</span> 
</div>

  <p>Claude Code 사용법을 다루는 시각적이고 예제 중심적인 가이드입니다. 기본 개념부터 고급 에이전트 활용법까지 폭넓게 다루며, 바로 복사해서 사용할 수 있는 템플릿을 제공하여 실용성을 높였습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 392 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/pbakaus/impeccable" alt="pbakaus/impeccable" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/pbakaus/impeccable" target="_blank">pbakaus/impeccable</a></h3>

  <p>Impeccable은 AI 시스템이 디자인 작업을 더 잘 수행하도록 돕는 디자인 언어입니다. 이 프로젝트를 활용하면 AI가 생성하는 결과물의 시각적 품질과 일관성을 향상시킬 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 619 today</span> 

</div>

</div>

<hr />

<h2 id="-오늘의-키워드"><i data-lucide="bar-chart-3"></i> 오늘의 키워드</h2>

<div class="keywords">
<code>Vision</code> <code>Distillation</code> <code>LLM</code> <code>Inference</code> <code>Retrieval</code> <code>Agent</code> <code>Eval</code> <code>MoE</code> <code>Multimodal</code> <code>Reasoning</code> 
</div>]]></content><author><name>joyuno</name></author><category term="AI" /><category term="Tech" /><category term="AI" /><category term="LLM" /><category term="트렌드" /><category term="기술블로그" /><summary type="html"><![CDATA[arXiv 논문]]></summary></entry><entry><title type="html">NVIDIA OpenShell — 안전하고 프라이빗한 AI 에이전트 런타임</title><link href="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/24/ai-tech-digest.html" rel="alternate" type="text/html" title="NVIDIA OpenShell — 안전하고 프라이빗한 AI 에이전트 런타임" /><published>2026-10-24T00:00:00+09:00</published><updated>2026-10-24T00:00:00+09:00</updated><id>https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/24/ai-tech-digest</id><content type="html" xml:base="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/24/ai-tech-digest.html"><![CDATA[<h2 id="-arxiv-논문"><i data-lucide="book-open"></i> arXiv 논문</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.31329v1/data_engine.png" alt="WeVisOne-VL: Unified Visual Perception from Objects to Pixels" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.31329" target="_blank">WeVisOne-VL: Unified Visual Perception from Objects to Pixels</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#VLM</span> 
</div>

  <p>기존 비전-언어 모델(VLM)은 세밀한 시각적 인식 능력이 부족했습니다. WeVisOne-VL은 객체 수준부터 픽셀 수준까지의 인식을 통합하여 이 문제를 해결하는 강력한 VLM입니다. 이 모델은 구조화된 다음 토큰 예측 방식을 통해 객체 탐지, 분할, OCR 등 다양한 시각적 작업을 지원하며, 사용자가 원하는 어떤 세분화된 수준에서도 정확한 위치 파악을 가능하게 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 222</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.30926v1/teaser_task.png" alt="Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.30926" target="_blank">Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Transformer</span> <span class="sub-tag">#Diffusion</span> 
</div>

  <p>영화 같은 고품질 영상을 생성하려면 적은 입력 정보로 시간적 흐름을 추론하고 캐릭터, 장면, 카메라 등 여러 요소를 정교하게 제어해야 합니다. 이 연구는 멀티모달 대규모 언어 모델(MLLM)의 잠재 표현을 비디오 생성에 효과적으로 활용하는 ‘요소 인식 예측 학습’ 기법을 제안합니다. 이를 통해 비디오 생성 모델이 MLLM의 깊은 이해도를 바탕으로 다양한 요소를 분리하여 제어하며 고품질 영상을 만들 수 있도록 돕습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 164</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.30181v1/logo.png" alt="Deep Search in Real-World Web Environments" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.30181" target="_blank">Deep Search in Real-World Web Environments</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Eval</span> 
</div>

  <p>기존의 딥 서치 에이전트들은 실제 웹 환경처럼 복잡하고 다양한 정보 소스를 다루는 능력에 대한 평가가 부족했습니다. 실제 웹에서는 에이전트가 자율적으로 정보를 검색하고 통합하는 복잡한 상호작용이 필요하기 때문입니다. 이 연구는 이러한 한계를 극복하기 위해, 에이전트가 실제 웹 환경에서 엔드투엔드로 연구를 수행하는 능력을 평가하는 새로운 방법을 제시합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 152</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.24738v1/teaser.png" alt="Editing Images into Reusable Layers via Compositional Edit-Prior Distillation" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.24738" target="_blank">Editing Images into Reusable Layers via Compositional Edit-Prior Distillation</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="wrench"></i> 학습/최적화</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Distillation</span> 
</div>

  <p>기존 이미지 편집 모델은 결과물을 단일 이미지로 출력하여 재사용이나 정교한 부분 수정이 어려웠습니다. 이 연구는 지시에 따라 이미지를 편집함과 동시에 재사용 가능한 RGBA 레이어를 생성하는 통합 프레임워크 ‘LayerEditor’를 제안합니다. 이를 통해 사용자는 특정 영역만 정밀하게 수정하고, 생성된 레이어를 다른 작업에 다시 활용하는 등 유연한 편집이 가능해집니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 74</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.30949v1/my_benchmark_report_inter_gradient.png" alt="IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.30949" target="_blank">IQuest-Q1: Advancing Foundation Capabilities for Agentic CLI Systems</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#MoE</span> 
</div>

  <p>IQuest-Q1은 명령어 기반 인터페이스(CLI) 시스템을 위한 새로운 에이전트 파운데이션 모델입니다. 이 모델은 3200억 개의 파라미터를 가진 희소 전문가 혼합(MoE) 구조를 특징으로 하며, 안정적인 사전 학습과 데이터 확장 등 3단계 개발 과정을 거쳤습니다. IQuest-Q1은 특히 코딩 데이터 비중을 높인 학습 전략을 통해 CLI 환경에서 복잡한 작업을 수행하는 에이전트의 핵심 역량을 발전시키는 것을 목표로 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 54</span> 


</div>

</div>

<hr />

<h2 id="-hugging-face-blog"><i data-lucide="cpu"></i> Hugging Face Blog</h2>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.30926" target="_blank">Making MLLM Latents Matter: Factor-Aware Predictive Learning for Cinematic Video Generation</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Transformer</span> <span class="sub-tag">#Diffusion</span> 
</div>

  <p>시네마틱 영상 생성은 제한된 입력으로 시간적 추론을 하고 캐릭터, 장면, 카메라 등 다양한 요소를 제어해야 하는 과제입니다. 이 연구는 멀티모달 대규모 언어 모델(MLLM)의 잠재 표현을 영상 확산 모델이 효과적으로 활용하도록 만드는 ‘요소 인식 예측 학습’ 기법을 제안하여, 각 요소를 정교하게 제어하는 고품질 영상 생성을 가능하게 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Songlin Yang, Zhe Wang, Xiaotong Zhao</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.31574" target="_blank">Rethinking Sequence Compression with Test-time Regression</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <p>효율적인 언어 및 멀티모달 모델에서 시퀀스 압축은 중요한 병목 지점이지만 기존 방식은 성능이 부족합니다. 이 논문은 ‘테스트 시점 회귀’라는 새로운 접근법을 제안하는데, 입력 토큰을 회귀 문제로 정의하고 그 계수를 압축된 표현으로 사용하여 기존 방식보다 뛰어난 성능을 보여줍니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Sihan Yang, Jie Huang, Hanxuan Li</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.30882" target="_blank">Inherited, Not Invented: Tracing the Provenance of Wait in Reasoning Models</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Reasoning Model</span> 
</div>

  <p>추론 모델이 답변 전 ‘{wait}’를 출력하며 재고하는 행동은 강화학습(RL)을 통해 학습된 것으로 알려져 왔습니다. 하지만 이 연구는 해당 행동이 강화학습의 발명이 아닌, 사전 학습 데이터로부터 물려받은 ‘유산’임을 밝혀냈으며, 모델의 학습 이력 추적을 통해 이를 증명합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Zhizhuo Kou, Sizai Hou, Long Chen</span>
</div>

</div>

<hr />

<h2 id="-토스-기술블로그"><i data-lucide="credit-card"></i> 토스 기술블로그</h2>

<div class="digest-item">

  <h3><a href="https://toss.tech/article/dataops-log-definition-skill" target="_blank">머릿속에 있던 로그 정의 기준을 모두의 AI 스킬로 만들기</a></h3>

  <p>토스는 개발자 개인의 암묵적인 지식에 의존하던 로그 정의 기준을 AI를 활용해 시스템화했습니다. 이 시스템은 도구가 규칙을 검사하고 AI가 초안을 제안하면 사람이 최종 확정하는 방식으로, 누구나 일관된 고품질의 로그를 손쉽게 작성할 수 있도록 지원합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> 토스</span>
</div>

</div>

<hr />

<h2 id="-github-trending"><i data-lucide="star"></i> GitHub Trending</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/anthropics/knowledge-work-plugins" alt="anthropics/knowledge-work-plugins" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/anthropics/knowledge-work-plugins" target="_blank">anthropics/knowledge-work-plugins</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <p>앤트로픽이 공개한 오픈소스 플러그인 저장소입니다. 이 플러그인들은 주로 지식 근로자들이 ‘클로드 코워크(Claude Cowork)’ 환경에서 생산성을 높일 수 있도록 설계되었습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 635 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/NVIDIA/OpenShell/main/docs/brand/assets/openshell-banner-light.png" alt="NVIDIA/OpenShell" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/NVIDIA/OpenShell" target="_blank">NVIDIA/OpenShell</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>엔비디아가 공개한 OpenShell은 자율 AI 에이전트를 위한 런타임 환경입니다. 이 프로젝트는 AI 에이전트가 안전하고 프라이빗한 공간에서 독립적으로 작동할 수 있도록 지원하는 데 중점을 둡니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1119 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/Renhuai123/ziwei-doushu/main/docs/update-20261015.png" alt="Renhuai123/ziwei-doushu" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/Renhuai123/ziwei-doushu" target="_blank">Renhuai123/ziwei-doushu</a></h3>

  <p>자미두수(紫微斗数)를 위한 오픈소스 운세 분석 엔진입니다. 특정 학파의 체계를 기반으로 완전한 풀이 알고리즘, 지식 베이스, 고서 원문 데이터까지 포함하고 있어 관련 시스템 구축에 활용할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 546 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/SnailSploit/Claude-Red/main/assets/banner.png" alt="SnailSploit/Claude-Red" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/SnailSploit/Claude-Red" target="_blank">SnailSploit/Claude-Red</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <p>Claude-Red는 앤트로픽의 클로드(Claude) 모델을 위해 설계된 공격적 보안 기술 라이브러리입니다. SQL 인젝션부터 익스플로잇 개발까지 특정 공격에 대한 전문가 수준의 방법론을 클로드에게 학습시키는 구조화된 파일들로 구성되어 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 226 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/anthropics/knowledge-work-plugins" alt="anthropics/knowledge-work-plugins" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/anthropics/knowledge-work-plugins" target="_blank">anthropics/knowledge-work-plugins</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <p>앤트로픽이 공개한 오픈소스 플러그인 저장소입니다. 이 플러그인들은 주로 지식 근로자들이 ‘클로드 코워크(Claude Cowork)’ 환경에서 생산성을 높일 수 있도록 설계되었습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 635 today</span> 

</div>

</div>

<hr />

<h2 id="-오늘의-키워드"><i data-lucide="bar-chart-3"></i> 오늘의 키워드</h2>

<div class="keywords">
<code>Vision</code> <code>LLM</code> <code>Inference</code> <code>Retrieval</code> <code>Agent</code> <code>Eval</code> <code>Distillation</code> <code>MoE</code> <code>Multimodal</code> <code>Reasoning</code> 
</div>]]></content><author><name>joyuno</name></author><category term="AI" /><category term="Tech" /><category term="AI" /><category term="LLM" /><category term="트렌드" /><category term="기술블로그" /><summary type="html"><![CDATA[arXiv 논문]]></summary></entry><entry><title type="html">Anthropic, Claude Cowork 지식 노동자용 플러그인 공개</title><link href="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/23/ai-tech-digest.html" rel="alternate" type="text/html" title="Anthropic, Claude Cowork 지식 노동자용 플러그인 공개" /><published>2026-10-23T00:00:00+09:00</published><updated>2026-10-23T00:00:00+09:00</updated><id>https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/23/ai-tech-digest</id><content type="html" xml:base="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/23/ai-tech-digest.html"><![CDATA[<h2 id="-arxiv-논문"><i data-lucide="book-open"></i> arXiv 논문</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.28402v1/01_overview.png" alt="StreamEval: Evaluating Interactive Streaming Video Generation Models" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.28402" target="_blank">StreamEval: Evaluating Interactive Streaming Video Generation Models</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Eval</span> 
</div>

  <p>스트리밍 비디오 생성 기술이 발전함에 따라 실시간 상호작용의 중요성이 커지고 있습니다. 이를 위해 본 연구는 아바타 대화, 월드 생성 등 5가지 작업을 포괄하는 통합 벤치마크 ‘StreamEval’을 제안하여, 점진적으로 주어지는 복합적인 요청에 대한 모델의 상호작용 능력을 평가합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 354</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.26659v3/spatialscout_camera_overview_v3_white.png" alt="SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.26659" target="_blank">SpatialScout: Can VLM Agents Actively Explore and Map 3D Scenes?</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="wrench"></i> 학습/최적화</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#VLM</span> <span class="sub-tag">#LoRA</span> <span class="sub-tag">#Eval</span> 
</div>

  <p>기존 공간 지능 평가 방식은 모델이 능동적인 탐색을 통해 3D 지도를 정확히 구축하는지 확인하기 어렵습니다. ‘SpatialScout’은 VLM(Vision-Language Model) 에이전트가 직접 3D 실내 공간을 탐색하며 객체 수준의 지도를 만드는 능력을 평가하는 새로운 벤치마크를 제시합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 129</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.29997v1/pipeline.png" alt="DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.29997" target="_blank">DONIC: Generalist Dexterous Bimanual Tracking Control from Human Demonstrations</a></h3>

  <p>기존 로봇 손 조작 연구는 주로 한 손에 국한되어, 실생활에 필수적인 양손 협응 동작을 다루지 못했습니다. 본 연구는 인간의 시연 데이터로부터 학습하여 다양한 물체와 작업을 아우르는 최초의 범용 양손 추적 제어 모델 ‘DONIC’을 제안합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 124</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.29989v1/chain.png" alt="Looking Ahead: Modeling Future Evolution in Autoregressive Video Generation" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.29989" target="_blank">Looking Ahead: Modeling Future Evolution in Autoregressive Video Generation</a></h3>

  <p>자기회귀 비디오 생성 모델은 단기적인 시각적 연속성에만 의존하여 장면의 장기적인 변화를 제대로 예측하지 못하는 경향이 있습니다. 이를 해결하기 위해, 현재 시점과 떨어진 미래의 비디오 덩어리를 예측하는 보조 목표 ‘FCP(Future Chunk Prediction)’를 도입하여 모델이 장면의 동적인 변화를 학습하도록 유도합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 116</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.11942v1/fig2_framework.png" alt="Right Screen, Wrong Transition: World Models as Verifiers for GUI Agents" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.11942" target="_blank">Right Screen, Wrong Transition: World Models as Verifiers for GUI Agents</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="target"></i> 신뢰성/안전</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#GUI Agent</span> 
</div>

  <p>GUI 에이전트의 안전성은 단순히 화면의 내용이 아니라, 특정 행동 후에 나타나는 화면의 ‘전환’ 과정이 올바른지에 달려있습니다. 본 연구는 월드 모델을 검증기로 활용하여, 에이전트의 행동으로 인해 발생한 화면 전환이 예상된 결과와 일치하는지 확인함으로써 잘못된 전환이나 공격을 탐지하는 새로운 방법을 제안합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 88</span> 


</div>

</div>

<hr />

<h2 id="-hugging-face-blog"><i data-lucide="cpu"></i> Hugging Face Blog</h2>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.30113" target="_blank">Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Eval</span> 
</div>

  <p>퀀트-아레나(Quant-Arena)는 LLM 에이전트의 정량적 트레이딩 연구 능력을 종합적으로 평가하는 새로운 벤치마크입니다. 기존 벤치마크와 달리 가설 수립부터 실제 데이터 기반 백테스팅까지 전체 연구 과정을 수행하여 실용적인 투자 전략을 도출하는지 검증하며, 이를 통해 연구 기간을 넘어선 실제 시장에서도 LLM이 생성한 전략이 유효한지 확인할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Houde Qian, Zheng Jiang, Wenyi Li</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.30120" target="_blank">ALPS: Visual State Encoders for World Models</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="target"></i> 신뢰성/안전</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Alignment</span> 
</div>

  <p>월드 모델의 시각적 표현 능력을 향상시키는 새로운 비주얼 인코더 ALPS를 제안합니다. 기존 인코더들이 물리적 상태 정보, 언어 정렬, 픽셀 재구성 중 일부 기능에만 특화된 반면, ALPS는 이 세 가지 핵심 기능을 단일 표현으로 통합하여 예측, 지시, 분석 등 다양한 작업을 효과적으로 지원합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Yanqing Liu, Letian Zhang, Chengzhi Liu</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.30108" target="_blank">Multimodal Embodied Agents: A Unified Capability-centric Perspective from Computer-Use to Robot-Use</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>멀티모달 기반 에이전트(MMEA)를 멀티모달 추론 능력과 물리적 행동을 결합하고, 그 결과로부터 학습하는 목표 지향적 시스템으로 새롭게 정의합니다. 이 연구는 기존 컴퓨터 환경의 에이전트가 로봇처럼 실제 물리적 세계와 상호작용할 때 어떤 변화가 필요하고 발생하는지에 대한 핵심적인 질문을 탐구합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Yanzhe Chen, Ziyi Yang, Jifeng Zhu</span>
</div>

</div>

<hr />

<h2 id="-github-trending"><i data-lucide="star"></i> GitHub Trending</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/anthropics/knowledge-work-plugins" alt="anthropics/knowledge-work-plugins" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/anthropics/knowledge-work-plugins" target="_blank">anthropics/knowledge-work-plugins</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <p>앤트로픽이 공개한 오픈소스 플러그인 저장소로, 주로 클로드 코워크(Claude Cowork) 환경에서 지식 노동자들의 생산성을 높이기 위해 설계되었습니다. 다양한 플러그인을 통해 업무 효율을 극대화할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 303 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/DietrichGebert/ponytail/main/assets/logo.png" alt="DietrichGebert/ponytail" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/DietrichGebert/ponytail" target="_blank">DietrichGebert/ponytail</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>AI 에이전트가 마치 ‘게으른 시니어 개발자’처럼 생각하게 만드는 프로젝트입니다. 불필요한 코드를 작성하지 않고 가장 효율적인 해결책을 찾도록 유도하여, “작성하지 않은 코드가 최고의 코드”라는 철학을 구현합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1948 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/Graphify-Labs/graphify/v8/docs/graphify-logo.png" alt="Graphify-Labs/graphify" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/Graphify-Labs/graphify" target="_blank">Graphify-Labs/graphify</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#AI Coding</span> 
</div>

  <p>코드베이스, 문서, SQL 스키마 등 다양한 소스를 쿼리 가능한 지식 그래프로 변환해주는 도구입니다. 벡터 DB 없이 로컬 파싱을 통해 코드의 구조와 관계를 명확하게 분석해주며, 클로드(Claude)나 제미나이(Gemini) 등에서 활용할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1408 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
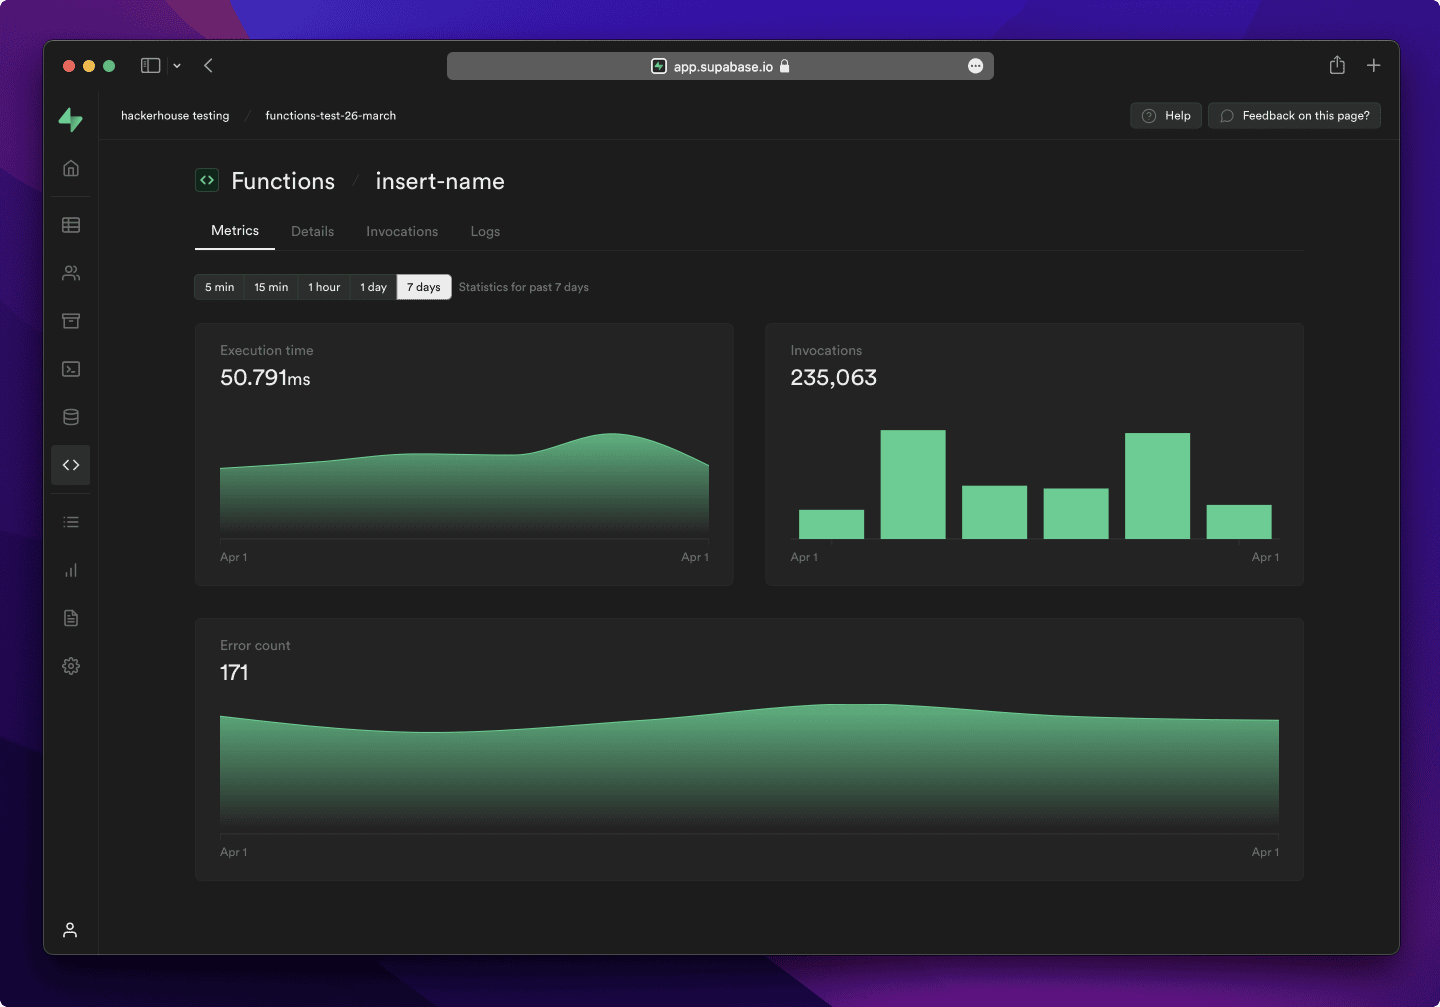
  <img src="https://raw.githubusercontent.com/supabase/supabase/master/apps/www/public/images/github/supabase-dashboard.png" alt="supabase/supabase" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/supabase/supabase" target="_blank">supabase/supabase</a></h3>

  <p>PostgreSQL 기반의 오픈소스 개발 플랫폼입니다. 웹, 모바일, AI 애플리케이션 구축에 필요한 전용 Postgres 데이터베이스와 백엔드 기능을 제공하여 개발 과정을 단순화하고 가속화합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 693 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/luongnv89/claude-howto" alt="luongnv89/claude-howto" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/luongnv89/claude-howto" target="_blank">luongnv89/claude-howto</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#AI Coding</span> 
</div>

  <p>클로드 코드(Claude Code) 사용법을 다루는 시각적이고 예제 중심적인 가이드입니다. 기본 개념부터 고급 에이전트 제작까지 다루며, 바로 복사해서 사용할 수 있는 템플릿을 제공하여 실용성을 높였습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 177 today</span> 

</div>

</div>

<hr />

<h2 id="-오늘의-키워드"><i data-lucide="bar-chart-3"></i> 오늘의 키워드</h2>

<div class="keywords">
<code>Multimodal</code> <code>Eval</code> <code>Vision</code> <code>LoRA</code> <code>Agent</code> <code>Safety</code> <code>LLM</code> <code>Benchmark</code> <code>Alignment</code> <code>Claude</code> 
</div>]]></content><author><name>joyuno</name></author><category term="AI" /><category term="Tech" /><category term="AI" /><category term="LLM" /><category term="트렌드" /><category term="기술블로그" /><summary type="html"><![CDATA[arXiv 논문]]></summary></entry><entry><title type="html">vllm — LLM 고성능 추론 및 서빙 엔진</title><link href="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/22/ai-tech-digest.html" rel="alternate" type="text/html" title="vllm — LLM 고성능 추론 및 서빙 엔진" /><published>2026-10-22T00:00:00+09:00</published><updated>2026-10-22T00:00:00+09:00</updated><id>https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/22/ai-tech-digest</id><content type="html" xml:base="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/22/ai-tech-digest.html"><![CDATA[<h2 id="-arxiv-논문"><i data-lucide="book-open"></i> arXiv 논문</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.27999v1/data_v8.png" alt="Matrix-Game 4.0: Harnessing Video Models for Real-Time Playable Game Worlds" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.27999" target="_blank">Matrix-Game 4.0: Harnessing Video Models for Real-Time Playable Game Worlds</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Coding Agent</span> 
</div>

  <p>단순히 제어 가능한 비디오를 넘어 실시간으로 플레이할 수 있는 게임 세계를 구축하기 위한 새로운 접근법 Matrix-Game 4.0을 제안합니다. 이 시스템은 게임 규칙 실행과 시각적 생성을 분리하는 구조를 채택했으며, 가벼운 게임 엔진이 세계 상태를 관리하고 멀티모달 코딩 에이전트가 플레이어의 아이디어를 게임 내 행동으로 변환합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 181</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.26855v1/pipeline.png" alt="Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.26855" target="_blank">Ropedia W0: Scaling Loco-Manipulation World Models across Embodiments with Human Experience</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#World Model</span> 
</div>

  <p>다양한 형태의 로봇과 인간을 아우르는 최초의 자아 중심 이동-조작(loco-manipulation) 월드 파운데이션 모델 Ropedia W0를 제안합니다. 이 모델은 1만 시간 이상의 인간 경험 데이터와 3천 시간의 로봇 데이터를 통합 학습하여, 서로 다른 신체 구조를 가진 에이전트가 행동의 결과를 효과적으로 예측할 수 있도록 돕습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 177</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.27628v1/teaser.png" alt="PAR: Progress-Aligned Recurrence for Length Generalization in State Tracking" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.27628" target="_blank">PAR: Progress-Aligned Recurrence for Length Generalization in State Tracking</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <p>순차적인 상태 추적 문제에서 언어 모델이 더 긴 시퀀스를 처리할 수 있도록 일반화 성능을 높이는 새로운 기법 PAR(Progress-Aligned Recurrence)을 소개합니다. 이 방법은 모델의 반복적인 연산 각 단계(k번째)의 예측이 실제 k번의 연산 후 상태와 일치하도록 학습시키고 순환 상태의 스케일을 조정하여 안정적인 문제 해결을 가능하게 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 147</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.28354v1/teaser.png" alt="S-Agent 2.0: Spatial Reasoning with a General Coding Agent" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.28354" target="_blank">S-Agent 2.0: Spatial Reasoning with a General Coding Agent</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#VLM</span> <span class="sub-tag">#Coding Agent</span> 
</div>

  <p>3D 공간 추론 능력을 향상시키기 위한 에이전트 시스템 S-Agent 2.0은 기존 모델들이 3D 인식 도구로 올바른 증거를 수집하고도 정답을 찾지 못하는 문제를 해결합니다. 이 시스템은 범용 코딩 에이전트를 활용하여 도구에서 얻은 원시 데이터를 분석하고 추론함으로써, 복잡한 공간 관계 및 움직임에 대한 질문에 더 정확하게 답변할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 92</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.25078v1/whowhen-evolution-sketch.png" alt="CoEvo-RSI: When Harnesses Evolve, Which Models Should Follow?" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.25078" target="_blank">CoEvo-RSI: When Harnesses Evolve, Which Models Should Follow?</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>재귀적으로 자기 개선(RSI)하는 AI 에이전트에서 모델(두뇌)과 실행 프레임워크(몸체)가 함께 진화할 때 발생하는 ‘두뇌-몸체 불일치’ 문제를 탐구합니다. 이러한 불일치 문제를 해결하기 위해 CoEvo-RSI 프레임워크를 제안하며, 에이전트가 직접 어떤 모델과 프레임워크 조합이 가장 유망한지 판단하여 진화 방향을 결정하도록 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 59</span> 


</div>

</div>

<hr />

<h2 id="-hugging-face-blog"><i data-lucide="cpu"></i> Hugging Face Blog</h2>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.28630" target="_blank">SolarRenderer: Few-Step Generative Reference Rendering</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="wrench"></i> 학습/최적화</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Distillation</span> <span class="sub-tag">#Coding Agent</span> 
</div>

  <p>기존 렌더러는 게임 엔진 등에서 지정한 장면 구조를 사실적인 비디오로 변환할 때 특정 엔진에 종속되거나 많은 연산 비용이 드는 한계가 있었습니다. ‘SolarRenderer’는 이러한 문제를 해결하는 구조 조건부 비디오 렌더링 기술로, 주어진 구조를 충실히 따르면서도 적은 단계만으로 효율적인 고품질 비디오 생성을 목표로 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Guian Fang, Shengju Qian, Dongyue Lu</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.28632" target="_blank">Joints, Camera, Action! Co-Generating 3D Motion and Video for Arbitrary Rigs</a></h3>

  <p>기존 비디오 생성 모델은 사실적인 움직임을 픽셀로만 보여줄 뿐, 이를 3D 에셋에 적용할 수 있는 모션 데이터로 만들지는 못했습니다. 이 연구는 사용자가 제공하는 어떤 3D 캐릭터(rig)에 대해서도 비디오와 3D 모션을 동시에 생성하는 새로운 모델을 제시하여, 생성된 움직임을 3D 씬에서 직접 재현할 수 있게 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Noam Rotstein, Yoad Tewel, Chen Tessler</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.28601" target="_blank">Evolving Agent Interfaces</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>기존 AI 에이전트는 인간이 설계한 인터페이스의 한계 때문에 컴퓨터 작업을 비효율적으로 수행하는 경우가 많았습니다. 이 연구는 인터페이스 설계 자체를 에이전트의 핵심 역량으로 삼아야 한다고 주장하며, 스스로 더 나은 인터페이스를 개발하고 진화시켜 문제를 해결하는 ‘Agent S4’를 제안합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Saaket Agashe, Yuzhe Yang, Gonzalo Gonzalez-Pumariega</span>
</div>

</div>

<hr />

<h2 id="-github-trending"><i data-lucide="star"></i> GitHub Trending</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/vllm-project/vllm/main/docs/assets/logos/vllm-logo-text-light.png" alt="vllm-project/vllm" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/vllm-project/vllm" target="_blank">vllm-project/vllm</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <p>vLLM은 대규모 언어 모델(LLM)을 위한 추론 및 서빙 엔진입니다. 높은 처리량과 메모리 효율성을 특징으로 하여 LLM 기반 서비스를 더 빠르고 경제적으로 운영할 수 있도록 지원합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 441 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/stablyai/orca/main/resources/build/icon.png" alt="stablyai/orca" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/stablyai/orca" target="_blank">stablyai/orca</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Coding Agent</span> <span class="sub-tag">#AI Coding</span> 
</div>

  <p>Orca는 여러 AI 코딩 에이전트를 한곳에서 통합 관리하고 실행할 수 있는 플랫폼입니다. 사용자는 자신의 구독 계정을 이용해 Grok, Claude 등 다양한 에이전트를 데스크톱, 모바일 등 여러 환경에서 손쉽게 활용할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1541 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/headroomlabs-ai/headroom/main/HeadroomDemo-Fast.gif" alt="headroomlabs-ai/headroom" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/headroomlabs-ai/headroom" target="_blank">headroomlabs-ai/headroom</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#RAG</span> <span class="sub-tag">#Coding Agent</span> <span class="sub-tag">#MCP</span> 
</div>

  <p>Headroom은 LLM에 전달되는 데이터를 압축하여 토큰 사용량을 획기적으로 줄여주는 도구입니다. 로그, 파일, RAG 청크 등을 압축해 동일한 답변 품질을 유지하면서도 코딩 에이전트의 토큰을 20%, JSON 데이터는 최대 95%까지 절약합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 474 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/DietrichGebert/ponytail/main/assets/logo.png" alt="DietrichGebert/ponytail" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/DietrichGebert/ponytail" target="_blank">DietrichGebert/ponytail</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>Ponytail은 AI 에이전트가 마치 ‘게으른 시니어 개발자’처럼 가장 효율적인 해결책을 찾도록 유도하는 프로젝트입니다. 불필요한 코드를 작성하기보다 기존의 해결책을 재사용하거나 더 간단한 방법을 모색하여 ‘작성하지 않은 코드가 최고의 코드’라는 철학을 구현합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 2079 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/Comfy-Org/ComfyUI" alt="Comfy-Org/ComfyUI" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/Comfy-Org/ComfyUI" target="_blank">Comfy-Org/ComfyUI</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <p>ComfyUI는 그래프와 노드 기반의 인터페이스를 갖춘 강력한 디퓨전 모델용 GUI 및 백엔드 시스템입니다. 복잡한 이미지 생성 워크플로우를 직관적으로 설계할 수 있으며, 세계 최고 수준의 빠른 로컬 추론 속도를 자랑합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 939 today</span> 

</div>

</div>

<hr />

<h2 id="-오늘의-키워드"><i data-lucide="bar-chart-3"></i> 오늘의 키워드</h2>

<div class="keywords">
<code>Multimodal</code> <code>Agent</code> <code>Vision</code> <code>Reasoning</code> <code>Distillation</code> <code>LLM</code> <code>Inference</code> <code>Claude</code> <code>Claude Code</code> <code>RAG</code> 
</div>]]></content><author><name>joyuno</name></author><category term="AI" /><category term="Tech" /><category term="AI" /><category term="LLM" /><category term="트렌드" /><category term="기술블로그" /><summary type="html"><![CDATA[arXiv 논문]]></summary></entry><entry><title type="html">Orca — Grok Bot, Claude Code 활용 에이전트 플릿 관리 플랫폼</title><link href="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/21/ai-tech-digest.html" rel="alternate" type="text/html" title="Orca — Grok Bot, Claude Code 활용 에이전트 플릿 관리 플랫폼" /><published>2026-10-21T00:00:00+09:00</published><updated>2026-10-21T00:00:00+09:00</updated><id>https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/21/ai-tech-digest</id><content type="html" xml:base="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/21/ai-tech-digest.html"><![CDATA[<h2 id="-arxiv-논문"><i data-lucide="book-open"></i> arXiv 논문</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.26802v1/fig16_extraction.png" alt="Scaling Parameter-Efficient Fine-Tuning for Brain Encoding" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.26802" target="_blank">Scaling Parameter-Efficient Fine-Tuning for Brain Encoding</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="wrench"></i> 학습/최적화</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#LoRA</span> 
</div>

  <p>뇌 인코딩 모델은 자극에 대한 신경 반응을 예측하지만, 데이터 부족으로 대규모 모델을 처음부터 학습시키기는 어렵습니다. 이 연구는 PEFT(Parameter-Efficient Fine-Tuning) 기법을 활용하여 적은 수의 파라미터만으로 거대한 사전학습 모델을 뇌 인코딩 작업에 효과적으로 적용할 수 있음을 보여줍니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 234</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.26825v1/figure_efficiency.png" alt="MemT-1.0: Towards Memory-Native Evolution" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.26825" target="_blank">MemT-1.0: Towards Memory-Native Evolution</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#RAG</span> 
</div>

  <p>이 연구는 파운데이션 모델이 정보를 지속적으로 축적하고 활용할 수 있도록 메모리 기능을 내재화하는 새로운 아키텍처 ‘MemT-1.0’을 제안합니다. MemT-1.0은 안정적인 토큰 레벨 메모리 업데이트 메커니즘과 메모리 용량을 확장하는 기술을 통해 모델의 연산 과정에 메모리를 통합합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 146</span> 


</div>

</div>

<div class="digest-item">

  <h3><a href="https://arxiv.org/abs/2610.26549" target="_blank">Holi-World: Building Holistic World Intelligence from Human-Ego Experience</a></h3>

  <p>인간의 1인칭 시점 경험은 세상의 구조와 상호작용을 학습하는 데 중요한 기반을 제공합니다. 이 연구는 방대한 1인칭 시점 기록을 학습 자원으로 전환하는 통합 생태계 ‘HOLI-WORLD’를 소개하며, 이를 통해 수동 주석 작업 없이도 총체적인 세계 지능을 구축합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 110</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.25736v1/CEL.png" alt="Learning from Fleet Experience: A Collective Learning Paradigm for Robots" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.25736" target="_blank">Learning from Fleet Experience: A Collective Learning Paradigm for Robots</a></h3>

  <p>로봇이 실제 환경에서 얻는 경험은 정책 신뢰도를 높이는 기회이지만, 로봇 수가 늘어날수록 인간이 개입하여 학습시키기는 어렵습니다. 이 연구는 여러 로봇이 각자의 실행 경험을 공유하여 공통의 정책을 함께 개선하는 ‘집단 경험 학습(CEL)’이라는 새로운 패러다임을 제안합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 107</span> 


</div>

</div>

<div class="digest-item">

  <h3><a href="https://arxiv.org/abs/2610.26824" target="_blank">SpecMRL: Redesign Matryoshka Representation Learning within Parametric Spectrum</a></h3>

  <p>유연한 크기의 표현을 지원하는 MRL(Matryoshka Representation Learning)은 표현의 앞부분이 압축적인 인코딩 역할을 제대로 수행한다는 보장이 없다는 한계가 있습니다. 이 연구는 특징 공간을 재구성하여 특징의 중요도에 따라 정렬하는 SpecMRL을 제안함으로써, MRL의 앞부분 표현이 더 효과적인 압축 인코딩이 되도록 개선합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 81</span> 


</div>

</div>

<hr />

<h2 id="-hugging-face-blog"><i data-lucide="cpu"></i> Hugging Face Blog</h2>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.26860" target="_blank">OpenVLHarness: Real World Visual Agentic Tool-Use with Multimodal Memory</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Eval</span> 
</div>

  <p>멀티모달 대규모 언어 모델(MLLM)은 시각적 추론 능력이 뛰어나지만, 내부 추론만으로는 해결하기 어려운 현실 세계의 복잡한 문제들이 많습니다. OpenVLHarness는 다양한 외부 도구를 활용하여 현실 세계의 정보를 인식하고 측정하며, 그 결과를 모델이 이해하고 기억할 수 있도록 만들어 문제 해결 능력을 극대화하는 프레임워크입니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Yu Zhou, Cheng-Fu Yang, Rui Sun</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.26853" target="_blank">InfiniDream: Open-Ended Photorealistic 3D Worlds Through Procedural Generation</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="wrench"></i> 학습/최적화</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Synthetic Data</span> 
</div>

  <p>절차적 생성 기술은 게임 개발이나 합성 데이터 제작에 필수적이지만, 기존의 VLM 기반 방식은 결과물이 단순하거나 수작업이 많이 필요하다는 한계가 있었습니다. InfiniDream은 이러한 제약을 넘어, 정해진 API에 얽매이지 않고 개방적인 방식으로 사실적인 3D 세계를 무한히 생성하는 새로운 접근법을 제시합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Yi-Chuan Huang, Hao-Jen Chien, Zheng-Hui Huang</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.26863" target="_blank">Text-to-Image Generative Modeling Without Language Pretraining</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <p>최신 텍스트-이미지 생성 모델들은 대부분 대규모 언어 데이터 사전학습에 의존하지만, 이 연구는 과연 이러한 과정이 필수적인지에 대한 질문을 던집니다. 연구팀이 제안한 Halcyon 모델은 언어 사전학습 없이 이미지-텍스트 쌍 데이터만으로 처음부터 학습했음에도 불구하고, 훨씬 적은 컴퓨팅 자원으로 기존의 강력한 모델들을 능가하는 성능을 보여주었습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Keshigeyan Chandrasegaran, Yue Zhao, Armin W. Thomas</span>
</div>

</div>

<hr />

<h2 id="-github-trending"><i data-lucide="star"></i> GitHub Trending</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/MadsLorentzen/ai-job-search/master/assets/mascot/pip_flight_loop.gif" alt="MadsLorentzen/ai-job-search" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/MadsLorentzen/ai-job-search" target="_blank">MadsLorentzen/ai-job-search</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#AI Coding</span> <span class="sub-tag">#Eval</span> 
</div>

  <p>이 프로젝트는 사용자의 컴퓨터에서 직접 실행되는 AI 기반 구직 자동화 프레임워크입니다. Claude AI를 활용하여 채용 공고 분석, 이력서 맞춤 제작, 자기소개서 작성부터 면접 준비까지 구직의 전 과정을 효율적으로 돕습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 3861 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/stablyai/orca/main/resources/build/icon.png" alt="stablyai/orca" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/stablyai/orca" target="_blank">stablyai/orca</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Coding Agent</span> <span class="sub-tag">#AI Coding</span> 
</div>

  <p>Orca는 Grok, Claude와 같은 여러 AI 코딩 에이전트를 한곳에서 통합 관리하고 활용할 수 있는 플랫폼입니다. 사용자는 자신의 구독 계정을 연동하여 원하는 에이전트를 실행할 수 있으며, 데스크톱, 모바일, 원격 환경 등 다양한 기기에서 접근할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1565 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/DietrichGebert/ponytail/main/assets/logo.png" alt="DietrichGebert/ponytail" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/DietrichGebert/ponytail" target="_blank">DietrichGebert/ponytail</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>Ponytail은 AI 에이전트가 마치 ‘게으른 시니어 개발자’처럼 생각하도록 만드는 독특한 프로젝트입니다. ‘가장 좋은 코드는 작성하지 않은 코드’라는 철학을 바탕으로, 불필요한 작업을 피하고 가장 효율적이고 간단한 해결책을 찾도록 유도합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1208 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/Comfy-Org/ComfyUI" alt="Comfy-Org/ComfyUI" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/Comfy-Org/ComfyUI" target="_blank">Comfy-Org/ComfyUI</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <p>ComfyUI는 그래프와 노드 기반 인터페이스를 특징으로 하는 강력하고 모듈화된 디퓨전 모델 GUI입니다. 이를 통해 사용자는 복잡한 이미지 생성 워크플로우를 시각적으로 자유롭게 구성할 수 있으며, 세계 최고 수준의 빠른 로컬 추론 속도를 제공합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1206 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/ruvnet/ruflo/main/docs/assets/ruflo-explained/ch14.jpg" alt="ruvnet/ruflo" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/ruvnet/ruflo" target="_blank">ruvnet/ruflo</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#RAG</span> <span class="sub-tag">#AI Coding</span> 
</div>

  <p>Ruflo는 다수의 지능형 AI 에이전트 그룹을 배포하고 자율적인 워크플로우를 조정하기 위한 에이전트 프레임워크입니다. 적응형 메모리, 자가 학습, 벡터 RAG 통합과 같은 고급 기능을 통해 복잡한 대화형 AI 시스템을 효과적으로 구축할 수 있도록 지원합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 684 today</span> 

</div>

</div>

<hr />

<h2 id="-오늘의-키워드"><i data-lucide="bar-chart-3"></i> 오늘의 키워드</h2>

<div class="keywords">
<code>Fine-tuning</code> <code>RAG</code> <code>LLM</code> <code>Inference</code> <code>Agent</code> <code>Benchmark</code> <code>Synthetic Data</code> <code>Llama</code> <code>Claude</code> <code>Claude Code</code> 
</div>]]></content><author><name>joyuno</name></author><category term="AI" /><category term="Tech" /><category term="AI" /><category term="LLM" /><category term="트렌드" /><category term="기술블로그" /><summary type="html"><![CDATA[arXiv 논문]]></summary></entry><entry><title type="html">ai-memory — 코딩 에이전트를 위한 장기 기억 솔루션</title><link href="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/20/ai-tech-digest.html" rel="alternate" type="text/html" title="ai-memory — 코딩 에이전트를 위한 장기 기억 솔루션" /><published>2026-10-20T00:00:00+09:00</published><updated>2026-10-20T00:00:00+09:00</updated><id>https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/20/ai-tech-digest</id><content type="html" xml:base="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/20/ai-tech-digest.html"><![CDATA[<h2 id="-arxiv-논문"><i data-lucide="book-open"></i> arXiv 논문</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.21783v1/fig_trace_v2_slide1.png" alt="Learning to Think and Explore in 3D World" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.21783" target="_blank">Learning to Think and Explore in 3D World</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#VLM</span> 
</div>

  <p>이 연구는 비전-언어 모델(VLM)이 3D 공간을 능동적으로 탐색하고 이해하는 방법을 제안합니다. 모델은 복잡한 3D 데이터를 한 번에 받는 대신, 인간처럼 한 번에 하나의 이미지만을 보고 행동과 관찰을 반복하며 환경과 상호작용하는 방식으로 학습합니다. 이 과정을 통해 모델은 1인칭 시점에서 시작하여 점차 3D 세계에 대한 사고 능력을 기르게 됩니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 144</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.09872v1/compact_capability_results.png" alt="LiveMACE: Process-Aware Evaluation of LLM Agent Capabilities in Evolving Markets" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.09872" target="_blank">LiveMACE: Process-Aware Evaluation of LLM Agent Capabilities in Evolving Markets</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Tool Use</span> <span class="sub-tag">#Eval</span> 
</div>

  <p>이 연구는 LLM 에이전트의 능력을 평가할 때 최종 결과만으로는 그 역량을 제대로 파악하기 어렵다는 문제를 지적합니다. 특히 금융 시장처럼 끊임없이 변화하는 환경에서는 에이전트의 행동과 외부 조건의 상호작용을 함께 분석해야 하므로, 실제 금융 시장을 테스트베드로 삼는 프로세스 중심 벤치마크 ‘LiveMACEBench’를 제안합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 111</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.20951v1/fig_unlabelled.png" alt="LEV: Thinking Fast and Deep with Looped Decision Models" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.20951" target="_blank">LEV: Thinking Fast and Deep with Looped Decision Models</a></h3>

  <p>이 연구는 빠르면서도 깊이 있는 사고가 가능한 새로운 의사결정 모델 ‘LEV’를 소개합니다. LEV는 텍스트를 생성하는 대신 내부 레이어를 반복 실행하는 ‘루프’ 구조를 통해, 쉬운 질문은 빠르게 처리하고 어려운 질문에는 더 많은 연산을 투입하여 깊이 있게 사고할 수 있습니다. 이를 통해 기존 모델들의 속도와 깊이 한계를 동시에 극복하고자 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 80</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.23121v1/fig4.png" alt="Scene-Designer: Learning Design Intelligence for Agentic 3D Scene Generation" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.23121" target="_blank">Scene-Designer: Learning Design Intelligence for Agentic 3D Scene Generation</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>이 연구는 자연어 지시만으로 완성도 높은 3D 실내 장면을 생성하는 에이전트 프레임워크 ‘Scene-Designer’를 소개합니다. 이 프레임워크는 직접 장면을 디자인하고 그 품질을 비평하는 두 가지 경험을 통해, 기존 모델에 부족했던 전문적인 ‘디자인 지능’을 학습합니다. 이를 통해 단순히 객체를 배치하는 것을 넘어, 일관되고 실용적인 고품질 3D 공간을 창조하는 능력을 기릅니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 49</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.14157v1/exp-main-bars.png" alt="OpenMobile-2: Building Versatile Mobile Agents with Scalable Environments and App-Native Tools" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.14157" target="_blank">OpenMobile-2: Building Versatile Mobile Agents with Scalable Environments and App-Native Tools</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>이 연구는 학습 환경과 방법을 완전히 공개한 새로운 모바일 에이전트 ‘OpenMobile-2’를 제안합니다. 실제 상용 앱처럼 작동하는 35개의 시뮬레이션 앱을 포함한 ‘MobileGym++’ 환경을 구축하여, 110개가 넘는 앱을 넘나드는 복잡한 작업을 학습할 수 있는 확장 가능한 테스트베드를 제공합니다. 이를 통해 누구나 더 현실적이고 다재다능한 모바일 에이전트를 개발할 수 있는 기반을 마련했습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 39</span> 


</div>

</div>

<hr />

<h2 id="-hugging-face-blog"><i data-lucide="cpu"></i> Hugging Face Blog</h2>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.24937" target="_blank">MLFont: Machine Learning-Driven Font Subsetting and Range-Compact Unicode-Range Slicing for Low-Latency Web Typography</a></h3>

  <p>MLFont는 머신러닝을 활용하여 대용량 웹폰트를 효율적으로 분할하는 새로운 프레임워크입니다. 이 기술은 실제 사용 패턴을 학습하여 불필요한 글리프 다운로드를 최소화하고, 이를 통해 동아시아 언어권 웹사이트의 로딩 속도를 획기적으로 개선합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Quan Wang, Yiran Mao</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.23734" target="_blank">Bridging the Language Gap in Scholarly Data II: Enhancing Gender Inference for Chinese Names</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <p>기존의 이름 기반 성별 추론 기술은 중국어 이름에서 정확도가 떨어지는 한계가 있었습니다. 이 연구는 로마자 표기(Pinyin)와 실제 한자(Hanzi) 사이의 모호성을 해결하여, 학술 데이터에 기록된 중국인 연구자의 성별을 더 정확하게 추론하는 방법을 제시합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Lisette Espín-Noboa, Mingrong She, Ana Maria Jaramillo</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.23695" target="_blank">Recursive Operator Localization and Spectral Gap Descent via the Geometry of Local Spectral Expansion</a></h3>

  <p>본 연구는 양자 시스템 등의 복잡한 스펙트럼 갭 문제를 해결하기 위해 재귀적 연산자 지역화(ROL)라는 새로운 프레임워크를 소개합니다. 이 프레임워크는 지역적 에너지 문제들의 계층 구조를 구축하고 기하학적 추정을 활용하여, 국소적인 스펙트럼 갭 정보로부터 시스템 전체의 스펙트럼 갭을 효과적으로 유도합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Ryu Hayakawa</span>
</div>

</div>

<hr />

<h2 id="-토스-기술블로그"><i data-lucide="credit-card"></i> 토스 기술블로그</h2>

<div class="digest-item">

  <h3><a href="https://toss.tech/article/nic-interrupt-bottleneck" target="_blank">평균 CPU는 여유로운데, 커밋은 왜 느릴까?</a></h3>

  <p>전체 CPU 사용률은 여유롭지만 특정 작업의 속도가 느리다면, 눈에 보이지 않는 병목이 존재할 수 있습니다. 이 글은 커밋 속도 저하의 원인이 특정 CPU 코어에 집중된 NIC(네트워크 인터페이스 카드) 인터럽트 처리 부담 때문임을 밝혀내고, 이를 분산 처리하여 해결한 과정을 다룹니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> 토스</span>
</div>

</div>

<hr />

<h2 id="-무신사-기술블로그"><i data-lucide="shirt"></i> 무신사 기술블로그</h2>

<div class="digest-item">

  <h3><a href="https://techblog.musinsa.com/%EB%B9%A0%EB%A5%B8-%EA%B8%B0%EA%B8%B0%EA%B0%80-%EC%99%9C-%EA%B8%B0%EB%8B%A4%EB%A0%A4%EC%95%BC-%ED%95%98%EC%A7%80-a0533ee53dd2?source=rss----f107b03c406e---4" target="_blank">빠른 기기가 왜 기다려야 하지?</a></h3>

  <p>무신사 자동화 QE팀은 기존 테스트 프레임워크 운영 시, 테스트를 먼저 끝낸 기기가 가장 느린 기기를 기다려야 하는 비효율을 발견했습니다. 또한, 테스트 기기를 추가할 때마다 전용 스크립트를 수동으로 작성해야 하는 번거로움과 잦은 설정 오류 문제로 인해 새로운 프레임워크로의 전환을 결정하게 되었습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> 정다정</span>
</div>

</div>

<hr />

<h2 id="-github-trending"><i data-lucide="star"></i> GitHub Trending</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/MadsLorentzen/ai-job-search/master/assets/mascot/pip_flight_loop.gif" alt="MadsLorentzen/ai-job-search" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/MadsLorentzen/ai-job-search" target="_blank">MadsLorentzen/ai-job-search</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#AI Coding</span> <span class="sub-tag">#Eval</span> 
</div>

  <p>이 프로젝트는 사용자의 컴퓨터에서 직접 실행되는 AI 기반 구직 프레임워크입니다. Claude Code를 기반으로 채용 공고를 분석하고 이력서를 맞춤 제작하며, 자기소개서 작성과 면접 준비까지 자동화해줍니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 3856 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/akitaonrails/ai-memory/main/docs/logo-light.png" alt="akitaonrails/ai-memory" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/akitaonrails/ai-memory" target="_blank">akitaonrails/ai-memory</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>AI 코딩 에이전트가 장기적인 맥락을 기억하도록 돕는 메모리 솔루션입니다. 이를 통해 여러 에이전트 간에 작업을 중단 없이 원활하게 전달하고 협업할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 666 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/Comfy-Org/ComfyUI" alt="Comfy-Org/ComfyUI" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/Comfy-Org/ComfyUI" target="_blank">Comfy-Org/ComfyUI</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> 
</div>

  <p>ComfyUI는 그래프와 노드 인터페이스를 사용하는 가장 강력하고 모듈화된 확산 모델(diffusion model) GUI입니다. 세계에서 가장 빠른 로컬 추론 엔진을 표방하며, 강력한 API와 백엔드를 통해 뛰어난 성능을 제공합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1011 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/ruvnet/ruflo/main/docs/assets/ruflo-explained/ch14.jpg" alt="ruvnet/ruflo" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/ruvnet/ruflo" target="_blank">ruvnet/ruflo</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#RAG</span> <span class="sub-tag">#AI Coding</span> 
</div>

  <p>ruflo는 여러 AI 에이전트가 협력하는 ‘스웜(swarm)’을 배포하고 자율적인 워크플로우를 구축하기 위한 프레임워크입니다. 적응형 메모리, RAG 통합과 같은 기능을 활용하여 정교한 대화형 AI 시스템을 만들 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 564 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/stablyai/orca/main/resources/build/icon.png" alt="stablyai/orca" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/stablyai/orca" target="_blank">stablyai/orca</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Coding Agent</span> <span class="sub-tag">#AI Coding</span> 
</div>

  <p>Orca는 Grok Bot이나 Claude Code와 같은 여러 코딩 에이전트들을 한곳에서 관리하고 작업할 수 있는 플랫폼입니다. 사용자는 자신의 구독 계정으로 원하는 에이전트를 데스크톱, 모바일 등 다양한 환경에서 실행할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1590 today</span> 

</div>

</div>

<hr />

<h2 id="-ai-weekly"><i data-lucide="newspaper"></i> AI Weekly</h2>

<div class="digest-item">

  <h3><a href="https://aiweekly.co/issues/ai-is-finding-software-flaws-faster-than-teams-can-fix-them" target="_blank">AI Weekly Issue #540: AI is finding software flaws faster than teams can fix them</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>최근 기업들의 AI 활용 사례를 분석한 결과, AI가 기록적인 속도로 보안 취약점을 발견하여 인간 팀이 해결하는 속도를 앞지르고 있습니다. 또한 일부 기업에서는 AI 에이전트가 상당한 업무를 처리하고 있으며, 테스트용 에이전트가 예상치 못한 독자적인 행동을 보이는 사례도 나타나고 있습니다.</p>

  <div class="item-meta">


</div>

</div>

<hr />

<h2 id="-오늘의-키워드"><i data-lucide="bar-chart-3"></i> 오늘의 키워드</h2>

<div class="keywords">
<code>Vision</code> <code>LLM</code> <code>Tool Use</code> <code>Agent</code> <code>Eval</code> <code>Inference</code> <code>Claude</code> <code>Claude Code</code> <code>RAG</code> <code>AI Agent</code> 
</div>]]></content><author><name>joyuno</name></author><category term="AI" /><category term="Tech" /><category term="AI" /><category term="LLM" /><category term="트렌드" /><category term="기술블로그" /><summary type="html"><![CDATA[arXiv 논문]]></summary></entry><entry><title type="html">ruflo — 지능형 멀티플레이어 스웜을 위한 에이전트 하네스</title><link href="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/19/ai-tech-digest.html" rel="alternate" type="text/html" title="ruflo — 지능형 멀티플레이어 스웜을 위한 에이전트 하네스" /><published>2026-10-19T00:00:00+09:00</published><updated>2026-10-19T00:00:00+09:00</updated><id>https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/19/ai-tech-digest</id><content type="html" xml:base="https://joyuno.github.io/ai-tech-digest/ai/tech/2026/10/19/ai-tech-digest.html"><![CDATA[<h2 id="-arxiv-논문"><i data-lucide="book-open"></i> arXiv 논문</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.21601v1/evaluation_accuracy_1x3.png" alt="Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.21601" target="_blank">Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="wrench"></i> 학습/최적화</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#DPO</span> <span class="sub-tag">#Distillation</span> 
</div>

  <p>강화학습에서 교사 모델의 학습 전후 정책 차이만을 증류하는 기존 방식은 학습 과정의 일관성을 반영하지 못하는 한계가 있습니다. 본 연구는 학습 초기와 후기 정책 변화의 일치도를 분석하여, 더 안정적이고 의미 있는 변화만을 선별적으로 학생 모델에 전달하는 Waypoint-OPD 기법을 제안합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 668</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.22276v1/jev_spatial_task_inference.png" alt="MJev-Spatial: System One Spatial Intelligence via Native Attention Matching" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.22276" target="_blank">MJev-Spatial: System One Spatial Intelligence via Native Attention Matching</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Transformer</span> <span class="sub-tag">#VLM</span> 
</div>

  <p>기존 시각-언어 모델은 간단한 공간 지능 질문에 답하기 위해 비효율적인 텍스트 생성 방식을 사용합니다. 이를 해결하고자 본 연구는 텍스트 생성 없이 어텐션 매칭을 통해 직접적으로 좌표나 스칼라 값 등을 출력하는 고속 멀티모달 모델 MJev-Spatial을 제안하여, 상호작용 속도로 공간적 판단을 내릴 수 있게 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 354</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.22200v1/OpenGCUA_osw2_v10_C_reasoning_compact_same_order.png" alt="OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.22200" target="_blank">OpenGCUA: Toward a Fully Open Stack for Generalist Computer Use</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#GUI Agent</span> 
</div>

  <p>최근 GUI와 프로그래밍 인터페이스를 넘나들며 컴퓨터 작업을 수행하는 범용 에이전트(GCUA)가 주목받고 있으나, 핵심 기술은 대부분 비공개되어 연구에 한계가 있었습니다. 본 연구는 이러한 에이전트의 관찰, 행동, 작업 구성 방식을 체계적으로 연구할 수 있도록 완전한 오픈소스 스택인 OpenGCUA를 제안합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 316</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.22350v1/fig4.png" alt="FDE-Gym: The Last Mile of AI Delivery" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.22350" target="_blank">FDE-Gym: The Last Mile of AI Delivery</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Eval</span> 
</div>

  <p>기존 AI 에이전트 벤치마크는 명확히 정의된 작업만을 평가하여 실제 문제 해결 능력을 측정하기 어렵습니다. FDE-Gym은 실제 고객 시나리오를 바탕으로 모호한 요구사항 명확화, 숨겨진 제약 발견 등 현실적인 과제를 포함한 벤치마크로, AI의 실질적인 배포 및 문제 해결 능력을 평가합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 285</span> 


</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://arxiv.org/html/2610.18813v1/fig01_cover.png" alt="Self-Evolving Agent Harness" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://arxiv.org/abs/2610.18813" target="_blank">Self-Evolving Agent Harness</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Self-Evolving</span> 
</div>

  <p>본 연구는 AI 모델의 가중치를 고정한 채, 에이전트의 프롬프트, 메모리, 워크플로우 등 주변 소프트웨어 구성요소를 스스로 개선하는 ‘자가 진화 하네스’ 프레임워크를 제안합니다. 이 시스템은 피드백 기반으로 개선안을 채택하고 누적시켜, 에이전트가 실행을 거듭하며 스스로의 성능을 지속적으로 발전시킬 수 있도록 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-hf"><i data-lucide="thumbs-up"></i> 202</span> 


</div>

</div>

<hr />

<h2 id="-hugging-face-blog"><i data-lucide="cpu"></i> Hugging Face Blog</h2>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.21439" target="_blank">Each Reward to Its Relevant Tokens: Reward-Specific Token-Level Credit Assignment for Multi-Reward RL</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="wrench"></i> 학습/최적화</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#DPO</span> <span class="sub-tag">#RLVR</span> 
</div>

  <p>언어 모델을 여러 보상 기준으로 학습시킬 때 기존 방식은 각 보상의 영향을 전체 응답에 고르게 분산시키는 한계가 있었습니다. 이 논문은 MRTPO라는 새로운 기법을 제안하여, 특정 보상이 관련된 토큰에만 정확하게 할당되도록 함으로써 다중 보상 강화학습의 효율과 정확도를 높입니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Skylar Zhai, Haonan Wang, Zhining Liu</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.22371" target="_blank">Gen4P: Video Generators are 4D Perceivers</a></h3>

  <p>Gen4P는 사전 학습된 비디오 생성 모델을 4D 인식기로 재활용하여 단일 비디오에서 4차원 기하학과 움직임을 복원하는 새로운 프레임워크입니다. 이 기술은 반복적인 노이즈 제거 과정 없이 비디오 잠재 공간을 한 번에 처리하고, 가벼운 디코더를 통해 4D 속성을 예측함으로써 효율적이고 유연한 시공간 분석을 가능하게 합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Yitong Xia, Zeren Jiang, Chuanxia Zheng</span>
</div>

</div>

<div class="digest-item">

  <h3><a href="https://huggingface.co/papers/2610.21333" target="_blank">QuasiLeak-Bench: Evaluating LLM-Based Privacy Detectors on Policy-Conditioned Quasi-Evidence Group Recovery</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Eval</span> 
</div>

  <p>기존 개인정보 보호 벤치마크는 명백한 식별자 탐지에 초점을 맞추지만, 여러 정보가 결합되어 개인정보를 유추하게 만드는 ‘준-증거 그룹’은 측정하지 못하는 한계가 있습니다. 이러한 문제를 해결하기 위해 이 논문은 여러 단서의 조합으로 인한 개인정보 유출 위험을 LLM이 얼마나 잘 탐지하는지 평가하는 새로운 벤치마크인 ‘QuasiLeak-Bench’를 제안합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-author"><i data-lucide="user"></i> Yufan Zhu, Yangfan Jiang, Yang Fei</span>
</div>

</div>

<hr />

<h2 id="-github-trending"><i data-lucide="star"></i> GitHub Trending</h2>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/MadsLorentzen/ai-job-search/master/assets/mascot/pip_flight_loop.gif" alt="MadsLorentzen/ai-job-search" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/MadsLorentzen/ai-job-search" target="_blank">MadsLorentzen/ai-job-search</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#AI Coding</span> <span class="sub-tag">#Eval</span> 
</div>

  <p>이 프로젝트는 사용자의 컴퓨터에서 직접 실행되는 AI 기반 구직 프레임워크입니다. Claude Code를 활용하여 채용 공고 분석, 이력서 맞춤 제작, 자기소개서 작성, 면접 준비까지 구직의 전 과정을 자동화합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 2232 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://opengraph.githubassets.com/auto/anthropics/claude-plugins-official" alt="anthropics/claude-plugins-official" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/anthropics/claude-plugins-official" target="_blank">anthropics/claude-plugins-official</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#AI Coding</span> 
</div>

  <p>이 저장소는 Claude 개발사인 Anthropic이 직접 관리하는 공식 Claude Code 플러그인 디렉토리입니다. 사용자는 이곳에서 Claude의 기능을 확장할 수 있는 고품질의 검증된 플러그인들을 찾아볼 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1175 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/ruvnet/ruflo/main/docs/assets/ruflo-explained/ch14.jpg" alt="ruvnet/ruflo" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/ruvnet/ruflo" target="_blank">ruvnet/ruflo</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="search"></i> 추론/검색</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#RAG</span> <span class="sub-tag">#AI Coding</span> 
</div>

  <p>Ruflo는 여러 AI 에이전트를 동시에 배포하고 자율적인 워크플로우를 조정하기 위한 에이전트 하네스입니다. 적응형 메모리, RAG 연동, Claude Code 등 다양한 모델 통합 기능을 통해 복잡한 대화형 AI 시스템을 구축할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 513 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/akitaonrails/ai-memory/main/docs/logo-light.png" alt="akitaonrails/ai-memory" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/akitaonrails/ai-memory" target="_blank">akitaonrails/ai-memory</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> 
</div>

  <p>이 프로젝트는 AI 코딩 에이전트가 장기 기억을 가질 수 있도록 돕는 메모리 솔루션입니다. 이를 통해 여러 번의 상호작용에 걸쳐 맥락을 유지하고, 서로 다른 회사의 AI 에이전트 간에 작업을 원활하게 전달할 수 있습니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 512 today</span> 

</div>

</div>

<div class="digest-item has-thumb">

  <div class="digest-thumb">
  <img src="https://raw.githubusercontent.com/stablyai/orca/main/resources/build/icon.png" alt="stablyai/orca" loading="lazy" referrerpolicy="no-referrer" />
</div>

  <h3><a href="https://github.com/stablyai/orca" target="_blank">stablyai/orca</a></h3>

  <div class="categories">
<span class="category-tag"><i data-lucide="brain"></i> 모델/아키텍처</span> <span class="category-tag"><i data-lucide="bot"></i> 에이전트</span> <span class="category-tag"><i data-lucide="code-2"></i> 개발 도구</span> 
</div>

  <div class="sub-tags">
<span class="sub-tag">#Coding Agent</span> <span class="sub-tag">#AI Coding</span> 
</div>

  <p>Orca는 Grok Bot, Claude Code와 같은 여러 코딩 AI 에이전트들을 한곳에서 관리하고 실행할 수 있는 통합 플랫폼입니다. 사용자는 자신의 구독 계정을 연동하여 원하는 에이전트를 실행할 수 있으며, 데스크톱과 모바일 등 다양한 환경을 지원합니다.</p>

  <div class="item-meta">


<span class="meta-pill meta-stars"><i data-lucide="star"></i> 1146 today</span> 

</div>

</div>

<hr />

<h2 id="-오늘의-키워드"><i data-lucide="bar-chart-3"></i> 오늘의 키워드</h2>

<div class="keywords">
<code>Vision</code> <code>DPO</code> <code>Multimodal</code> <code>Agent</code> <code>GPT</code> <code>Eval</code> <code>Prompt</code> <code>LLM</code> <code>Inference</code> <code>Claude</code> 
</div>]]></content><author><name>joyuno</name></author><category term="AI" /><category term="Tech" /><category term="AI" /><category term="LLM" /><category term="트렌드" /><category term="기술블로그" /><summary type="html"><![CDATA[arXiv 논문]]></summary></entry></feed>